목차
수집 범위: 2026년 9월 10일 09:00부터 9월 11일 09:00까지 KST 기준으로 공개된 자료를 확인했습니다. 최근 7일 BlogFlow 브리핑의 제목, 주요 키워드, 원문 URL과 겹치는 발표는 제외했습니다.
주요 AI 소식
Agents API 공개 베타 출시
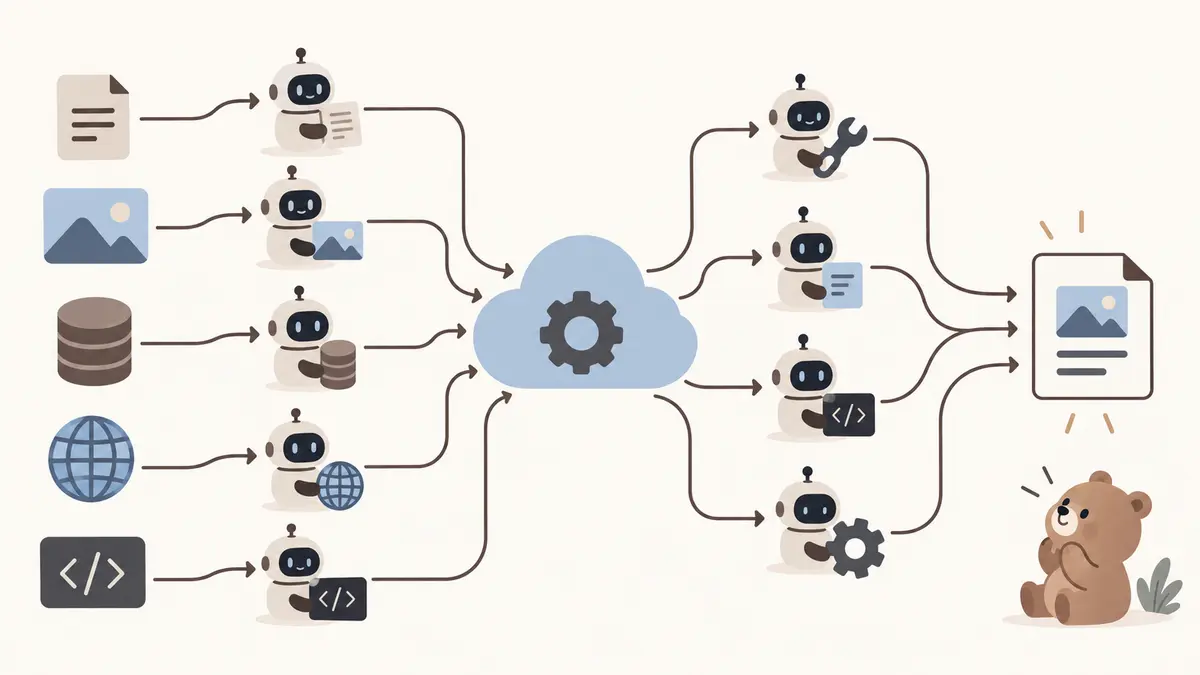
발표 내용: OpenAI는 2026년 9월 10일 Codex에 쓰이는 에이전트 실행 구조와 인프라를 개발자가 API로 이용할 수 있는 Agents API를 공개 베타로 출시했습니다. 하나의 API 요청에 작업, 모델, 도구, 실행 환경을 지정해 클라우드 에이전트를 만들고 실행할 수 있습니다.
달라진 점: 장시간 작업을 위한 문맥 압축, 필요한 도구 정의만 불러오는 도구 검색, 여러 호출을 묶어 처리하는 프로그래밍 방식의 도구 호출, 하위 에이전트 병렬 실행을 관리형 기능으로 제공합니다. 실행 환경은 OpenAI 관리 샌드박스, 자체 인프라, 지원되는 외부 샌드박스 가운데 선택할 수 있습니다.
개발자 영향: 파일 처리, 코드 실행, 도구 연결, 중간 결과 보존이 필요한 에이전트 서비스를 만들 때 직접 구현해야 했던 실행·복구·문맥 관리 범위가 줄어듭니다. 다만 공개 베타이므로 운영 도입 전 세션 복구, 권한 경계, 도구 실패, 비용 상한을 실제 워크로드로 점검해야 합니다. Agents API 자체의 추가 이용료는 없고 사용한 모델 토큰과 도구 비용이 청구됩니다.
공식 출처: OpenAI — Introducing the Agents API
GPT‑Live‑1 API 출시
발표 내용: OpenAI는 같은 날 듣기와 말하기를 동시에 처리하는 전이중 방식의 음성 모델 GPT‑Live‑1을 API로 공개했습니다. 음성 대화를 직접 처리하면서 복잡한 추론과 도구 호출은 GPT‑6 Astra 같은 백엔드 텍스트 모델이나 외부 모델에 위임할 수 있습니다.
달라진 점: 음성 인식, 언어 모델, 음성 합성을 순서대로 잇는 기존 구조보다 끼어들기와 짧은 맞장구, 침묵, 배경 소음을 한 모델이 함께 판단합니다. OpenAI 평가에서는 GPT‑Realtime‑2.1보다 Full Duplex Bench 성능이 30%포인트 높았고, Speak의 초기 평가에서는 생각하는 동안 발생한 대화 중단이 기존 턴 방식보다 약 80% 줄었습니다.
개발자 영향: 전화 상담, 예약, 교육처럼 사용자가 응답 도중 말을 바꾸거나 끼어드는 서비스의 음성 계층을 단순화할 수 있습니다. 프런트엔드 음성 계층 가격은 분당 0.05달러이며, 백엔드 모델과 도구 사용 비용은 별도이므로 전체 호출 시간과 위임 횟수를 함께 측정해야 합니다.
공식 출처: OpenAI — Build more natural voice experiences with GPT‑Live‑1 in the API
Anthropic, 2026년 9월 AI 오용 대응 보고서 공개
발표 내용: Anthropic은 2025년 12월부터 2026년 8월까지 탐지하고 차단한 Claude 악용 사례를 정리한 위협 인텔리전스 보고서를 공개했습니다. 사이버 작전, 영향력 작전, 감시, 사기, 생물학적 오용, 재래식 무기 개발, 불법 증류 등 7개 영역을 다룹니다.
달라진 점: 보고서는 공격자가 단순 질의응답을 넘어 AI를 정찰, 실행, 데이터 처리의 직접 수행자나 여러 작업을 조정하는 도구로 사용했다고 설명합니다. 공개된 사례는 Claude Haiku·Sonnet·Opus 계열에서 확인됐으며, 불법 증류 사례 1건을 제외하면 Claude Fable 또는 Mythos 계열이 사용된 사례는 없었다고 밝혔습니다.
개발자 영향: 에이전트에 네트워크와 파일, 인증 도구를 연결하는 팀은 모델 거부 규칙만으로 안전을 맡기기 어렵습니다. 최소 권한, 승인 단계, 비밀정보 분리, 호출 로그, 이상 행동 감지, 즉시 중단과 복구 절차를 애플리케이션 계층에 함께 설계해야 합니다. Anthropic은 확인한 활동을 차단하고 관련 정보를 당국 및 업계 파트너와 공유했다고 설명했습니다.
공식 출처: Anthropic — Detecting and countering misuse of AI: September 2026
오늘의 관찰
오늘 발표를 함께 보면 AI 제품의 차별점이 단일 모델 응답 품질에서 실행 기반과 상호작용 방식, 통제 구조로 넓어지고 있습니다. 에이전트와 실시간 음성을 도입할 때는 성공률뿐 아니라 중단·재개, 비용, 권한, 감사 가능성을 같은 수준의 제품 요구사항으로 다루는 편이 안전합니다.
공식 출처와 확인 기준
- OpenAI Agents API 발표 — 발표일: 2026년 9월 10일 / 확인: 2026년 9월 11일 08:59 KST
- OpenAI GPT‑Live‑1 API 발표 — 발표일: 2026년 9월 10일 / 확인: 2026년 9월 11일 08:59 KST
- Anthropic 2026년 9월 위협 인텔리전스 보고서 — 확인: 2026년 9월 11일 08:59 KST
같이 읽으면 좋은 글
이 글이 도움이 되었나요?
새 글 받아보기
RSS 리더에서 BlogFlow의 새 글을 확인할 수 있습니다.