읽기 전에 알아두면 좋아요
아래 개념이 익숙하면 본문을 바로 읽으세요. 낯선 개념만 링크에서 복습하면 됩니다.
- 문자열 알고리즘 기초: 순회·문자 판별·대소문자 변환·숫자 추출문자열의 각 문자를 순서대로 읽고 위치를 확인하는 방법을 복습합니다. 현재 풀이: indexOf/find로 최초 등장 위치를 확인해 중복을 제거하고 순서를 보존합니다.
개념과 예제는 실행하지 않아도 읽을 수 있습니다. 내 컴퓨터·터미널에서 직접 실행하는 과정은 선택 실습입니다.
과정 위치와 선택 복습 안내
과정 위치: 문자열 기초 · 문제
과정 위치는 이 글이 속한 묶음입니다. 이 단계의 모든 개념을 먼저 읽을 필요는 없습니다. 위에 연결한 개념 중 낯선 내용만 복습하세요. 문제의 조건·상태·갱신 순서는 익숙한 언어로 설명하면 됩니다.
다른 풀이와 비용 비교 (선택)
- JavaScript Map·Set: 값 조회와 중복 제거 실습Map은 이름표인 키로 값을 찾고, Set은 같은 값을 한 번만 보관합니다. 다른 풀이: Set으로 중복을 관리하는 방법과 반복 검색의 비용을 비교합니다.
JavaScript로 문법·실행 복습하기 (선택)
개념 글의 코드는 JavaScript 예시입니다. 문제 화면에서는 JavaScript·Python·Java·C++·C# 중 익숙한 언어의 함수를 작성하세요. 본문의 Node.js 입출력 예시는 로컬 실행을 위한 별도 안내입니다.
중복단어제거 문제에서 결과 단어들의 순서는 무엇을 기준으로 유지하나요?
단어 목록에서 중복을 제외하고 처음 등장한 순서를 유지한 결과를 구하는 문제입니다. 배열·문자열·중복의 기본을 준비하고, 아래 입력·반환 계약을 확인해 직접 풀어보세요.
적용 조건·범위: 이번 대조는 원자료의 문제 조건과 예제 확인입니다. 이 글의 전체 코드를 새로 실행하거나 공식 채점에 제출한 결과를 뜻하지 않습니다. 아래 예제·자가 확인 항목은 직접 실행해 기대 출력과 비교하는 기준입니다.
공식 문서 참고: 관련 개념: MDN filter의 원소·인덱스 콜백 · 관련 개념: MDN 배열 indexOf의 첫 등장 위치
문제
자연수 N과 문자열 N개가 한 줄에 하나씩 주어집니다. 같은 문자열이 여러 번 나오면 처음 등장한 한 개만 남기고, 남은 문자열을 원래 입력 순서대로 한 줄씩 출력해야 합니다.
| 구분 | 내용 |
|---|---|
| 입력 | 첫 줄에 N, 다음 N줄에 문자열 |
| 제한 | 3 ≤ N ≤ 30, 각 문자열 길이 100 이하 |
| 출력 | 중복을 제거한 문자열을 최초 등장 순서대로 한 줄씩 출력 |
| 예제 | good, time, good, time, student → good, time, student |
직접 풀어보기
먼저 선택한 언어의 입력·반환 계약에 맞춰 작성해 보세요. 힌트 받기와 정답과 비교하기는 코드를 실행하지 않는 AI 분석입니다. 해답·해설은 아래에서 필요할 때 펼칠 수 있습니다.
AI 힌트
코드를 실행한 채점 결과가 아닌 AI의 코드 분석입니다.
해답·해설 보기
function solve(input) {
    const lines = input.split(/\r?\n/), n = Number(lines[0]), a = lines.slice(1, n + 1);
    return a.filter((x, i) => a.indexOf(x) === i).join('\n');
}
입력 예시 전체를 문자열로 전달하고 출력 문자열을 반환합니다. solve(input)를 호출합니다. 표준 입력·출력 코드는 추가하지 않습니다. 입력 공백과 LF/CRLF 줄바꿈을 처리합니다.
def solve(input):
    lines=input.replace('\r\n','\n').split('\n')
    a=lines[1:1+int(lines[0])]
    return '\n'.join(x for i,x in enumerate(a) if x not in a[:i])
입력 예시 전체를 문자열로 전달하고 출력 문자열을 반환합니다. solve(input)를 호출합니다. 표준 입력·출력 코드는 추가하지 않습니다. 입력 공백과 LF/CRLF 줄바꿈을 처리합니다.
import java.util.*;
class Solution {
    public String solve(String input) {
        String[] lines = input.split("\r?\n", - 1);
        int n = Integer.parseInt(lines[0]);
        List < String > out = new ArrayList < >();
        for (int i = 1; i <= n; i++) if (! out.contains(lines[i])) out.add(lines[i]);
        return String.join("\n", out);
    }
}
입력 예시 전체를 문자열로 전달하고 출력 문자열을 반환합니다. new Solution().solve(input)를 호출합니다. 표준 입력·출력 코드는 추가하지 않습니다. 입력 공백과 LF/CRLF 줄바꿈을 처리합니다.
#include <algorithm>
#include <sstream>
#include <string>
#include <vector>
std::string solve(const std::string & input) {
    std::istringstream in(input);
    std::string line, out;
    std::getline(in, line);
    int n = std::stoi(line);
    std::vector < std::string > seen;
    for (int i = 0; i < n; i++) {
        std::getline(in, line);
        if (! line.empty() && line.back() == '\r') line.pop_back();
        if (std::find(seen.begin(), seen.end(), line) == seen.end()) {
            if (! seen.empty()) out += "\n";
            seen.push_back(line);
            out += line;
        }
    }
    return out;
}
입력 예시 전체를 문자열로 전달하고 출력 문자열을 반환합니다. solve(input)를 호출합니다. 표준 입력·출력 코드는 추가하지 않습니다. 입력 공백과 LF/CRLF 줄바꿈을 처리합니다.
using System;
using System.Collections.Generic;
public class Solution {
    public string Solve(string input) {
        string[] lines = input.Replace("\r\n", "\n").Split('\n');
        int n = int.Parse(lines[0]);
        var outp = new List < string >();
        for (int i = 1; i <= n; i++) if (! outp.Contains(lines[i])) outp.Add(lines[i]);
        return string.Join("\n", outp);
    }
}
입력 예시 전체를 문자열로 전달하고 출력 문자열을 반환합니다. new Solution().Solve(input)를 호출합니다. 표준 입력·출력 코드는 추가하지 않습니다. 입력 공백과 LF/CRLF 줄바꿈을 처리합니다.
원자료와 확인 범위
2026-10-12에 제공된 학습 자료 섹션 1. 기본문제풀이.pdf의 17쪽 ‘중복단어제거’와 문제 조건·예제를 대조했습니다. 같은 ZIP의 해당 문제 TXT는 풀이 코드 자료입니다. 이 자료의 최초 출제 원문·저자·공개 배포 주소까지 확인한 것은 아닙니다.
이번 대조는 원자료의 문제 조건과 예제 확인입니다. 이 글의 전체 코드를 새로 실행하거나 공식 채점에 제출한 결과를 뜻하지 않습니다. 아래 예제·자가 확인 항목은 직접 실행해 기대 출력과 비교하는 기준입니다.
제공된 풀이의 주요 조건은 배열을 앞에서부터 순회하면서 현재 단어의 위치와 그 단어가 처음 나타난 위치를 비교하는 것입니다. 두 위치가 같을 때만 남기면 중복 단어는 제거되고 최초 등장 순서는 자연스럽게 유지됩니다.
알고리즘 설계
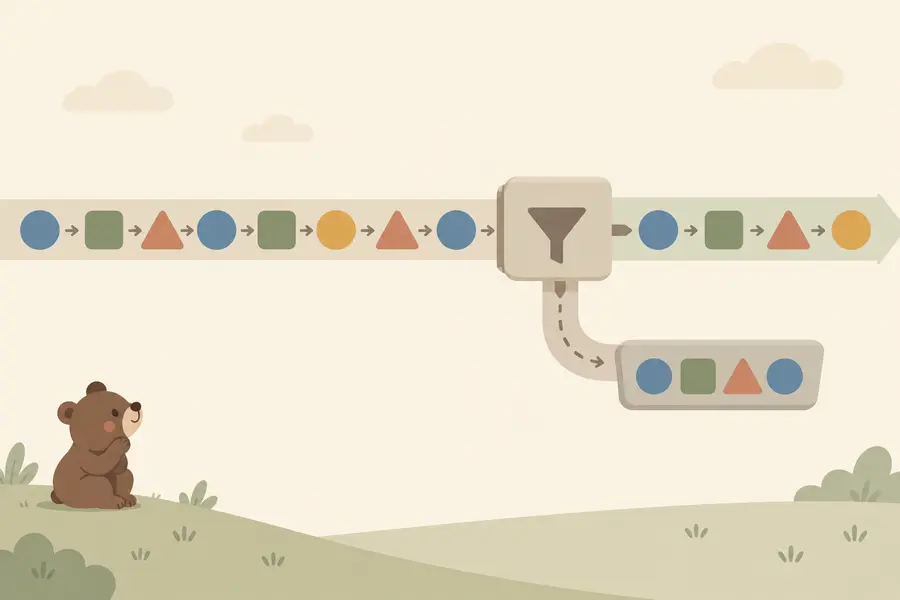
filter의 콜백은 현재 단어와 인덱스를 받습니다. words.indexOf(word)는 같은 단어가 배열에서 처음 등장한 인덱스를 반환합니다. 이 값이 현재 index와 같으면 첫 등장이므로 true를 반환하고, 다르면 앞에서 이미 나온 단어이므로 false를 반환합니다.
| 현재 단어 | 현재 위치 | 최초 위치 | 처리 |
|---|---|---|---|
good |
0 | 0 | 남김 |
time |
1 | 1 | 남김 |
good |
2 | 0 | 제거 |
time |
3 | 1 | 제거 |
student |
4 | 4 | 남김 |
배열의 filter 콜백과 indexOf가 처음 나온 위치를 반환한다는 점을 알고 시작합니다. Node.js가 있는 폴더에서 전체 코드를 solution.cjs로 저장하고 input.txt의 첫 줄에는 예제 단어 수 5, 다음 다섯 줄에는 good, time, good, time, student를 각각 적습니다. PowerShell 7의 Get-Content -Raw -Encoding UTF8 ./input.txt | node ./solution.cjs 또는 Bash·명령 프롬프트의 node solution.cjs < input.txt로 전달합니다. 쉼표는 설명상의 구분이며 입력 줄에 붙이지 않습니다. 기대 출력은 good, time, student가 각 한 줄인 결과이고 이번 편집에서는 재실행하지 않았습니다.
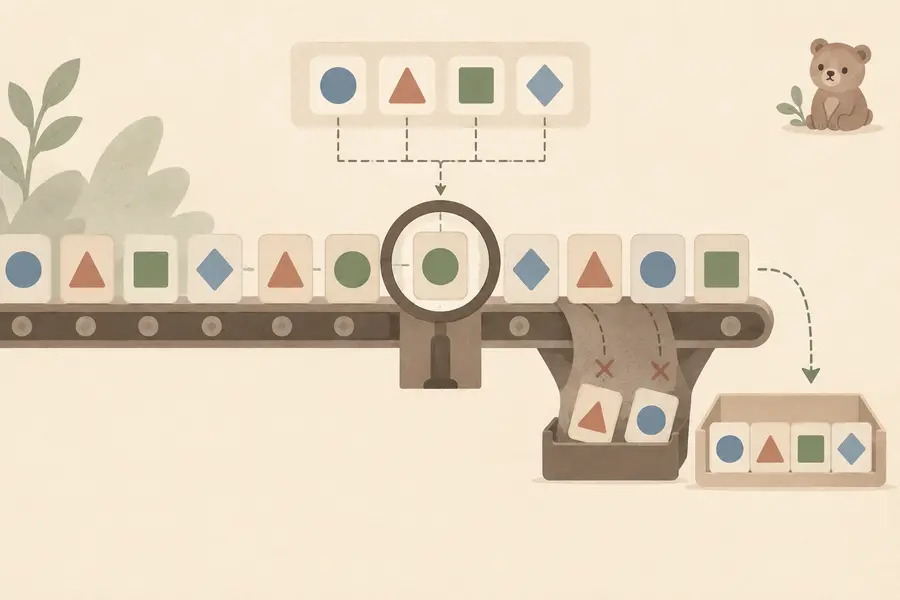
표준 입력 전체를 줄 단위로 나누고 첫 줄의 개수만큼만 단어 배열로 사용합니다. /\r?\n/ 정규식은 LF와 CRLF 줄바꿈을 모두 처리합니다. 전체 입력에 trim()을 사용하지 않아 문자열 앞뒤의 실제 공백을 함께 지우지 않으며, 마지막의 빈 줄은 slice(1, wordCount + 1) 범위 밖이므로 결과에 영향을 주지 않습니다.
const fs = require("fs");

const lines = fs.readFileSync(0, "utf8").split(/\r?\n/);
const wordCount = Number(lines[0]);
const words = lines.slice(1, wordCount + 1);

const uniqueWords = words.filter((word, index) => {
  return words.indexOf(word) === index;
});

console.log(uniqueWords.join("\n"));
복잡도와 검증
filter가 N번 실행되고 각 단계의 indexOf가 앞에서부터 최대 N개 단어를 비교하므로 시간 복잡도는 O(N²)입니다. 문자열 비교 비용까지 나타내면 최대 문자열 길이를 L이라고 할 때 O(N²L)입니다. 입력 배열과 결과 배열은 합쳐서 O(NL) 공간을 사용하며, 중복 제거 로직의 결과 배열을 제외한 추가 변수는 O(1)입니다.
| 검증 | 입력 특징 | 기대 출력 |
|---|---|---|
| 원문 예제 | 일부 단어 반복 | good, time, student |
| 중복 없음 | red, blue, green |
세 단어 모두 유지 |
| 모두 같음 | same, same, same |
same |
| 첫·끝 중복 | a, b, c, a |
a, b, c |
같은 원리를 문자 단위로 확인하려면 중복문자제거 JavaScript 풀이도 함께 살펴볼 수 있습니다.
이 문제를 푼 뒤 확인하기
중복 단어가 연속·비연속으로 나타날 때 처음 등장한 순서가 유지되는지 확인해 보세요.
본문의 예제와 이 반례를 직접 실행해 예상 출력과 비교하고, 결과가 다르면 입력 조건과 반복 범위를 다시 확인하세요.
글 소개·학습 준비·전체 목차
각 단어가 처음 등장한 위치와 현재 위치를 비교하면 별도의 정렬 없이 입력 순서를 유지할 수 있습니다. 해설과 정답은 아래 접힌 영역에서 확인해 보세요.
이 글이 도움이 되었나요?
이어서 공부하기
체크포인트: 해설을 가리고 다시 풀고, 경계 입력을 하나 바꾸어 예상 결과와 실제 결과를 비교하세요. 같은 문자·찾는 문자 없음·홀짝 길이를 확인하고 결과의 등장 순서를 설명하세요.
다음 추천 · 알고리즘 개념: 투 포인터의 이동 기준: 양끝 비교와 정렬 배열 병합
권장 순서는 학습 가이드와 같습니다. 다른 순서는 접힌 참고 목록에서 확인할 수 있습니다. 읽음 표시는 숙달이나 채점 결과가 아닙니다.
원래 과정 목록 순서 (선택)
읽음 기록
읽음 — / 전체 58개 · 필수 58개
새 글 받아보기
RSS 리더에서 BlogFlow의 새 글을 확인할 수 있습니다.
