이 도구가 확인하는 범위
AEO나 GEO라는 표현을 붙였지만, 여기서 만드는 프로그램은 검색 노출이나 인용 가능성을 점수로 계산하지 않습니다. Google은 AI Overviews와 AI Mode에 별도의 기술 요구사항이 있는 것이 아니라, 페이지가 Google 검색에 색인되고 스니펫과 함께 표시될 자격을 갖추는 기본 요건이 먼저라고 설명합니다. 따라서 이 글은 그 결과를 예측하는 대신, 사이트 운영자가 배포 직후 놓치기 쉬운 원시 응답 단서를 재현 가능하게 확인하는 데만 집중합니다.
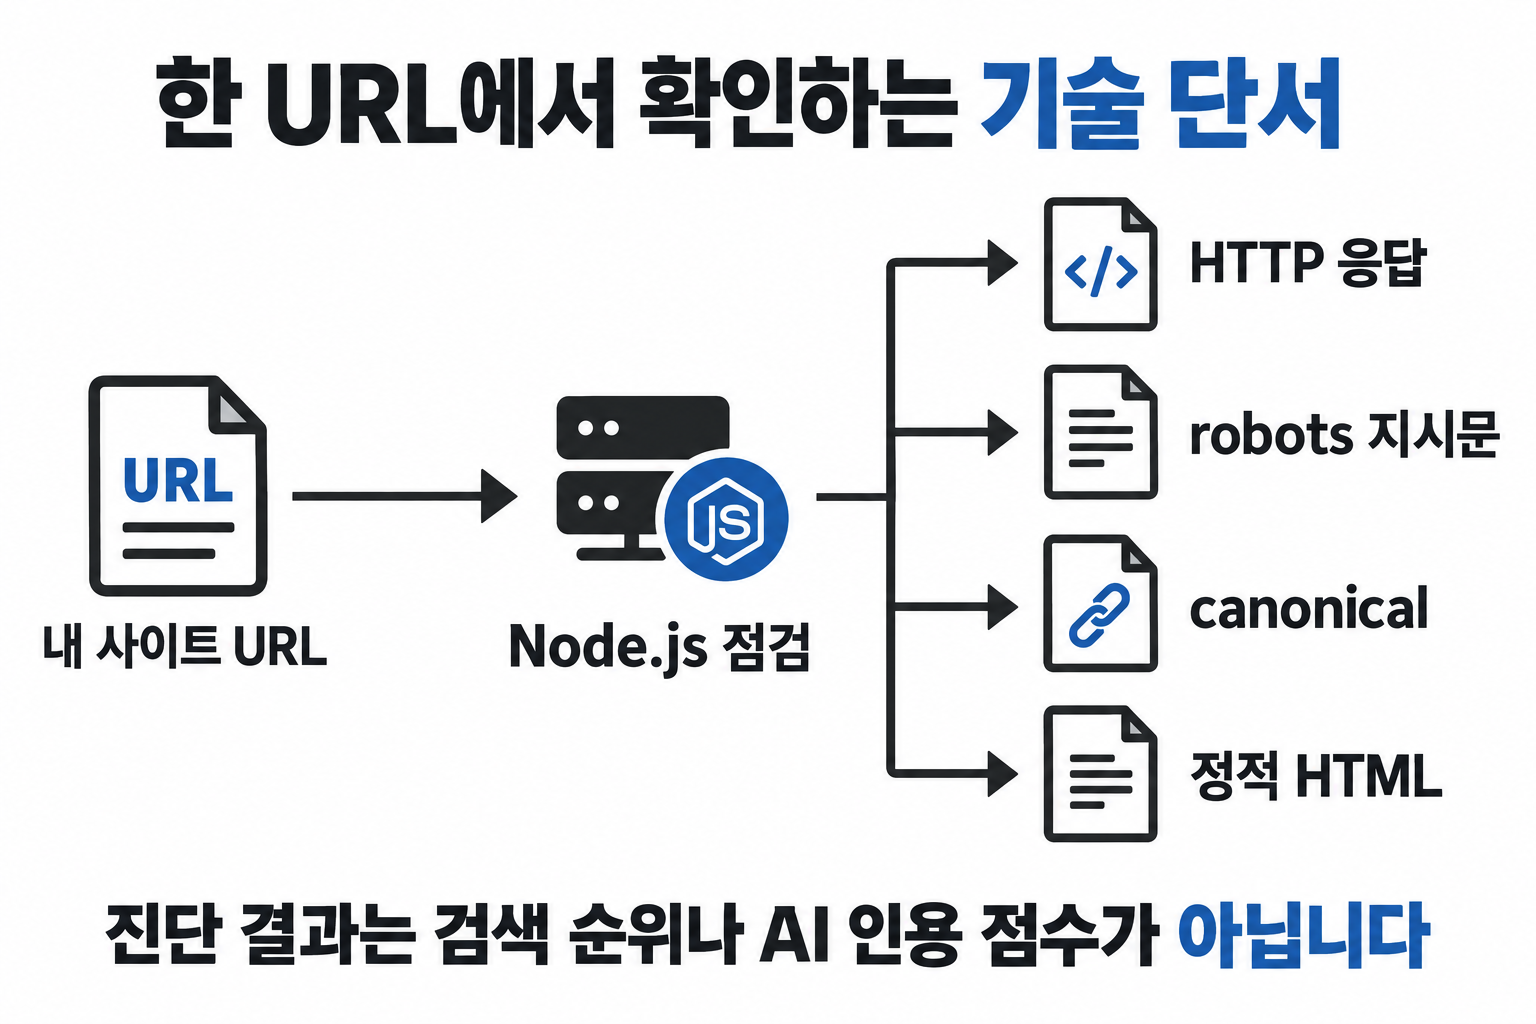
입력한 URL에 한 번 GET 요청을 보내고 다음 값만 기록합니다.
| 항목 | 기록하는 값 | 기록하지 않는 판단 |
|---|---|---|
| HTTP | 상태 코드, 상태 문구, Content-Type | 색인 가능 여부의 최종 판정 |
| robots | fetch가 노출한 X-Robots-Tag 문자열, HTML의 robots meta content 원문·기본 엔터티 해제값 | robots.txt나 크롤러별 충돌 규칙의 전체 해석 |
| canonical | HTML에서 처음 발견한 rel=canonical의 원문과 절대 URL, 후보 개수 | Google이 실제로 선택한 canonical |
| 정적 본문 | title, h1 목록, main 존재 여부·개수·텍스트 길이·앞 200자 | 브라우저에서 JavaScript 실행 뒤 만들어진 DOM |
Google 공식 문서에 따르면 robots meta와 X-Robots-Tag는 페이지 또는 리소스의 색인·표시 제어에 쓰입니다. canonical 표시는 선호 URL에 관한 신호이며, Google이 다른 URL을 선택할 수도 있습니다. 그러므로 값이 “있다”는 사실과 검색 시스템이 그 값을 어떻게 최종 처리하는지는 구분해야 합니다.
요청 경계와 안전장치
이 코드는 외부 사이트를 대량 조사하는 크롤러가 아니라, 본인이 소유하거나 점검 권한이 있는 URL 하나를 확인하는 로컬 CLI입니다. 쓰기 요청, 로그인, 쿠키 전송, 폼 제출, 링크 순회 기능은 없습니다.
- 입력: 명령행 인수 하나만 받으며, 절대 HTTP(S) URL만 허용합니다. URL에 사용자 이름이나 비밀번호가 있으면 요청 전에 거부합니다.
- 리디렉트: fetch의
redirect: 'manual'을 사용하고 301·302·303·307·308을 모두 실패로 처리합니다. 같은 사이트 리디렉트도 거부하므로 외부 호스트로 넘어가는 두 번째 요청이 생기지 않습니다. - 시간: 10초 타이머를 fetch가 응답 헤더를 받을 때까지만이 아니라 본문 스트림을 모두 읽을 때까지 유지합니다.
- 크기: Content-Length를 먼저 확인하고, 값이 없거나 부정확한 경우에도 실제 수신 바이트를 누적해 1MiB를 넘는 즉시 스트림을 취소합니다.
- 응답 형식: Content-Type이
text/html이 아니면 상태와 헤더까지만 보고하고 본문을 파싱하지 않습니다.
이 코드를 공개 API 서버로 감싸면 임의 URL 요청을 통한 내부망 접근 같은 별도 위험이 생깁니다. 그런 용도로 설계하지 않았으며, 그대로 서버에 노출하지 마세요.
완전한 실행 코드
아래 내용을 audit-tool.mjs로 저장하세요. 외부 패키지는 필요하지 않습니다.
#!/usr/bin/env node

import { pathToFileURL } from 'node:url';

const DEFAULT_TIMEOUT_MS = 10_000;
const DEFAULT_MAX_BYTES = 1024 * 1024;
const REDIRECT_STATUSES = new Set([301, 302, 303, 307, 308]);

export class AuditError extends Error {
  constructor(code, message) {
    super(message);
    this.name = 'AuditError';
    this.code = code;
  }
}

function validateTarget(input) {
  let url;
  try {
    url = new URL(input);
  } catch {
    throw new AuditError('INVALID_URL', '유효한 절대 URL을 입력하세요.');
  }

  if (!['http:', 'https:'].includes(url.protocol)) {
    throw new AuditError('INVALID_URL', 'http 또는 https URL만 사용할 수 있습니다.');
  }
  if (url.username || url.password) {
    throw new AuditError('INVALID_URL', '사용자 이름이나 비밀번호가 포함된 URL은 사용할 수 없습니다.');
  }

  url.hash = '';
  return url;
}

function decodeBasicEntities(value) {
  const named = {
    amp: '&',
    apos: "'",
    gt: '>',
    lt: '<',
    nbsp: ' ',
    quot: '"',
  };

  return value.replace(/&(#(?:x[0-9a-f]+|\d+)|[a-z]+);/gi, (whole, entity) => {
    if (entity[0] === '#') {
      const hexadecimal = entity[1]?.toLowerCase() === 'x';
      const number = Number.parseInt(entity.slice(hexadecimal ? 2 : 1), hexadecimal ? 16 : 10);
      if (Number.isInteger(number) && number >= 0 && number <= 0x10ffff) {
        try {
          return String.fromCodePoint(number);
        } catch {
          return whole;
        }
      }
      return whole;
    }
    return named[entity.toLowerCase()] ?? whole;
  });
}

function parseAttributes(tag) {
  const source = tag
    .replace(/^<\s*[^\s>]+/, '')
    .replace(/\/?\s*>$/, '');
  const values = new Map();
  const rawValues = new Map();
  const pattern = /([^\s=/>]+)(?:\s*=\s*(?:"([^"]*)"|'([^']*)'|([^\s"'=<>`]+)))?/g;

  for (const match of source.matchAll(pattern)) {
    const name = match[1].toLowerCase();
    const raw = match[2] ?? match[3] ?? match[4] ?? '';
    if (!values.has(name)) {
      values.set(name, decodeBasicEntities(raw));
      rawValues.set(name, raw);
    }
  }
  return { values, rawValues };
}

function textContent(fragment) {
  return decodeBasicEntities(
    fragment
      .replace(/<script\b[^>]*>[\s\S]*?<\/script\s*>/gi, ' ')
      .replace(/<style\b[^>]*>[\s\S]*?<\/style\s*>/gi, ' ')
      .replace(/<[^>]+>/g, ' '),
  ).replace(/\s+/g, ' ').trim();
}

function firstText(html, tagName) {
  const match = new RegExp(`<${tagName}\\b[^>]*>([\\s\\S]*?)<\\/${tagName}\\s*>`, 'i').exec(html);
  return match ? textContent(match[1]) : null;
}

function allText(html, tagName) {
  const pattern = new RegExp(`<${tagName}\\b[^>]*>([\\s\\S]*?)<\\/${tagName}\\s*>`, 'gi');
  return [...html.matchAll(pattern)].map((match) => textContent(match[1]));
}

function inspectHtml(html, baseUrl) {
  const inspectableHtml = html
    .replace(/<!--[\s\S]*?-->/g, ' ')
    .replace(/<script\b[^>]*>[\s\S]*?<\/script\s*>/gi, ' ')
    .replace(/<style\b[^>]*>[\s\S]*?<\/style\s*>/gi, ' ')
    .replace(/<template\b[^>]*>[\s\S]*?<\/template\s*>/gi, ' ');
  const robotsMeta = [];
  const robotsMetaRaw = [];
  const canonicalCandidates = [];

  for (const match of inspectableHtml.matchAll(/<meta\b[^>]*>/gi)) {
    const { values, rawValues } = parseAttributes(match[0]);
    if (values.get('name')?.toLowerCase() === 'robots') {
      robotsMeta.push(values.get('content') ?? '');
      robotsMetaRaw.push(rawValues.get('content') ?? '');
    }
  }

  for (const match of inspectableHtml.matchAll(/<link\b[^>]*>/gi)) {
    const { values, rawValues } = parseAttributes(match[0]);
    const relTokens = (values.get('rel') ?? '').toLowerCase().split(/\s+/);
    if (relTokens.includes('canonical') && values.has('href')) {
      const raw = rawValues.get('href') ?? '';
      const decoded = values.get('href') ?? '';
      let resolved = null;
      try {
        resolved = new URL(decoded, baseUrl).href;
      } catch {
        // 잘못된 canonical도 원문은 보고하되 URL로 단정하지 않는다.
      }
      canonicalCandidates.push({ raw, url: resolved });
    }
  }

  const mainBlocks = allText(inspectableHtml, 'main');
  const mainText = mainBlocks.join(' ').replace(/\s+/g, ' ').trim();

  return {
    robotsMeta,
    robotsMetaRaw,
    canonical: {
      present: canonicalCandidates.length > 0,
      count: canonicalCandidates.length,
      raw: canonicalCandidates[0]?.raw ?? null,
      url: canonicalCandidates[0]?.url ?? null,
    },
    title: firstText(inspectableHtml, 'title'),
    h1: allText(inspectableHtml, 'h1'),
    main: {
      present: mainBlocks.length > 0,
      count: mainBlocks.length,
      textLength: mainText.length,
      text: mainText.slice(0, 200),
    },
  };
}

async function readLimitedBody(response, maxBytes) {
  const contentLength = Number.parseInt(response.headers.get('content-length') ?? '', 10);
  if (Number.isFinite(contentLength) && contentLength > maxBytes) {
    await response.body?.cancel();
    throw new AuditError('BODY_TOO_LARGE', `본문이 ${maxBytes}바이트 제한을 넘습니다.`);
  }

  if (!response.body) return { bytes: 0, text: '' };

  const reader = response.body.getReader();
  const chunks = [];
  let bytes = 0;
  try {
    while (true) {
      const { done, value } = await reader.read();
      if (done) break;
      bytes += value.byteLength;
      if (bytes > maxBytes) {
        await reader.cancel();
        throw new AuditError('BODY_TOO_LARGE', `본문이 ${maxBytes}바이트 제한을 넘습니다.`);
      }
      chunks.push(value);
    }
  } finally {
    reader.releaseLock();
  }

  return { bytes, text: new TextDecoder().decode(Buffer.concat(chunks)) };
}

export async function auditUrl(input, options = {}) {
  const timeoutMs = options.timeoutMs ?? DEFAULT_TIMEOUT_MS;
  const maxBytes = options.maxBytes ?? DEFAULT_MAX_BYTES;
  if (!Number.isInteger(timeoutMs) || timeoutMs <= 0 || !Number.isInteger(maxBytes) || maxBytes <= 0) {
    throw new TypeError('timeoutMs와 maxBytes는 양의 정수여야 합니다.');
  }

  const url = validateTarget(input);
  const controller = new AbortController();
  let timedOut = false;
  const timer = setTimeout(() => {
    timedOut = true;
    controller.abort();
  }, timeoutMs);

  try {
    const response = await fetch(url, {
      method: 'GET',
      redirect: 'manual',
      credentials: 'omit',
      signal: controller.signal,
      headers: { 'user-agent': 'BlogFlow-read-only-page-audit/1.0' },
    });

    if (REDIRECT_STATUSES.has(response.status)) {
      await response.body?.cancel();
      throw new AuditError(
        'REDIRECT_REFUSED',
        `리디렉트 응답(${response.status})을 따라가지 않았습니다: ${response.headers.get('location') ?? '(Location 없음)'}`,
      );
    }

    const contentType = response.headers.get('content-type');
    const baseReport = {
      url: url.href,
      http: {
        status: response.status,
        statusText: response.statusText,
        contentType,
        xRobotsTag: response.headers.get('x-robots-tag'),
      },
    };

    if (!/^text\/html(?:\s*;|$)/i.test(contentType ?? '')) {
      await response.body?.cancel();
      return {
        ...baseReport,
        bodyBytes: 0,
        html: null,
        skippedReason: 'Content-Type이 HTML이 아닙니다.',
      };
    }

    const body = await readLimitedBody(response, maxBytes);
    return {
      ...baseReport,
      bodyBytes: body.bytes,
      html: inspectHtml(body.text, url),
      skippedReason: null,
    };
  } catch (error) {
    if (timedOut) {
      throw new AuditError('TIMEOUT', `${timeoutMs}ms 안에 응답 본문 수신을 마치지 못했습니다.`);
    }
    throw error;
  } finally {
    clearTimeout(timer);
  }
}

async function main(args) {
  if (args.length !== 1) {
    throw new AuditError('USAGE', '사용법: node audit-tool.mjs https://본인-사이트.example/page');
  }
  const report = await auditUrl(args[0]);
  process.stdout.write(`${JSON.stringify(report, null, 2)}\n`);
}

const invokedPath = process.argv[1] ? pathToFileURL(process.argv[1]).href : '';
if (import.meta.url === invokedPath) {
  main(process.argv.slice(2)).catch((error) => {
    const code = error?.code ? `[${error.code}] ` : '';
    process.stderr.write(`${code}${error?.message ?? String(error)}\n`);
    process.exitCode = 1;
  });
}
실행 방법과 예상 출력
Node.js 24에서 터미널을 열고, 파일이 있는 폴더에서 본인 사이트의 실제 URL을 하나 지정합니다.
node audit-tool.mjs https://example.com/guideHTML 200 응답에 robots meta와 canonical이 있고, h1과 main이 정적 HTML에 들어 있다면 다음과 같은 JSON이 나옵니다. 아래 값은 형식을 보여주기 위한 예시이며 특정 사이트의 실제 진단 결과가 아닙니다.
{
  "url": "https://example.com/guide",
  "http": {
    "status": 200,
    "statusText": "OK",
    "contentType": "text/html; charset=utf-8",
    "xRobotsTag": null
  },
  "bodyBytes": 42810,
  "html": {
    "robotsMeta": ["index, follow"],
    "robotsMetaRaw": ["index, follow"],
    "canonical": {
      "present": true,
      "count": 1,
      "raw": "/guide",
      "url": "https://example.com/guide"
    },
    "title": "가이드 제목",
    "h1": ["가이드 제목"],
    "main": {
      "present": true,
      "count": 1,
      "textLength": 3210,
      "text": "이 페이지의 정적 main 텍스트 앞부분…"
    }
  },
  "skippedReason": null
}
오류는 표준 오류로 이유를 출력하고 종료 코드 1을 반환합니다. 예를 들어 리디렉트는 [REDIRECT_REFUSED], 제한 시간 초과는 [TIMEOUT], 본문 초과는 [BODY_TOO_LARGE]로 구분됩니다. 404는 네트워크 실패로 숨기지 않고 http.status: 404인 보고서로 남깁니다.
출력 해석 방법
- status: 기대한 공개 페이지가 200인지 확인하는 출발점입니다. 200만으로 색인이나 노출을 보장하지 않으며, 404도 이 도구에서는 관찰 가능한 응답입니다.
- xRobotsTag: Node fetch의 Headers가 제공한 문자열입니다. 같은 이름의 여러 헤더가 결합될 수 있어 네트워크에서 받은 바이트 단위 원본과 같다고 보장하지 않습니다.
- robotsMetaRaw / robotsMeta: 전자는 content 속성의 HTML 표기, 후자는 기본 엔터티를 푼 값입니다. 중복 태그는 배열에 모두 남기지만 지시어 충돌의 승자를 계산하지 않습니다.
- canonical:
present와count로 존재·중복을 보고, 처음 발견한 href를raw와 절대url로 보여줍니다. 이는 선언 확인이지 Google의 선택 결과가 아닙니다. - title / h1 / main: 서버가 보낸 HTML 문자열에 해당 태그와 텍스트가 있는지 보여주는 정적 단서입니다. main.text는 로그가 커지지 않도록 앞 200자만 기록합니다.
결과가 예상과 다르면 먼저 브라우저의 “페이지 소스 보기”와 서버 설정을 대조하세요. 검색 시스템이 실제로 수집한 결과는 Google Search Console의 URL 검사 등 해당 서비스의 공식 도구로 별도 확인해야 합니다.
작성자 로컬 fixture 검증 기록
이 절은 독자가 실행해야 하는 절차가 아니라 이 글의 코드를 작성하며 남긴 검증 기록입니다. 인터넷 사이트를 테스트 대상으로 삼지 않고, Node의 node:http로 로컬 서버를 띄운 별도 테스트 파일을 먼저 작성했습니다. 구현 전 첫 실행은 audit-tool.mjs가 없어 ERR_MODULE_NOT_FOUND로 1개 테스트 파일이 실패했습니다. 구현 뒤 8개 테스트가 통과했고, 이어서 script·style·template 내부 가짜 태그 오탐을 재현한 테스트가 실패하는 것을 확인한 뒤 구현을 보완해 최종 9개 테스트를 통과시켰습니다.
node --test audit-tool.test.mjs| fixture | 확인한 동작 |
|---|---|
| 성공 HTML | 200, X-Robots-Tag, robots meta, 상대 canonical, title·h1·main을 보고 |
| 404 | 예외로 감추지 않고 상태와 HTML 단서를 보고 |
| 302 | Location을 따라 두 번째 요청을 보내지 않고 거부 |
| 멈춘 본문 | 헤더 수신 뒤 본문 스트림 대기 중에도 타임아웃 |
| 크기 초과 | 수신 바이트가 제한을 넘으면 취소 |
| JSON | HTTP 헤더만 남기고 HTML 검사 생략 |
| 변형 HTML | 속성 순서, 홑따옴표, 중복 meta, 기본 엔터티, 표준 주석 속 가짜 태그 처리 |
| 비검사 구간 | script·style·template 내부 문자열의 가짜 meta·link·h1·main 제외 |
| 잘못된 입력 | HTTP(S) 외 스킴과 사용자 정보가 든 URL을 요청 전에 거부 |
위 테스트 소스는 게시 본문에 포함하지 않았으므로 독자용 실행 명령이 아닙니다. 독자가 저장할 파일은 “완전한 실행 코드”의 audit-tool.mjs 하나이며, 명령행 실행은 고정 기본값 10초와 1MiB를 사용합니다.
HTML 추출 한계
의존성을 늘리지 않기 위해 프로덕션급 HTML 파서 대신 좁은 정규식 추출기를 사용했습니다. 속성 순서가 바뀐 meta, 홑따옴표, 대소문자, 중복 robots meta, 자주 쓰는 엔터티와 숫자 엔터티, 정상적으로 닫힌 HTML 주석을 처리합니다. 또한 표준 형태의 script·style·template 구간을 먼저 제외해 그 안의 예시 문자열을 실제 태그로 세는 오탐을 막는 테스트를 추가했습니다. 하지만 이것이 HTML 표준 전체를 구현했다는 뜻은 아닙니다.
- 따옴표 안의
>, 깨진 태그, 중첩되거나 닫히지 않은 주석·script·style·template, 비표준 마크업에서는 태그 경계를 잘못 잡아 거짓 양성이나 누락이 생길 수 있습니다. - 중복 속성은 첫 값만 사용하고, 중복 canonical은 개수와 첫 후보만 보여줍니다. 어느 선언이 유효한지 판정하지 않습니다.
- 상대 canonical은 점검한 URL을 기준으로 절대 URL로 바꿉니다. 문서의
<base href>를 해석하지 않으므로 base를 사용하는 페이지에서는 canonical URL이 다르게 보고될 수 있습니다. amp,lt,gt,quot,apos,nbsp와 숫자 엔터티만 풉니다. 그 밖의 이름 엔터티는 원문으로 남습니다.- 본문은 UTF-8로 해석합니다. 다른 문자 인코딩을 선언한 오래된 페이지는 텍스트가 깨질 수 있습니다.
- robots meta 중
name="robots"만 수집합니다. googlebot 같은 특정 사용자 에이전트 태그, robots.txt, HTTP Link canonical은 다루지 않습니다. - JavaScript를 실행하지 않으므로 클라이언트 렌더링 뒤 생기는 title·h1·main·canonical은 볼 수 없습니다.
복잡한 실제 사이트에서 정확한 DOM 해석이 필요하다면 검증된 HTML 파서를 도입하고 그에 맞는 보안·업데이트 비용을 함께 관리해야 합니다. 이 글의 코드는 범위를 넓혀 “SEO 완전 진단기”로 포장하기보다 작은 배포 확인 도구로 유지하는 편이 맞습니다.
공식 출처
아래 공식 문서를 2026년 9월 10일에 확인했습니다.
- Google Search Central: AI features and your website — AI 기능의 기술 요건과 기본 SEO 원칙
- Google Search Central: Robots meta tag와 X-Robots-Tag 사양 — 페이지·응답 헤더 수준의 제어 방식
- Google Search Central: canonical URL 지정 방법 — rel=canonical의 용도와 한계
- Node.js 24 문서: fetch — 내장 Fetch API와 AbortController
- Node.js 24 문서: ReadableStream.getReader() — 응답 본문 스트림 읽기와 취소
- Node.js 24 문서: WHATWG URL — 입력 파싱과 상대 canonical 해석
- Node.js 24 문서: test runner —
node --test실행
함께 읽기: AEO·GEO·SEO 차이와 기본 전략, Next.js SEO 가이드를 통해 점검한 값의 의미와 실제 설정을 연결해 보세요.
이 글이 도움이 되었나요?
새 글 받아보기
RSS 리더에서 BlogFlow의 새 글을 확인할 수 있습니다.