읽기 전에 알아두면 좋아요
아래 개념이 익숙하면 본문을 바로 읽으세요. 낯선 개념만 링크에서 복습하면 됩니다.
- 큐와 FIFO: head 인덱스로 JavaScript 대기열 만들기큐는 먼저 넣은 값을 먼저 꺼냅니다. 대기열에 넣고 꺼낼 때의 순서를 확인합니다.
개념과 예제는 실행하지 않아도 읽을 수 있습니다. 내 컴퓨터·터미널에서 직접 실행하는 과정은 선택 실습입니다.
과정 위치와 선택 복습 안내
과정 위치: 자료구조 개념과 문제 · 자료구조 개념
과정 위치는 이 글이 속한 묶음입니다. 이 단계의 모든 개념을 먼저 읽을 필요는 없습니다. 위에 연결한 개념 중 낯선 내용만 복습하세요. 문제의 조건·상태·갱신 순서는 익숙한 언어로 설명하면 됩니다.
JavaScript로 문법·실행 복습하기 (선택)
개념 글의 코드는 JavaScript 예시입니다. 문제 화면에서는 JavaScript·Python·Java·C++·C# 중 익숙한 언어의 함수를 작성하세요. 본문의 Node.js 입출력 예시는 로컬 실행을 위한 별도 안내입니다.
단방향 연결 리스트에서 head와 tail은 어떤 역할을 하나요?
연결 리스트는 각 항목이 다음 항목을 가리키는 목록입니다. head는 첫 항목, tail은 마지막 항목이며, 값을 넣거나 뺄 때 배열을 밀기보다 연결을 바꿉니다.
적용 조건·범위: 원본 삭제는 남은 목록의 연결을 바꾸지만 반환 노드의 next를 떼어내지는 않습니다. [1,2]에서 앞 노드를 삭제하면 목록은 [2]가 되어도 반환 노드의 next.data는 여전히 2입니다. 본문의 IndexedList가 삭제 노드의 next를 null로 바꾸고 값만 돌려주는 방식과 구분하세요. 이 시연에는 빈 목록의 잘못된 삭제나 소수 인덱스 검증이 없으므로 정상 출력만으로 모든 경계를 검증했다고 볼 수 없습니다.
공식 문서 참고: NIST: 단방향 연결 리스트와 head 포인터
연결 리스트: 값과 다음 항목을 함께 기억합니다
A가 B를, B가 C를 가리키는 작은 목록부터 시작합니다. JavaScript 객체 두 개를 연결하고, 연결을 바꾸는 이유를 손으로 따라간 뒤 뒤 추가·앞 제거를 구현합니다.
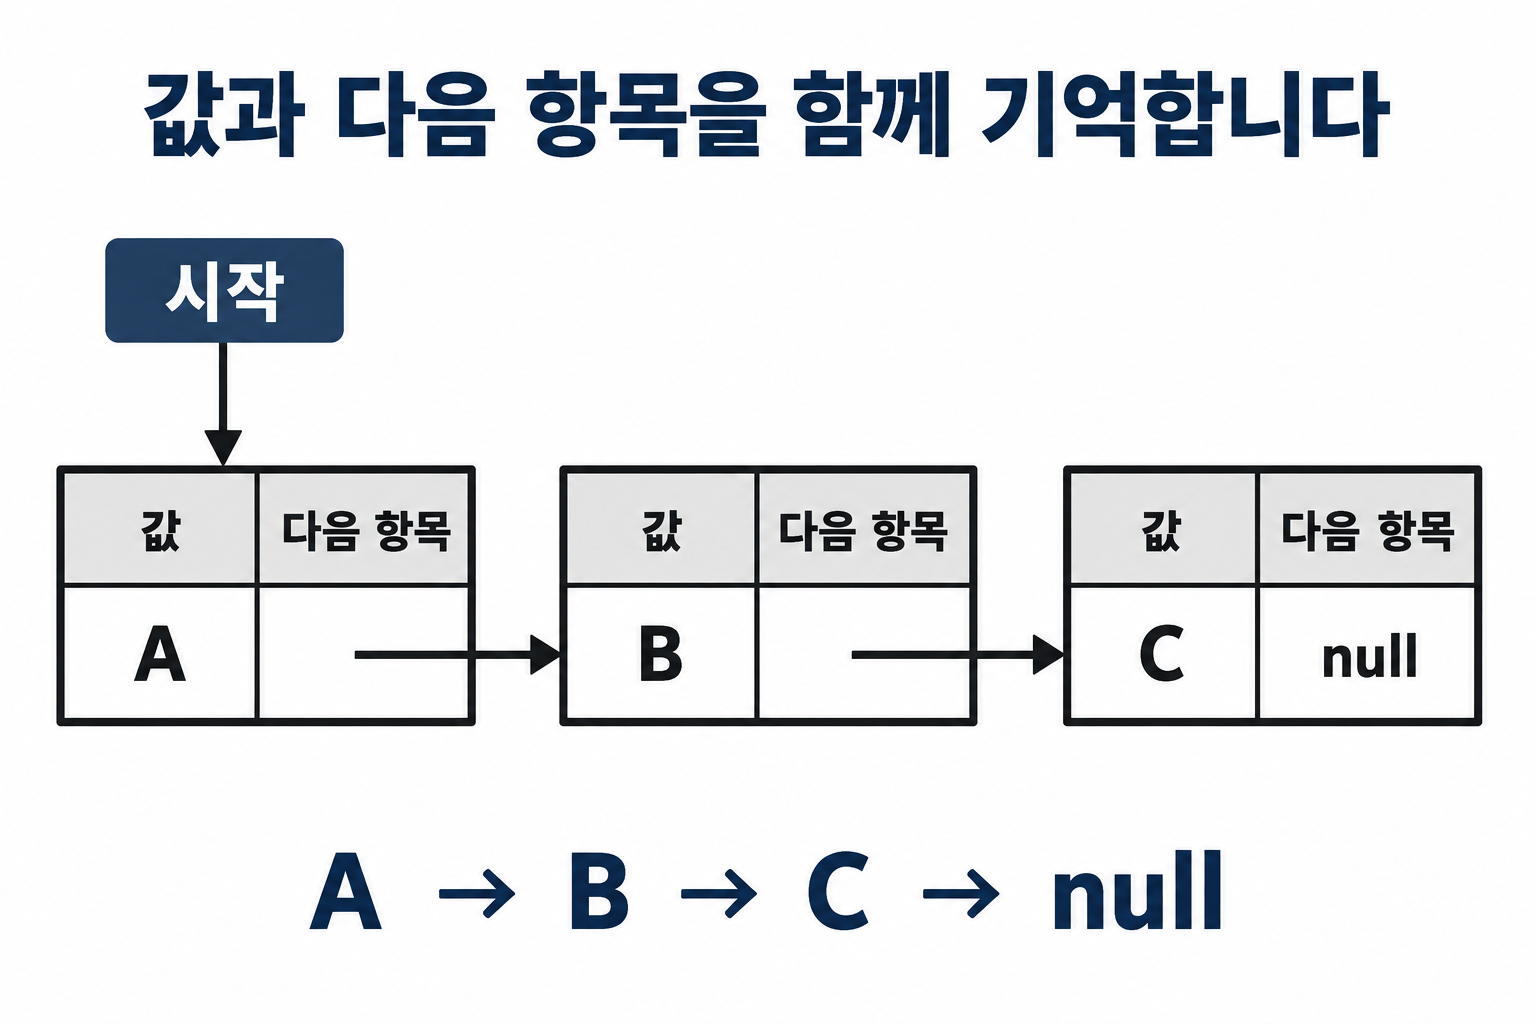
선수 지식: JavaScript 변수·배열·조건문을 먼저 익힙니다. 객체 참조나 함수가 낯설면 아래 단계별 예제부터 시작하고, class 전체 구현은 해당 동작을 손으로 추적한 뒤 읽습니다. 각각의 코드는 독립 실행합니다.
1. 번호 대신 “다음은 누구인가”를 적습니다
곡 A를 듣고 나면 B, B 다음에는 C를 들을 재생 목록을 생각해 보세요. 배열은 0번, 1번, 2번 같은 위치로 곡을 읽습니다. 연결 리스트는 각 항목에 “내 값”과 “다음 항목”을 함께 적어 둡니다. 시작 항목을 알면 다음 표시를 따라 목록을 읽을 수 있습니다.
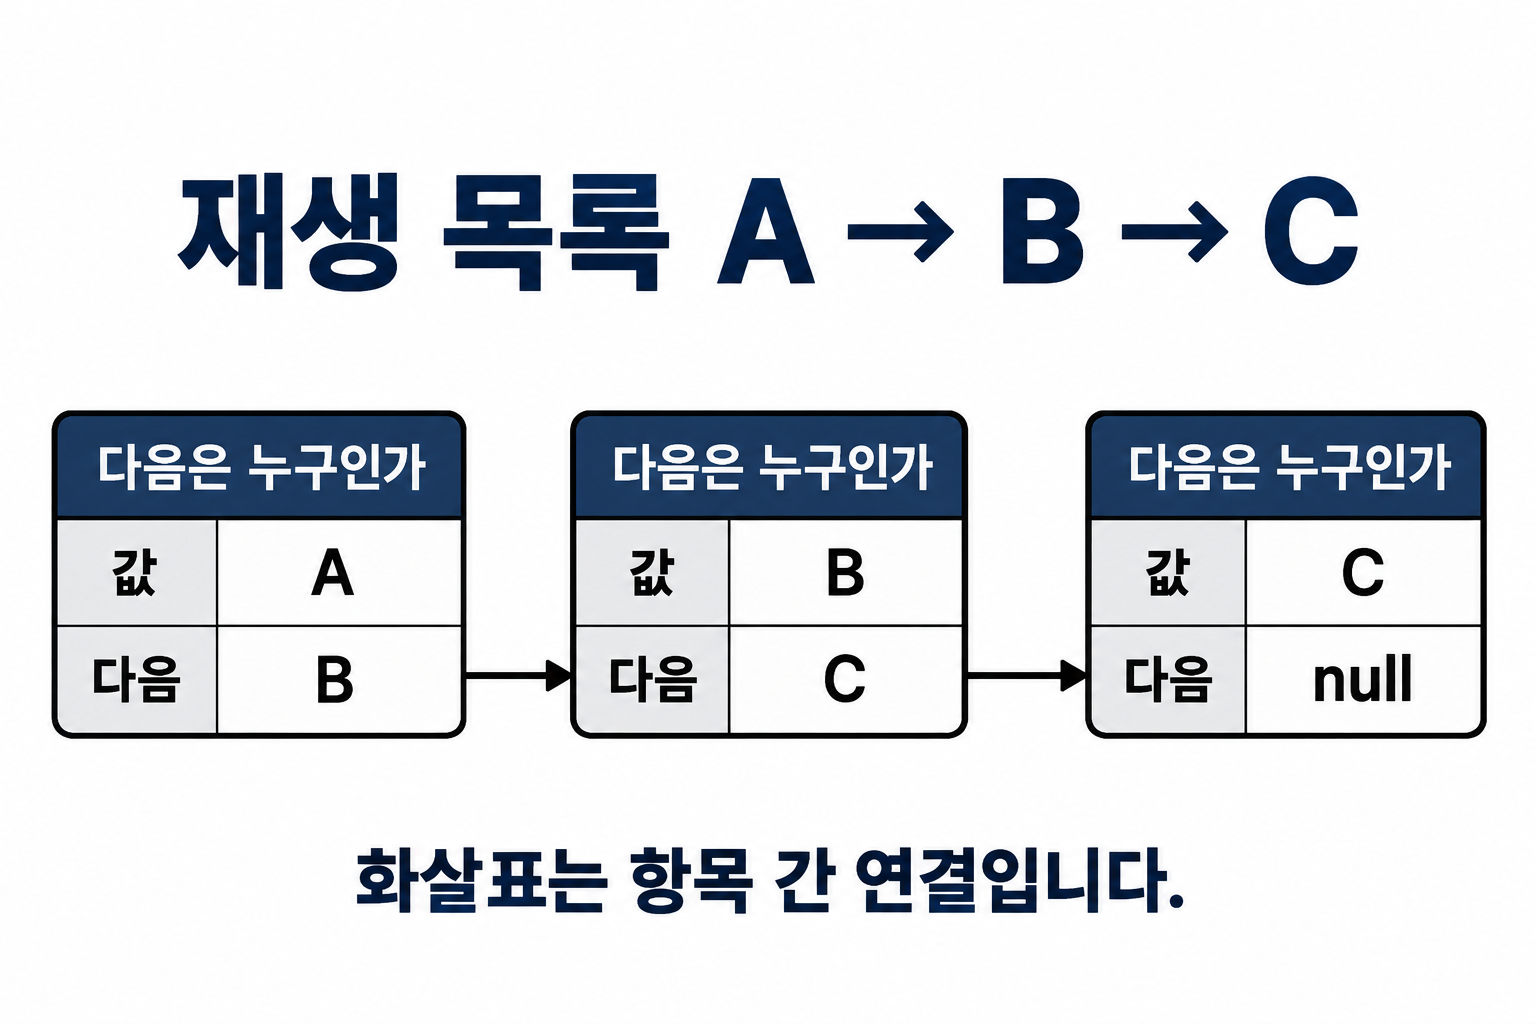
| 항목 | 내 값 | 다음 항목 |
|---|---|---|
| 첫 항목 | A | B 항목 |
| 두 번째 항목 | B | C 항목 |
| 마지막 항목 | C | 없음(null) |
이를 A → B → C → null이라고 줄여 쓰겠습니다. 화살표는 곡이 이동한다는 뜻이 아니라 “다음에 이 항목으로 간다”는 연결입니다. 이런 항목 하나를 노드(node)라고 부릅니다. 처음에는 “값과 다음 표시가 든 작은 객체”라고 이해하면 충분합니다.
2. JavaScript 객체 두 개를 먼저 연결합니다
이 글의 예제는 브라우저 개발자 도구 Console 탭에서 실행할 수 있습니다. 파일 저장이나 설치 없이 각 코드 블록 전체를 붙여 넣으세요. 각 예제는 다른 예제 없이도 실행됩니다. 같은 예제를 다시 실행하다 이름이 이미 선언되었다는 오류가 나오면 페이지를 새로고침한 뒤 실행하세요. 콘솔이 별도로 보여주는 undefined는 마지막 명령의 반환값일 수 있습니다.
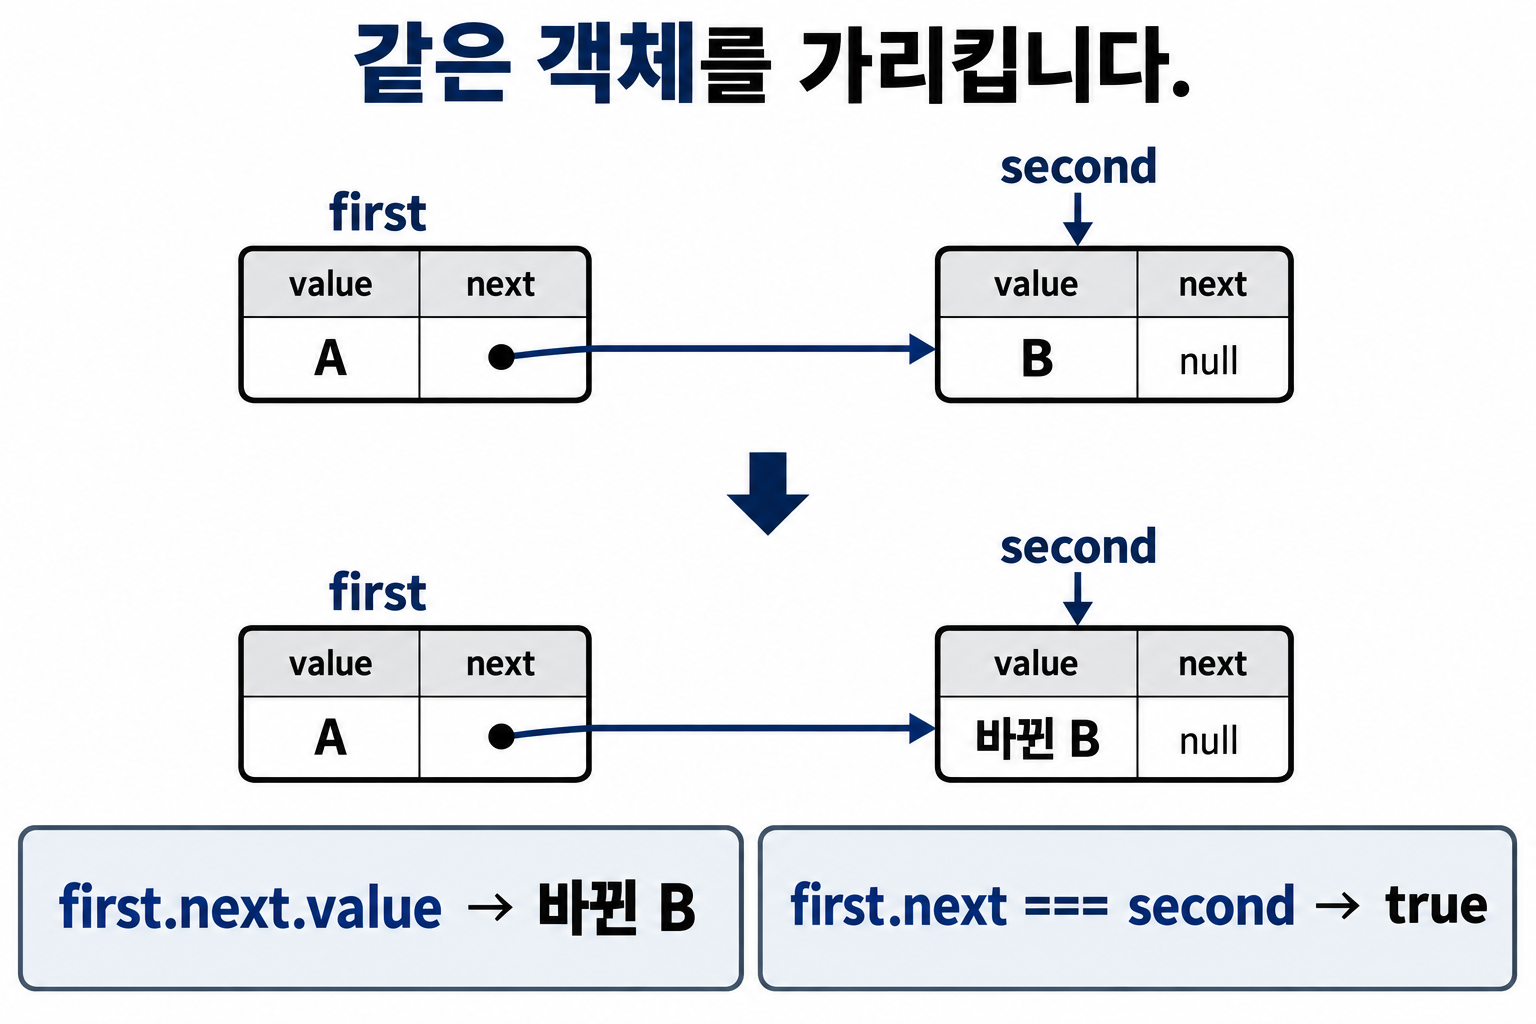
아래에서는 B 객체를 먼저 만들고 A 객체의 next에 넣습니다. null은 “다음 항목이 없다”는 뜻으로 사용합니다. 우선 출력이 A, B로 이어지는지만 확인한 뒤 나머지 줄을 읽어 보세요.
const second = { value: "B", next: null };
const first = { value: "A", next: second };
console.log(first.value);
console.log(first.next.value);
console.log(first.next === second);
second.value = "바뀐 B";
console.log(first.next.value);
출력:
A
B
true
바뀐 B
| 줄 | 뜻과 필요한 이유 |
|---|---|
| const second = { value: “B”, next: null }; | B라는 값과 다음 항목 없음(null)을 가진 객체 하나를 만듭니다. |
| const first = { value: “A”, next: second }; | A 객체를 만들고 next가 앞에서 만든 B 객체를 가리키게 합니다. B를 새로 복사하는 것이 아닙니다. |
| console.log(first.value); | A 객체 자신의 값을 읽습니다. |
| console.log(first.next.value); | A의 next를 한 번 따라간 뒤 그 객체의 값 B를 읽습니다. |
| console.log(first.next === second); | 두 표현이 같은 B 객체를 가리켜 true입니다. 내용만 같은 별도 객체라는 뜻이 아닙니다. |
| second.value = “바뀐 B”; | 기존 B 객체 안의 value를 바꿉니다. |
| console.log(first.next.value); | 같은 객체를 읽으므로 바뀐 B가 나옵니다. |
여기서 중요한 것은 참조라는 말입니다. first.next에는 B 객체를 찾아갈 수 있는 연결을 저장합니다. second도 first.next도 같은 객체로 갑니다. 따라서 second를 통해 값을 바꾸면 first.next로 읽을 때도 바뀐 값을 봅니다. 객체를 복제해 따로 보관한 것이 아닙니다.
const는 변수 second에 다른 객체를 다시 대입하지 못하게 합니다. 객체 안의 second.value까지 변경 금지로 만드는 것은 아닙니다. 이 차이를 알아야 다음 단계의 next 변경도 자연스럽게 읽을 수 있습니다.
3. A → B → C에서 B를 건너뛰어 봅니다
이제 세 노드를 만들겠습니다. 연결 리스트에서 중간 항목을 제외한다는 것은 남은 모든 값을 앞 칸으로 옮기는 일이 아닙니다. A의 다음을 B 대신 C로 바꾸면 A에서 출발하는 경로가 A → C가 됩니다.
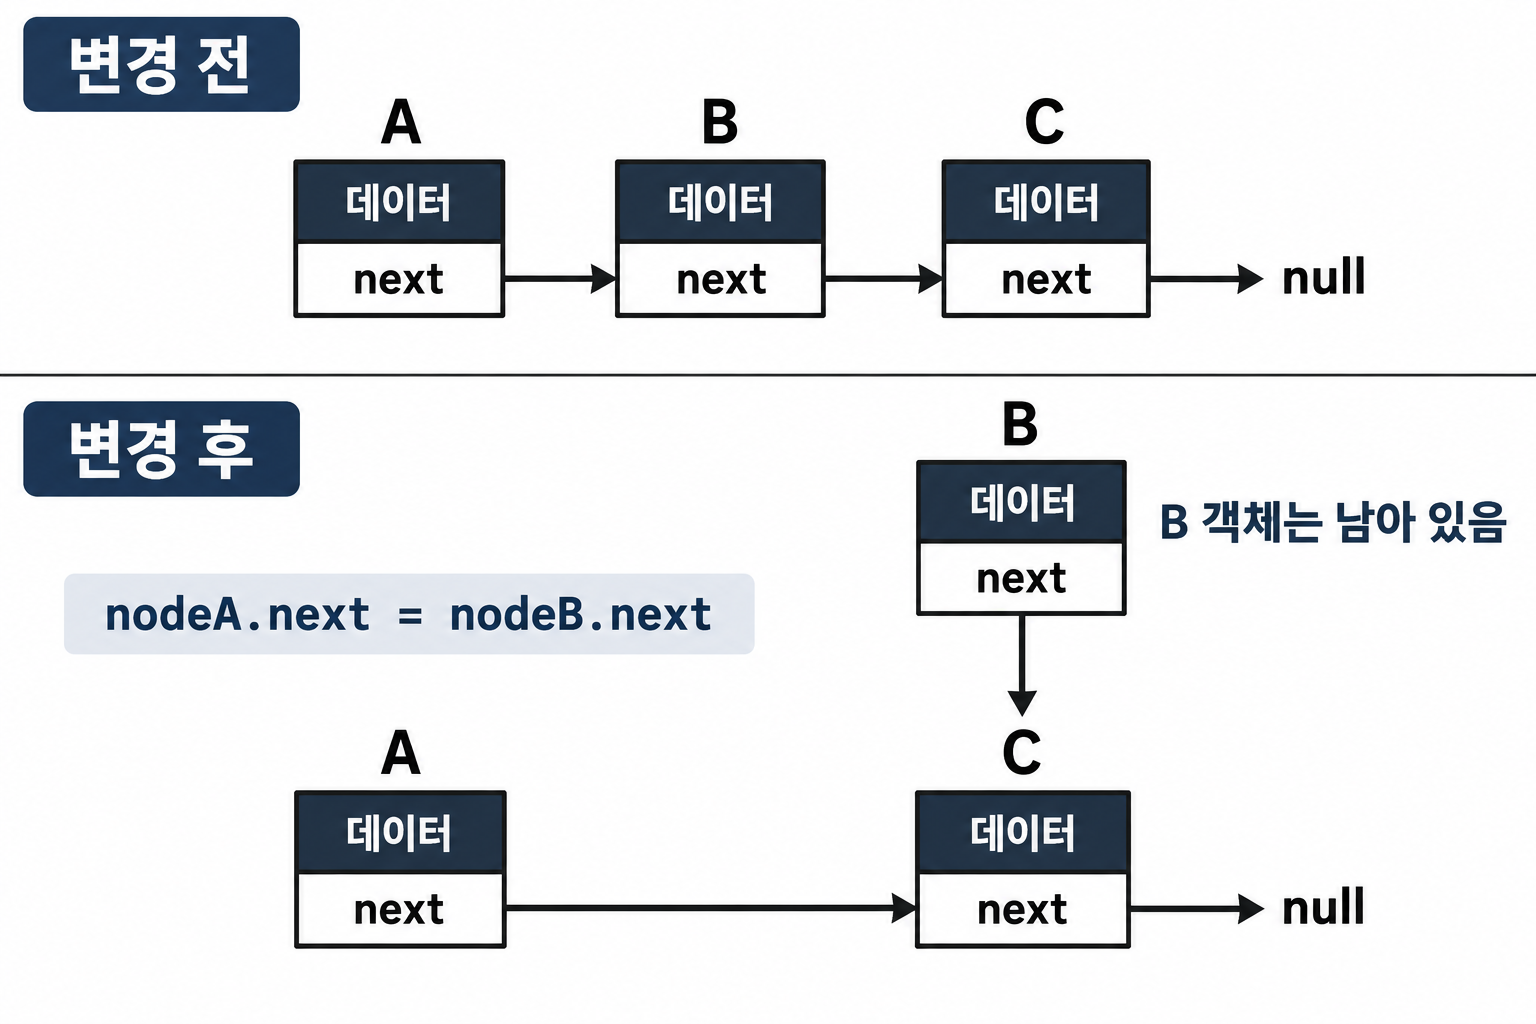
| 시점 | A의 next | B의 next | A에서 따라간 경로 |
|---|---|---|---|
| 바꾸기 전 | B | C | A → B → C → null |
| A의 next를 B의 next로 변경 | C | C | A → C → null |
const nodeC = { value: "C", next: null };
const nodeB = { value: "B", next: nodeC };
const nodeA = { value: "A", next: nodeB };
console.log(nodeA.next.value);
nodeA.next = nodeB.next;
console.log(nodeA.next.value);
console.log(nodeB.value);
출력:
B
C
B
nodeA.next = nodeB.next에서 오른쪽 nodeB.next는 C 객체입니다. 따라서 이 줄은 A의 next를 C로 바꿉니다. nodeA.next = null이라면 B뿐 아니라 C로 가는 길도 끊어집니다. “어디를 없앨까”보다 “남은 앞뒤를 어떻게 다시 이을까”를 먼저 생각하세요.
마지막 출력이 여전히 B인 것도 중요합니다. 연결에서 건너뛰었다고 B 객체 자체가 즉시 삭제된 것은 아닙니다. 이 예제에는 nodeB라는 변수가 아직 B 객체를 가리키고 있어 읽을 수 있습니다. 바뀐 것은 A에서 시작해 따라가는 경로입니다.
4. 잠깐, 한 줄만 바꾼다면?
A → B → C → null에서 A만 남기려면 A의 next를 무엇으로 바꿔야 할까요? 반대로 A → C를 만들려면요?
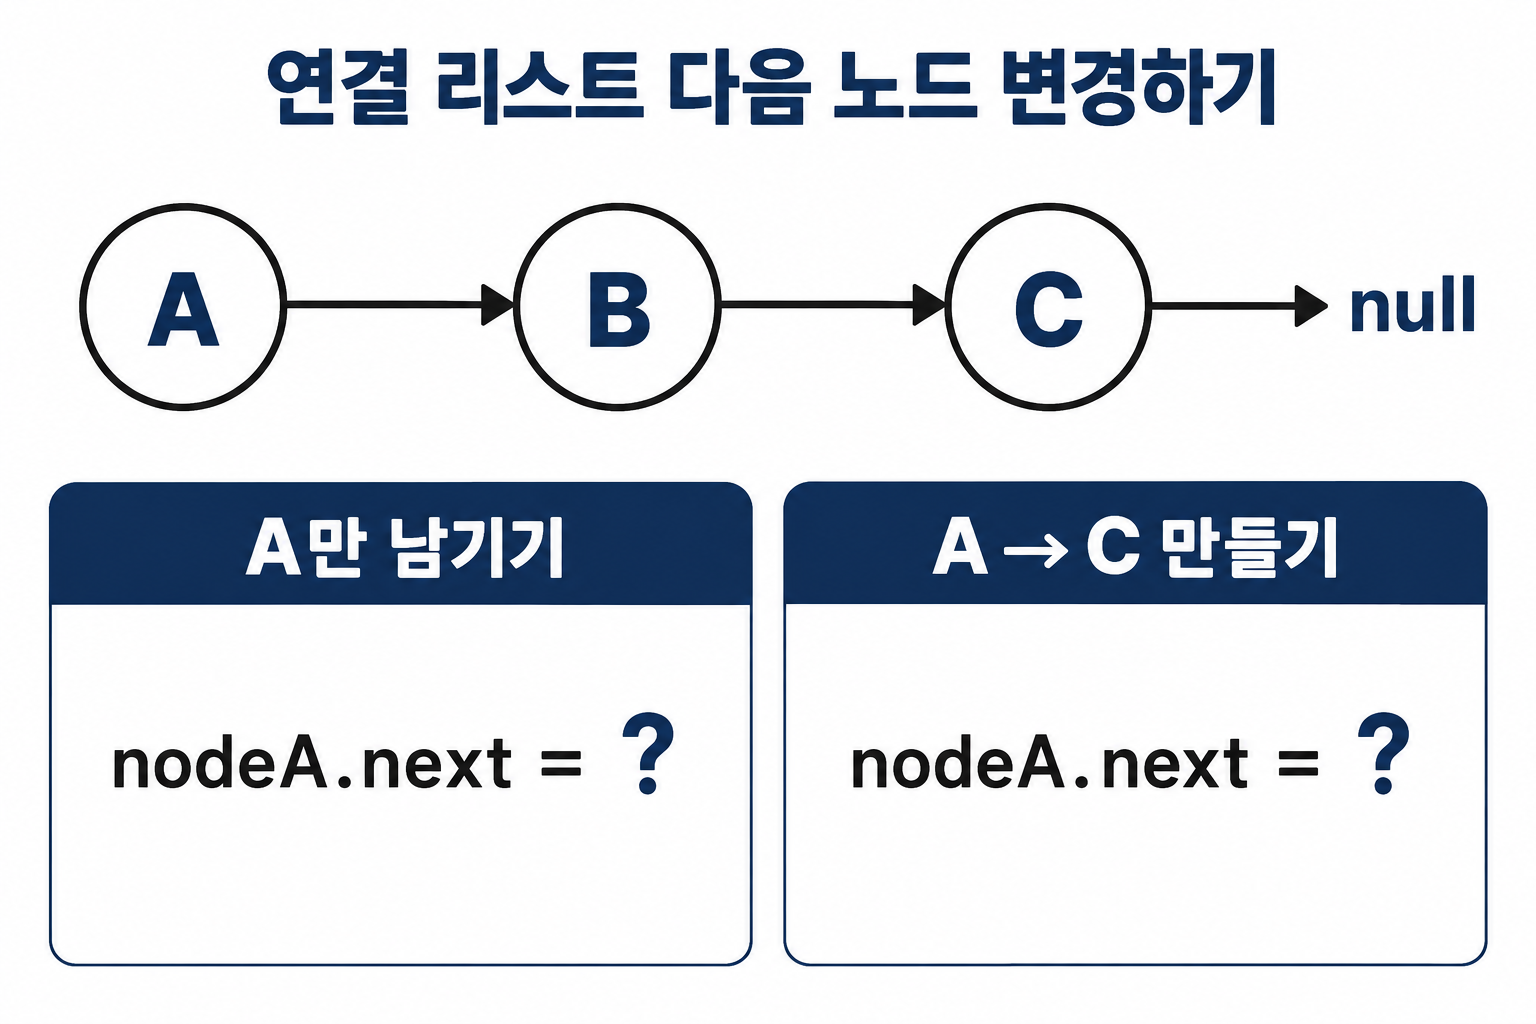
답과 이유 확인하기
A만 남기려면 nodeA.next = null입니다. A → C를 만들려면 nodeA.next = nodeC 또는 nodeA.next = nodeB.next입니다. 다음 표시를 어디로 바꾸느냐에 따라 이어서 읽을 수 있는 항목이 달라집니다.
5. 첫 항목과 마지막 항목을 따로 기억합니다
지금까지는 nodeA, nodeB처럼 노드를 이미 알고 있었습니다. 항목이 많이 늘어나면 모든 변수 이름을 따로 만들 수 없습니다. 그래서 목록의 첫 노드를 head, 마지막 노드를 tail이라는 두 변수로 기억하겠습니다. head와 tail은 새 노드가 아니라 기존 노드를 가리키는 표시입니다.
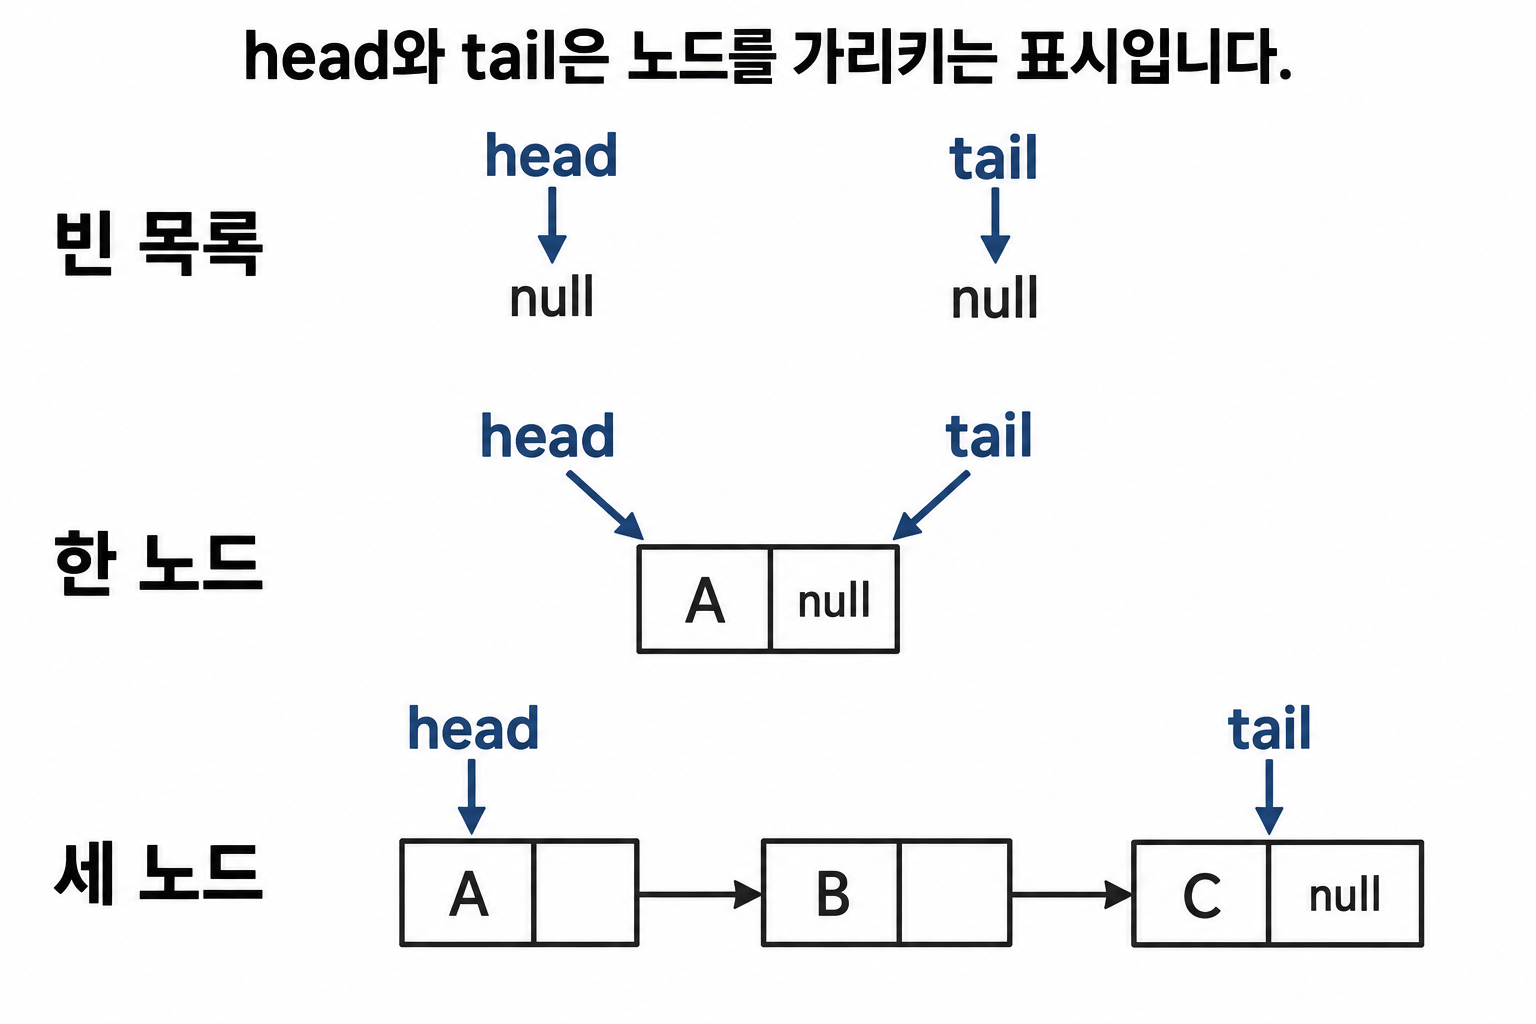
| 목록 | head가 가리키는 곳 | tail이 가리키는 곳 |
|---|---|---|
| 비어 있음 | null | null |
| A → null | A | A |
| A → B → null | A | B |
| A → B → C → null | A | C |
한 노드만 있을 때는 첫 노드와 마지막 노드가 같으므로 head와 tail이 같은 객체를 가리킵니다. head는 앞에서 읽을 때 필요합니다. tail은 끝에 새 노드를 붙일 때 필요합니다. tail이 없다면 마지막 노드를 찾기 위해 매번 처음부터 next를 따라가야 합니다.
6. 뒤에 붙일 때는 연결부터, 마지막 표시를 그다음에
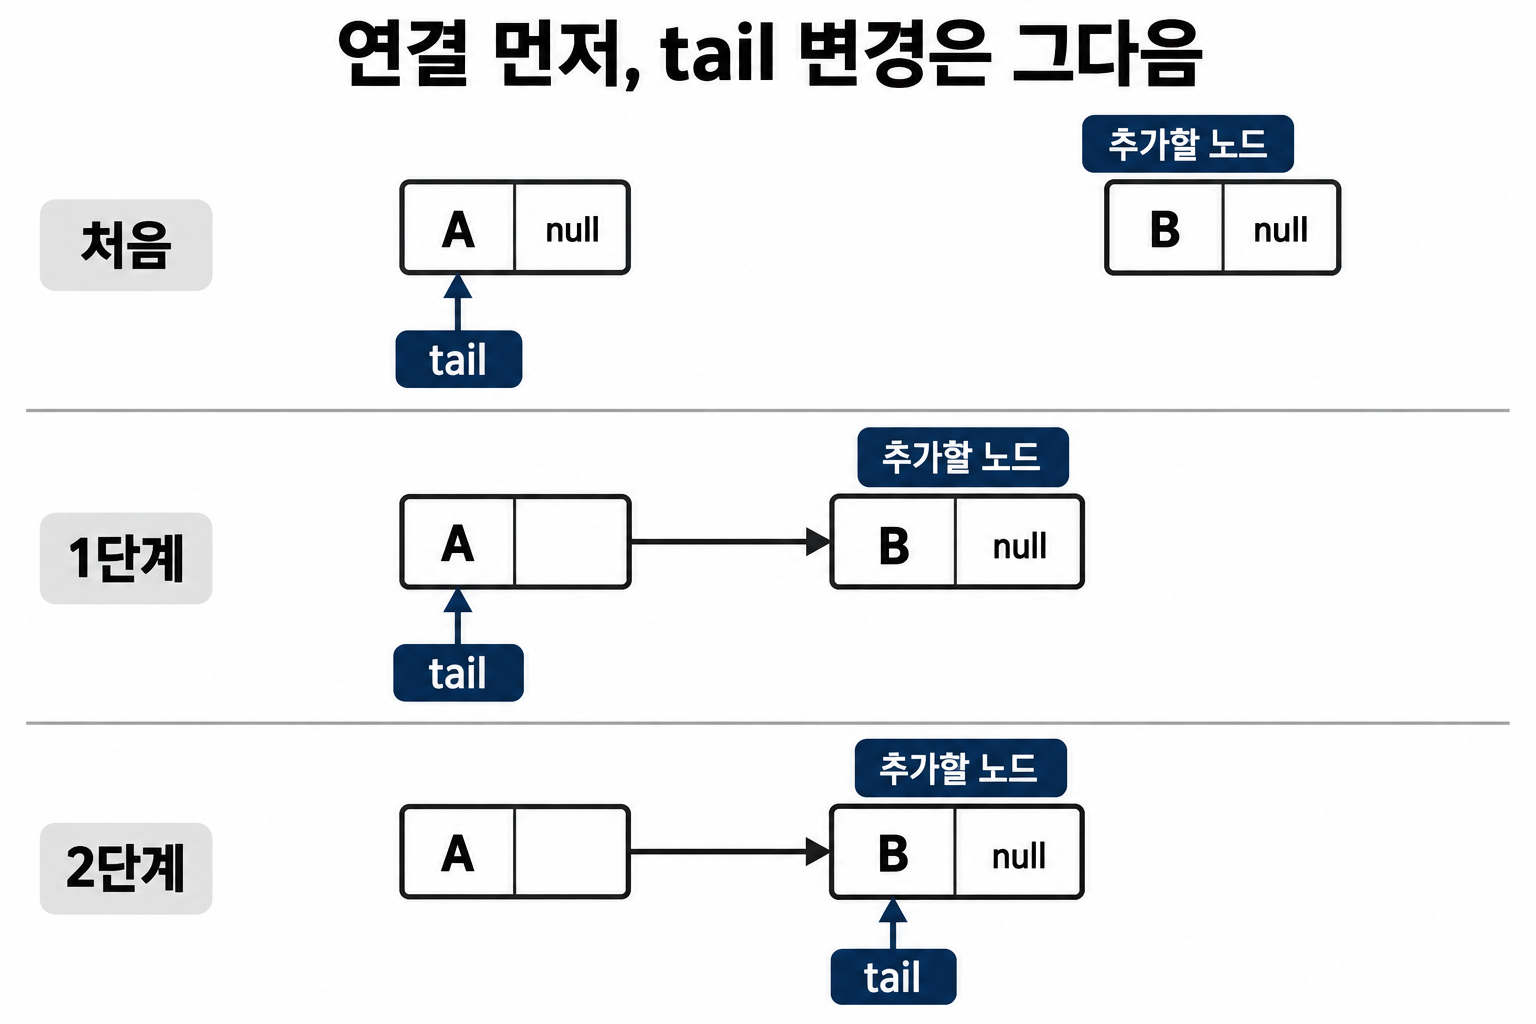
A 하나가 있을 때 B를 뒤에 붙여 보겠습니다. 해야 할 일은 두 가지입니다. 먼저 현재 마지막 A의 next를 B로 연결하고, 그다음 “이제 마지막은 B”라고 tail을 바꿉니다.
const start = { value: "A", next: null };
let tail = start;
const added = { value: "B", next: null };
tail.next = added;
tail = added;
console.log(start.next.value);
console.log(tail.value);
출력:
B
B
| 단계 | 목록의 연결 | tail |
|---|---|---|
| 처음 | A → null | A |
| tail.next = added | A → B → null | 아직 A |
| tail = added | A → B → null | B |
tail = added를 먼저 실행하면 tail은 이미 B입니다. 그 뒤 tail.next = added를 실행하면 B가 자기 자신을 가리키고, A와 B는 연결되지 않습니다. 그래서 기존 마지막 노드를 가리키고 있을 때 next를 먼저 바꾸어야 합니다.
목록이 비었을 때는 연결할 기존 마지막 노드가 없습니다. 이 경우 새 노드를 head로 정하고 tail도 같은 새 노드로 정하면 됩니다. 아래 전체 코드의 if (tail === null)이 바로 이 경우를 나눕니다.
7. 앞에서 꺼낼 때는 값을 먼저 기억합니다
A → B에서 A를 꺼내면 새 첫 노드는 B입니다. B의 위치를 계산할 필요는 없습니다. 기존 첫 노드의 next가 이미 B를 가리킵니다.
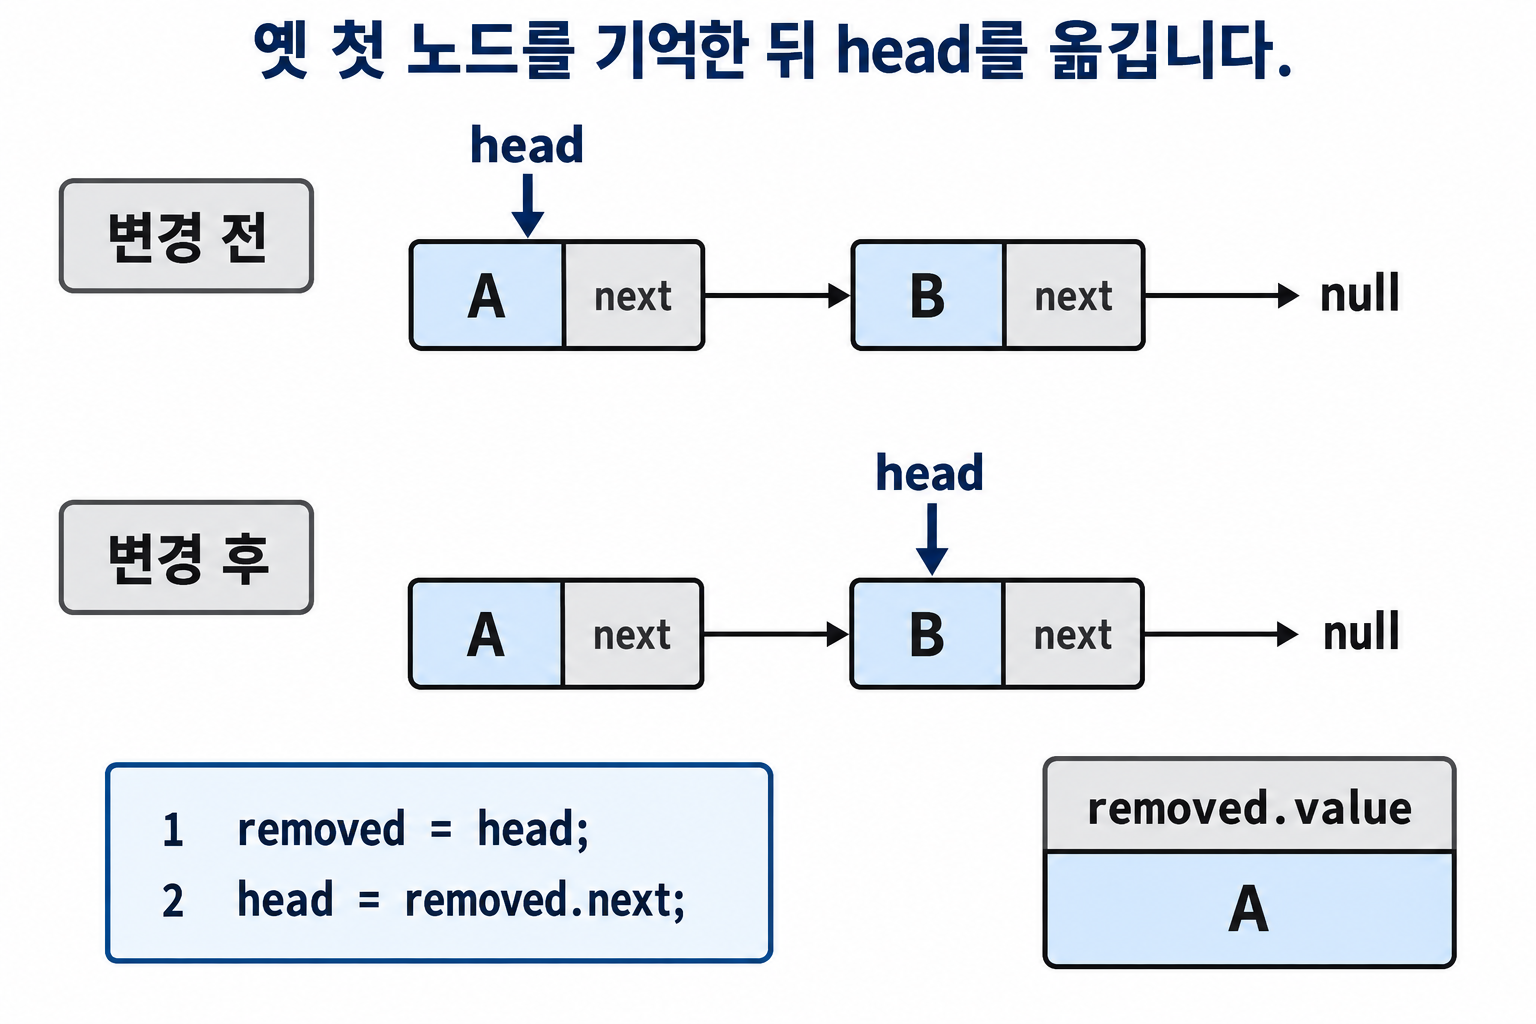
const last = { value: "B", next: null };
let head = { value: "A", next: last };
const removed = head;
head = removed.next;
console.log(removed.value);
console.log(head.value);
출력:
A
B
const removed = head로 기존 A를 먼저 기억하고, head = removed.next로 시작점을 B로 옮깁니다. 그러면 A를 반환하면서도 목록은 B에서 계속 읽을 수 있습니다. head를 먼저 바꾼 뒤 head.value를 반환하면 A가 아니라 B를 잘못 돌려주게 됩니다.
A 하나만 있는 목록에서 앞의 A를 꺼냈습니다. head는 null이 되었습니다. tail은 A를 그대로 가리켜도 될까요?
답과 이유 확인하기
아닙니다. 이제 마지막 노드도 없으므로 tail도 null로 바꿔야 합니다. tail에 옛 A가 남으면 다음 추가를 “이미 노드가 있는 목록”으로 잘못 처리할 수 있습니다. 빈 목록에서는 head와 tail이 함께 null입니다.
8. 뒤 추가와 앞 제거만 있는 전체 코드
오늘은 append(뒤에 추가), removeFirst(앞에서 꺼내기) 두 동작만 묶습니다. 문자열과 숫자만 저장하며 null은 빈 목록의 반환값으로 예약합니다. 같은 값을 두 번 추가하면 서로 다른 노드 두 개가 됩니다. 이 입력 약속을 검사하는 코드는 생략했습니다.
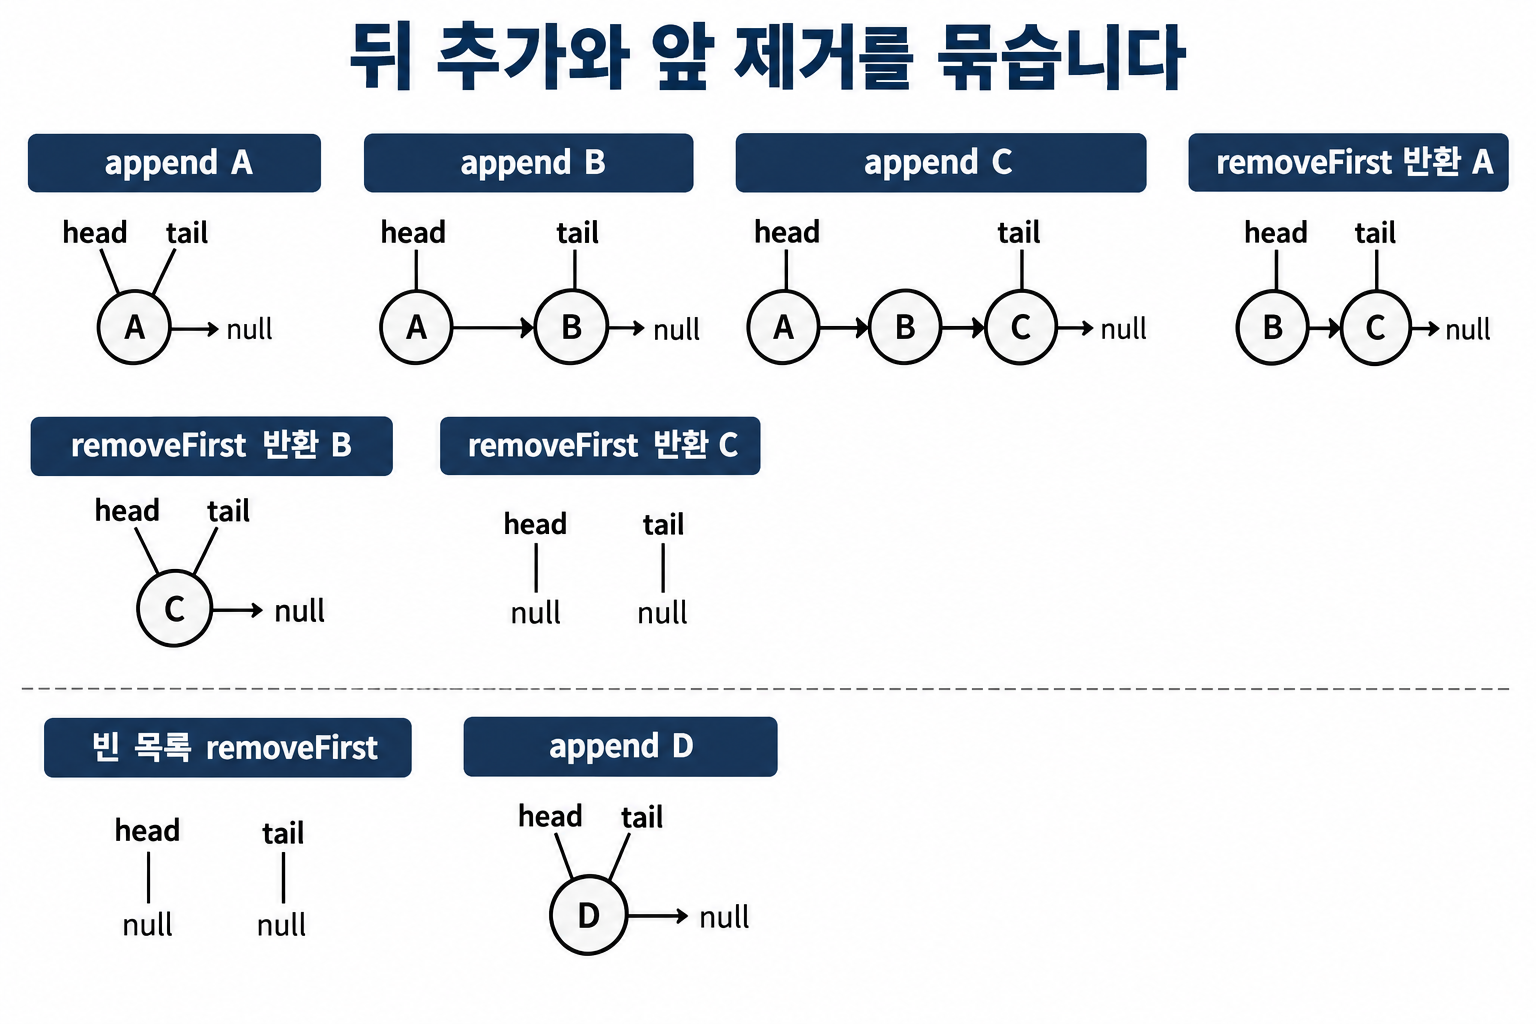
createList()는 head와 tail을 기억하며 두 함수를 묶어 돌려줍니다. list.append(“A”)처럼 호출하면 내부 연결이 바뀝니다. 아래는 사용 예제까지 포함한 전체 코드이며, 앞선 코드 블록을 실행하지 않았어도 단독으로 실행됩니다.
function createList() {
  let head = null;
  let tail = null;

  function append(value) {
    const node = { value, next: null };
    if (tail === null) {
      head = node;
    } else {
      tail.next = node;
    }
    tail = node;
  }

  function removeFirst() {
    if (head === null) return null;
    const firstNode = head;
    head = firstNode.next;
    if (head === null) tail = null;
    return firstNode.value;
  }

  return { append, removeFirst };
}

const list = createList();
list.append("A");
list.append("B");
list.append("C");
console.log(list.removeFirst());
console.log(list.removeFirst());
console.log(list.removeFirst());
console.log(list.removeFirst());
list.append("D");
console.log(list.removeFirst());
출력:
A
B
C
null
D
append 안의 새 node는 value와 next:null만 있으면 됩니다. 목록이 비었으면 head를 새 노드로 정하고, 그렇지 않으면 기존 tail.next로 이어 줍니다. 어느 경우든 마지막은 새 노드이므로 if 뒤에서 tail = node를 실행합니다.
removeFirst는 head가 null이면 즉시 null을 반환합니다. 노드가 있으면 그 노드를 firstNode에 보관하고 head를 다음으로 옮깁니다. 새 head까지 null이면 마지막 노드를 꺼낸 것이므로 tail도 null로 바꿉니다. 마지막 줄은 보관해 둔 옛 첫 노드의 값을 반환합니다.
return { append, removeFirst }는 밖에서 사용할 두 함수를 묶어 주는 줄입니다. 이 글의 완성 버전에서는 밖에서 head나 tail을 직접 바꾸지 않고 이 두 함수를 사용합니다. 앞선 수동 예제에서 직접 바꾸던 연결을 함수가 같은 순서로 대신 바꾸는 것입니다.
9. 비었다가 다시 추가하는 순간까지 확인합니다
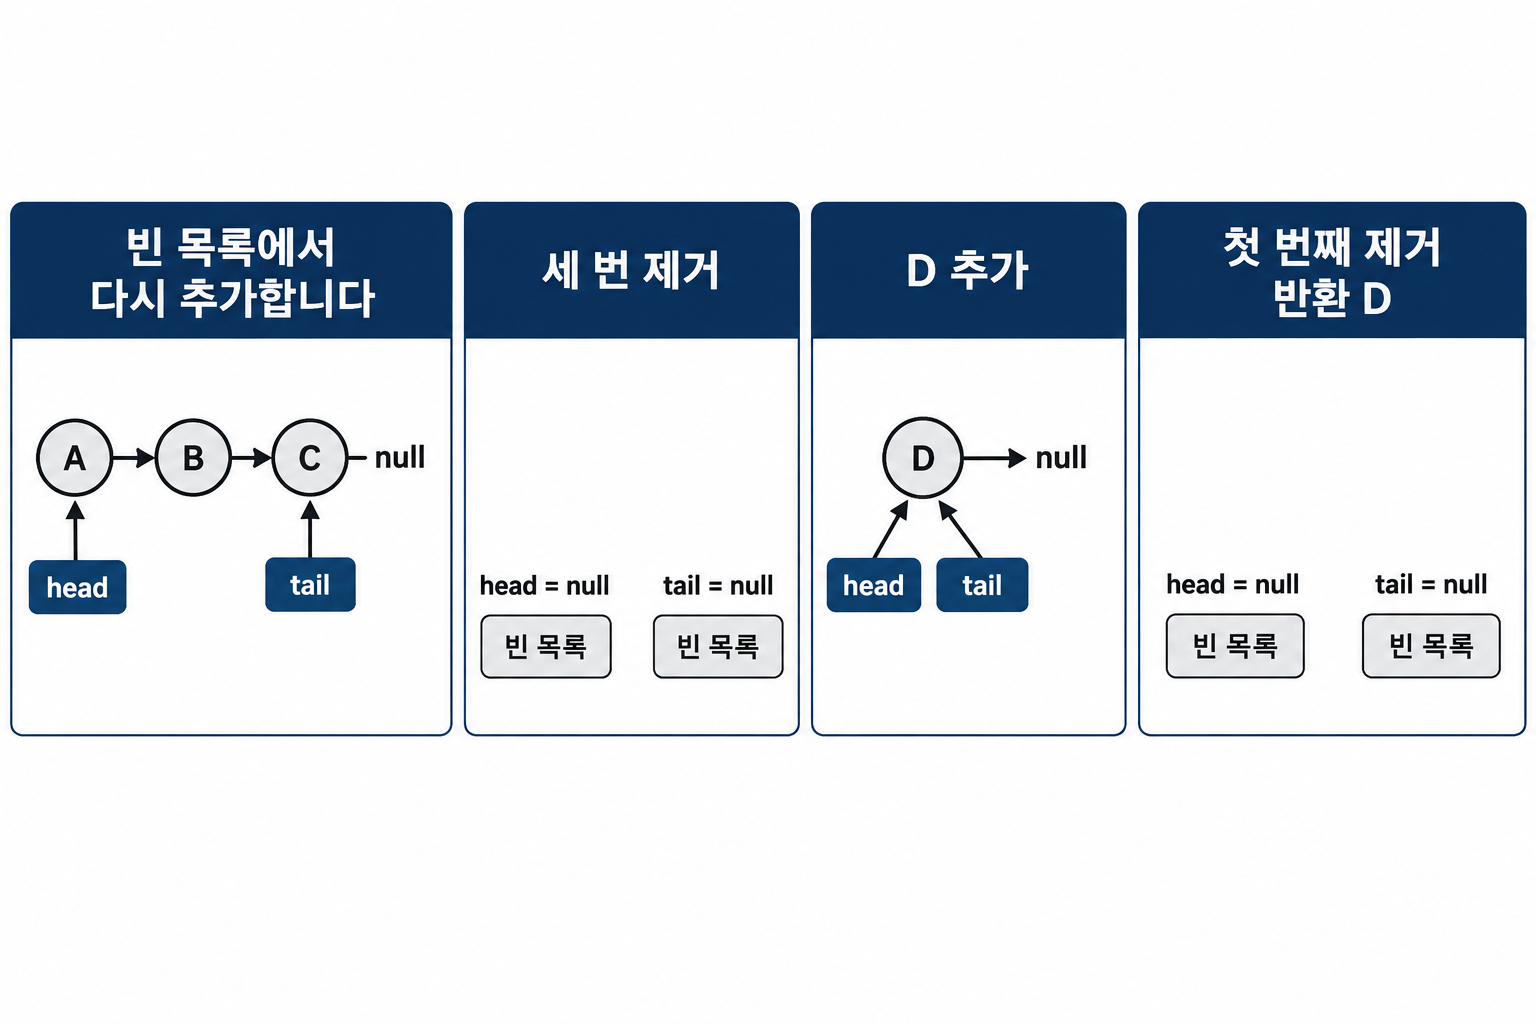
| 동작 | 남은 목록 | head | tail | 반환값 |
|---|---|---|---|---|
| A, B, C 추가 | A → B → C | A | C | 없음 |
| 첫 번째 removeFirst | B → C | B | C | A |
| 두 번째 removeFirst | C | C | C | B |
| 세 번째 removeFirst | 비어 있음 | null | null | C |
| 빈 상태에서 removeFirst | 비어 있음 | null | null | null |
| D 추가 | D | D | D | 없음 |
| 다시 removeFirst | 비어 있음 | null | null | D |
처음부터 모든 삭제 방법을 외울 필요는 없습니다. 먼저 이 표의 빈 목록 → 한 노드 → 여러 노드 → 빈 목록을 설명할 수 있으면 됩니다. 특히 첫 노드가 마지막 노드이기도 한 순간이 head와 tail을 함께 바꾸는 이유입니다.
바로 실행해 보는 핵심 예제
독자 질문: 앞에서 제거하고 뒤에 추가하는 목록은 어떻게 연결하나요?
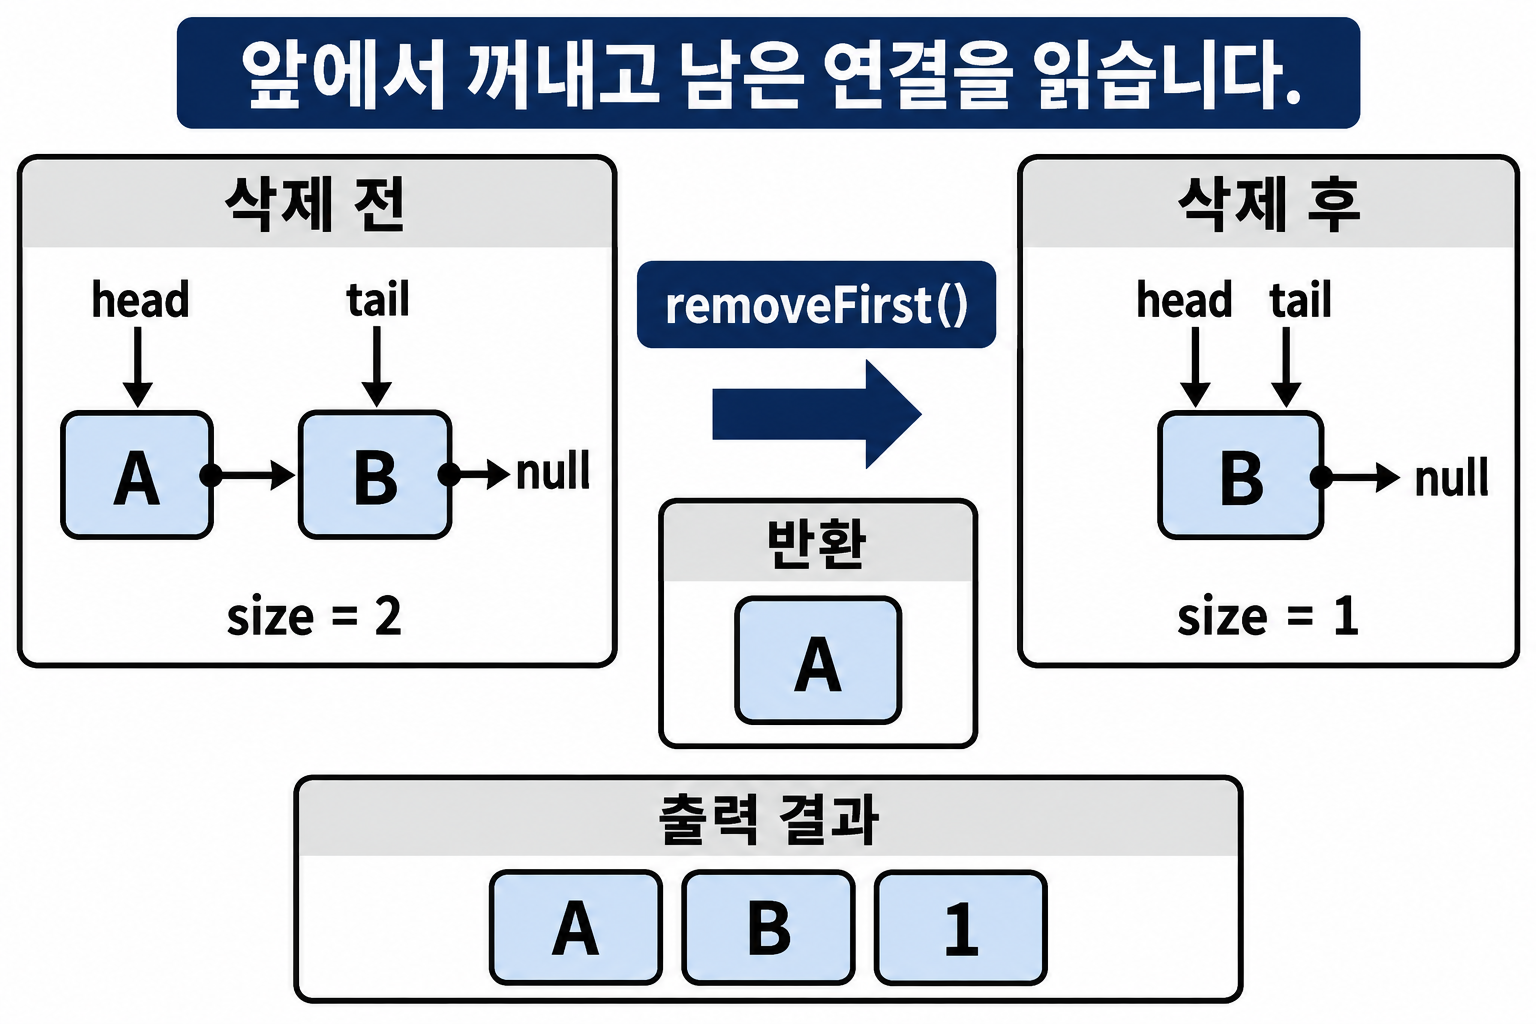
왜 쓰나요? head와 tail을 함께 유지하면 앞 제거와 뒤 추가의 연결 변경이 간단합니다.
아래 바닐라 JavaScript 코드는 독립 실행 예제입니다. 본문에서 배운 개념을 새 데이터로 확인합니다. 다른 예제와 같은 콘솔에 이어 붙이지 말고 새 콘솔 또는 새 .cjs 파일에서 실행하세요.
class List {
  head = null; tail = null; size = 0;
  append(value) {
    const node = { value, next: null };
    if (this.tail) this.tail.next = node;
    else this.head = node;
    this.tail = node; this.size++;
  }
  removeFirst() {
    if (!this.head) return undefined;
    const value = this.head.value;
    this.head = this.head.next;
    if (!this.head) this.tail = null;
    this.size--;
    return value;
  }
}
const list = new List();
list.append("A"); list.append("B");
console.log(list.removeFirst(), list.head.value, list.size);
실행 결과와 비용
이번 검토에서는 Node.js v24.18.0에서 위 독립 예제를 실행해 다음 출력과 일치하는지 확인했습니다.
A B 1시간·공간 복잡도: tail이 있으면 append와 removeFirst는 O(1), 특정 값 탐색은 O(n)입니다. 배열처럼 임의 인덱스 접근이 빠르다고 볼 수 없습니다.
직접 풀 문제
B도 removeFirst한 뒤 head·tail·size는?
풀이와 기대 결과
head=null, tail=null, size=0입니다. 마지막 항목 제거 후 tail을 남기면 불변식이 깨집니다.
원자료의 다른 학습 순서 (선택)
자료구조 과정 원래 순서의 다음 글: 07 양쪽 끝을 쓰는 원형 덱
검증 범위: 위 독립 예제의 출력만 로컬에서 확인했습니다. 이 글은 독립 자료구조 실습입니다. 실제 브라우저 표시와 모든 입력·플랫폼의 실행은 검증하지 않았습니다.
10. 재생 대기 목록 문제로 이어갑니다
재생 목록 앞곡 처리에서는 ADD를 append에, PLAY를 removeFirst에 대응시킬 수 있습니다. LIST는 항목을 꺼내지 않고 head부터 next를 따라가며 모든 곡을 읽는 추가 동작입니다. 우선 ADD와 PLAY만 손으로 처리한 뒤 LIST를 더해 보세요.
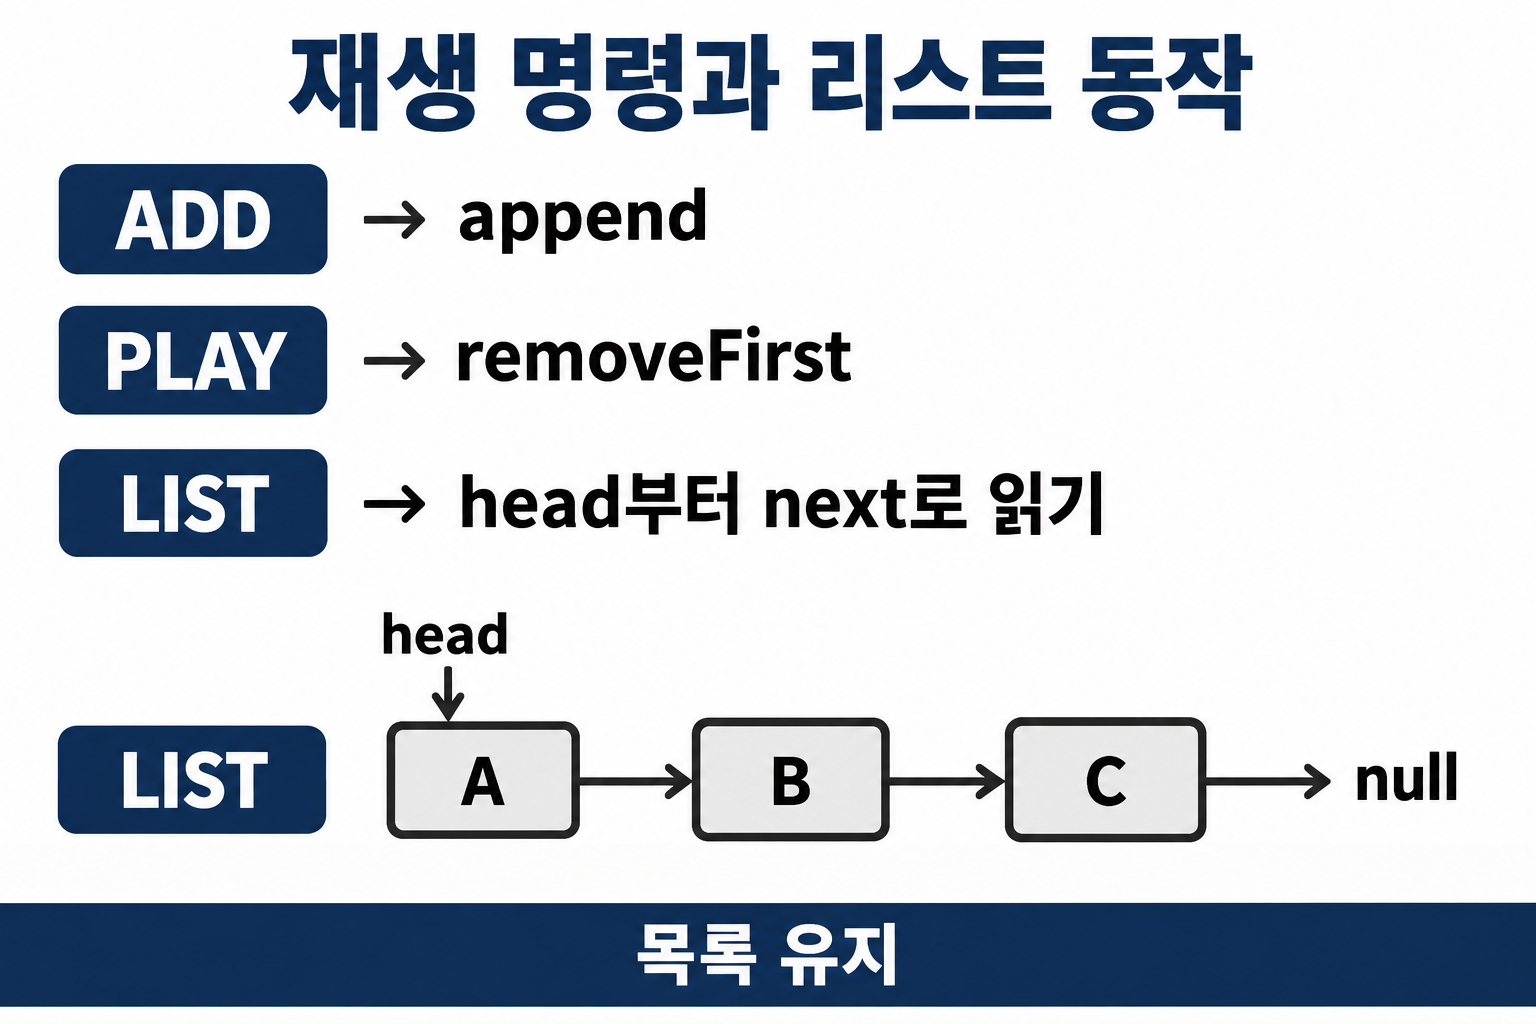
연결된 문제에는 입력 처리와 LIST까지 포함한 별도의 전체 정답이 있습니다. 그 정답의 빈 결과 표시는 {done:true}이고 이 글의 간단한 버전은 null입니다. 반환 형식을 그대로 섞지 말고 “비었는지 확인하고 첫 곡을 꺼낸다”는 같은 순서를 비교하세요.
더 알아보기: 중간 값 찾기와 삭제는 왜 따로 배울까요?
B를 이미 알고 있을 때 연결을 바꾸는 것은 짧았습니다. 하지만 이름 B만 주어지면 먼저 head부터 하나씩 찾아야 합니다. 중간 삭제에는 B 바로 앞 노드도 알아야 합니다. 그래서 find와 remove(value)는 앞 제거보다 단계가 더 많으며 이 글의 기본 구현에서는 다루지 않습니다.
뒤 추가와 앞 제거는 목록 전체를 훑지 않고 몇 개의 연결만 바꿉니다. 반대로 몇 번째 값을 바로 읽거나 전체 값을 출력하려면 next를 따라가야 합니다. 위치로 자주 읽는 작업에는 배열 글의 방식이 더 간단할 수 있습니다. 연결 리스트가 모든 작업에서 더 빠른 것은 아닙니다.
참고 연습
백준 1406 에디터는 커서 위치의 편집을 다루는 별도 문제입니다. 이 글의 두 메서드만으로 곧바로 해결되는 문제는 아니므로 재생 목록 연습 뒤에 살펴보세요. 외부 문제 지문과 예시는 옮기지 않았습니다.
중간 삽입·삭제는 직전 노드를 찾은 뒤 연결을 바꿉니다
A→C 사이에 B를 넣으려면 먼저 A를 찾습니다. 그다음 B.next를 기존 A.next인 C로 연결하고 마지막으로 A.next를 B로 바꿉니다. 순서를 뒤집어 기존 다음 노드를 잃으면 C 이후의 연결을 복원할 수 없습니다. B를 지울 때에는 A.next를 B.next인 C로 잇고, 지운 노드의 다음 참조를 떼어냅니다. 아래 독립 예제의 insertAt은 0≤index≤size, getAt·deleteAt은 0≤index<size인 정수 인덱스만 받습니다. deleteAt은 노드 객체 대신 저장한 값을 반환합니다.
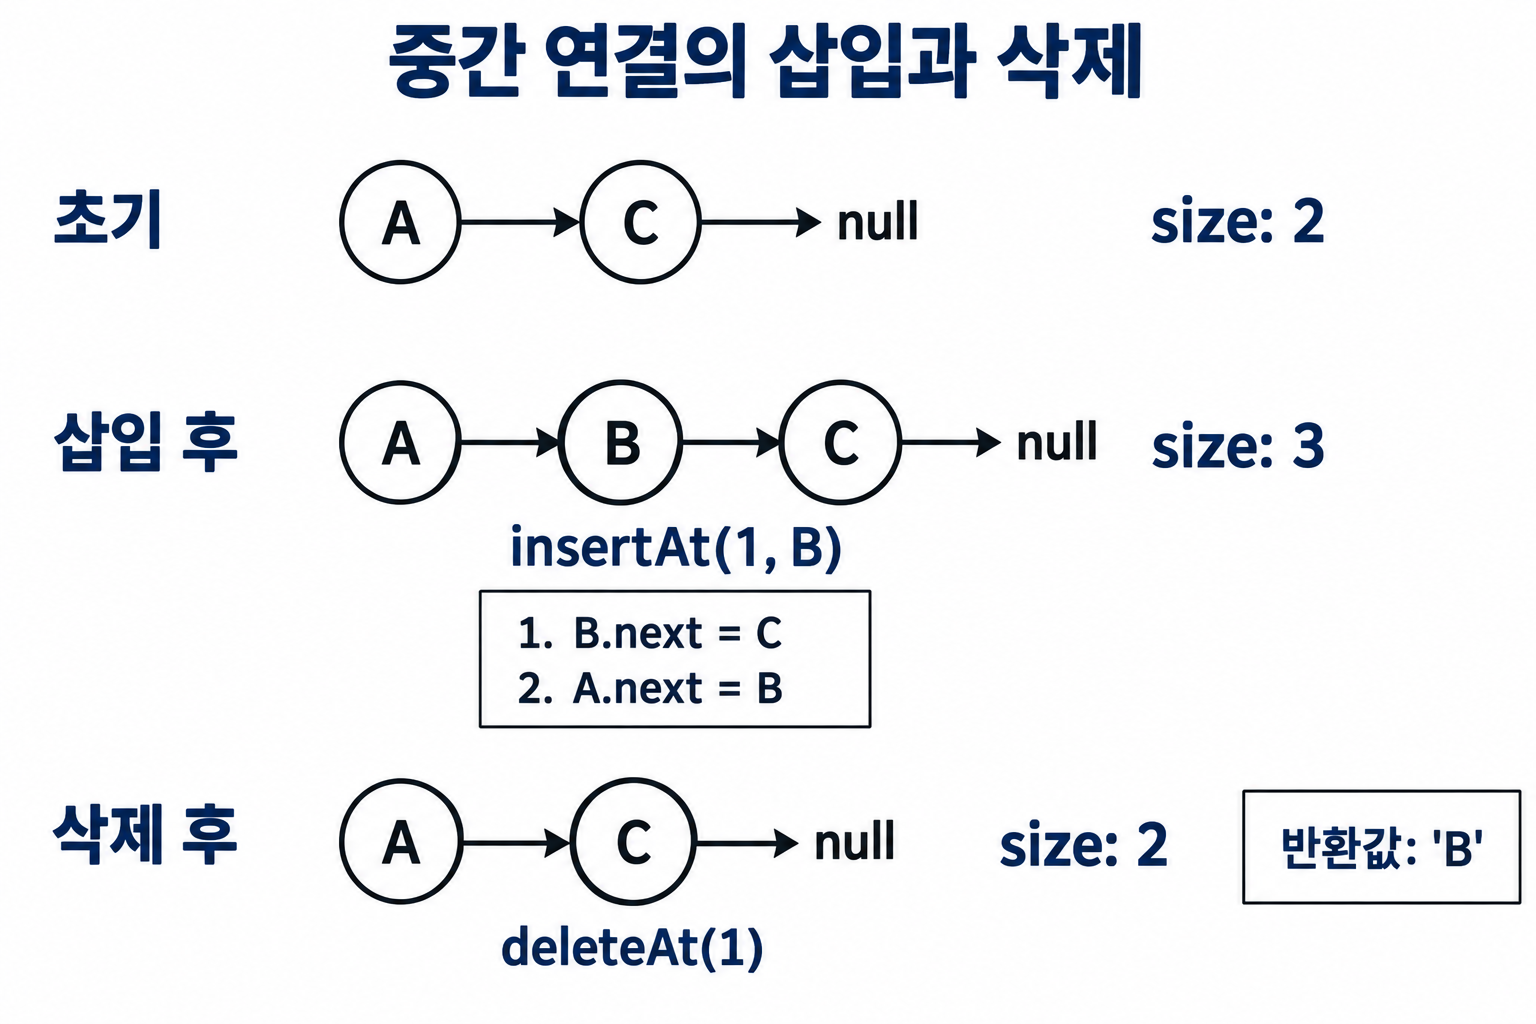
인덱스로 중간 위치를 찾는 데는 앞에서부터 O(N) 탐색이 필요합니다. 직전 노드를 이미 알고 있는 상태에서 연결 몇 개를 바꾸는 비용만 O(1)입니다. tail을 보관한 이 예제의 끝 삽입은 O(1)이지만, 단방향 리스트의 끝 삭제는 직전 노드를 찾아야 하므로 O(N)입니다. 마지막 원소를 지우거나 clear한 뒤에는 head·tail이 모두 null이고 size가 0이어야 합니다. 빈 상태에서 다시 한 개를 넣으면 head와 tail은 같은 새 노드를 가리켜야 합니다.
| 동작 | 리스트 | 크기 |
|---|---|---|
| 초기 | A→C | 2 |
| insertAt(1,B) | A→B→C | 3 |
| deleteAt(1) | A→C | 2 |
추가 예제 전체 코드와 실행 방법 펼치기
개념 확인 뒤 직접 실행할 때만 펼쳐 보세요. Node.js 시작 안내를 준비한 뒤 supplement-indexed-linked-list.mjs로 저장합니다.
class IndexedList {
  constructor() { this.head = null; this.tail = null; this.size = 0; }
  checkIndex(index, insertion = false) {
    const limit = insertion ? this.size : this.size-1;
    if (!Number.isInteger(index) || index < 0 || index > limit) {
      throw new RangeError('인덱스 범위를 벗어났습니다.');
    }
  }
  nodeAt(index) {
    this.checkIndex(index);
    let node = this.head;
    for (let i = 0; i < index; i++) node = node.next;
    return node;
  }
  getAt(index) { return this.nodeAt(index).value; }
  insertAt(index, value) {
    this.checkIndex(index,true);
    const fresh = {value,next:null};
    if (index === 0) {
      fresh.next = this.head;
      this.head = fresh;
      if (this.size === 0) this.tail = fresh;
    } else if (index === this.size) {
      this.tail.next = fresh;
      this.tail = fresh;
    } else {
      const previous = this.nodeAt(index-1);
      fresh.next = previous.next;
      previous.next = fresh;
    }
    this.size++;
    return this;
  }
  deleteAt(index) {
    this.checkIndex(index);
    let removed;
    if (index === 0) {
      removed = this.head;
      this.head = removed.next;
    } else {
      const previous = this.nodeAt(index-1);
      removed = previous.next;
      previous.next = removed.next;
      if (removed === this.tail) this.tail = previous;
    }
    this.size--;
    if (this.size === 0) this.head = this.tail = null;
    removed.next = null;
    return removed.value;
  }
  clear() { this.head = null; this.tail = null; this.size = 0; }
  toArray() {
    const values = [];
    for (let node = this.head; node !== null; node = node.next) values.push(node.value);
    return values;
  }
}

const list = new IndexedList();
list.insertAt(0,'A').insertAt(1,'C').insertAt(1,'B');
console.log(JSON.stringify(list.toArray()));
console.log(list.deleteAt(1));
console.log(JSON.stringify({values:list.toArray(),size:list.size,tail:list.tail.value}));
list.clear(); list.insertAt(0,'X');
console.log(JSON.stringify({values:list.toArray(),size:list.size,tail:list.tail.value}));
파일이 있는 폴더의 터미널에서 실행합니다.
node supplement-indexed-linked-list.mjs기대 출력
["A","B","C"]
B
{"values":["A","C"],"size":2,"tail":"C"}
{"values":["X"],"size":1,"tail":"X"}
첨부 test.mjs와 이중 연결 리스트의 양방향 링크를 추적합니다
dev.zip의 dev/test.mjs는 이름에 test가 있지만 assert로 통과·실패를 판정하는 자동 테스트가 아닙니다. console.log와 출력용 메서드로 결과를 관찰하는 시연 파일입니다. 아래에서 호출 뒤 남은 상태와 함수가 반환하는 값을 따로 읽어 보세요. 원본은 상대 모듈을 가져오므로 코드 한 조각만 콘솔에 붙이면 독립 실행되지 않습니다.
첫 부분은 리스트 클래스와 별개입니다. Node(1)·Node(2)·Node(3)을 만들고 node1.next=node2, node2.next=node3으로 이으면 세 번의 console.log가 1, 2, 3을 각각 보여 줍니다. 여기서 원본의 값 필드 이름은 data입니다. 본문 예제의 value와 이름을 섞지 않습니다.
| 호출 구간 | 남은 값의 순서 / count | 관찰할 결과 |
|---|---|---|
| insertAt(0,0)부터 insertAt(4,4)까지 | [0,1,2,3,4] / 5 | 삽입 위치가 매번 현재 count와 같아 맨 뒤에 붙습니다. printAll은 [0, 1, 2, 3, 4]를 출력합니다. |
| clear() | [] / 0 | head=null이 되고 printAll은 []를 출력합니다. |
| insertLast(0), insertLast(1), insertLast(2) | [0,1,2] / 3 | clear 뒤에도 새 목록을 만들 수 있는지 봅니다. |
| deleteAt(0) | [1,2] / 2 | 0이 든 Node를 반환하지만 원본 시연은 반환값을 출력하지 않습니다. |
| 그다음 deleteAt(1) | [1] / 1 | 삭제 후 바뀐 인덱스 1은 값 2입니다. 2가 든 Node를 반환합니다. |
| insertLast(5), deleteLast(), deleteLast() | [1,5] → [1] → [] / 2 → 1 → 0 | 두 삭제는 각각 data=5, data=1인 Node를 반환합니다. 출력은 마지막 []만 봅니다. |
| insertLast(1)부터 insertLast(5)까지, getNodeAt(2) | [1,2,3,4,5] / 5 | 0부터 세므로 인덱스 2는 세 번째 값 3입니다. secondNode라는 변수명이어도 두 번째 노드는 아닙니다. |
마지막 console.log(secondNode)는 숫자 3만 출력하는 코드가 아닙니다. data=3이고 next가 4, 그다음 5로 이어지는 Node 객체를 보여 줍니다. 객체 표시 모양은 실행 도구에 따라 달라질 수 있으므로 secondNode.data===3과 남은 연결을 기준으로 읽습니다. getNodeAt은 조회라서 count를 줄이지 않습니다.
| 구현 | 삽입·조회·삭제 계약 | 상태와 비용 |
|---|---|---|
| 첨부 LinkedList | insertAt/insertLast는 undefined, getNodeAt/deleteAt/deleteLast는 Node입니다. 잘못된 범위의 조회·삭제는 예외입니다. | head와 count를 보관하고 tail은 없습니다. 끝 삽입·끝 삭제도 앞에서 위치를 찾아 O(N)입니다. |
| 기존 보강 IndexedList | insertAt은 리스트 자신, getAt/deleteAt은 저장한 값입니다. | head·tail·size를 보관하므로 끝 삽입 O(1), 단방향 끝 삭제 O(N)입니다. |
원본 삭제는 남은 목록의 연결을 바꾸지만 반환 노드의 next를 떼어내지는 않습니다. [1,2]에서 앞 노드를 삭제하면 목록은 [2]가 되어도 반환 노드의 next.data는 여전히 2입니다. 본문의 IndexedList가 삭제 노드의 next를 null로 바꾸고 값만 돌려주는 방식과 구분하세요. 이 시연에는 빈 목록의 잘못된 삭제나 소수 인덱스 검증이 없으므로 정상 출력만으로 모든 경계를 검증했다고 볼 수 없습니다.
자기 확인: 첫 deleteAt 뒤에 인덱스 1이 가리키는 값은 무엇인가요?
2입니다. 목록이 [0,1,2]에서 [1,2]로 바뀌었기 때문입니다. 마지막 getNodeAt(2)는 3이 든 Node를 반환하고 count=5를 유지합니다.
지원 원본 DoublyLinkedList: next와 prev를 함께 잇습니다
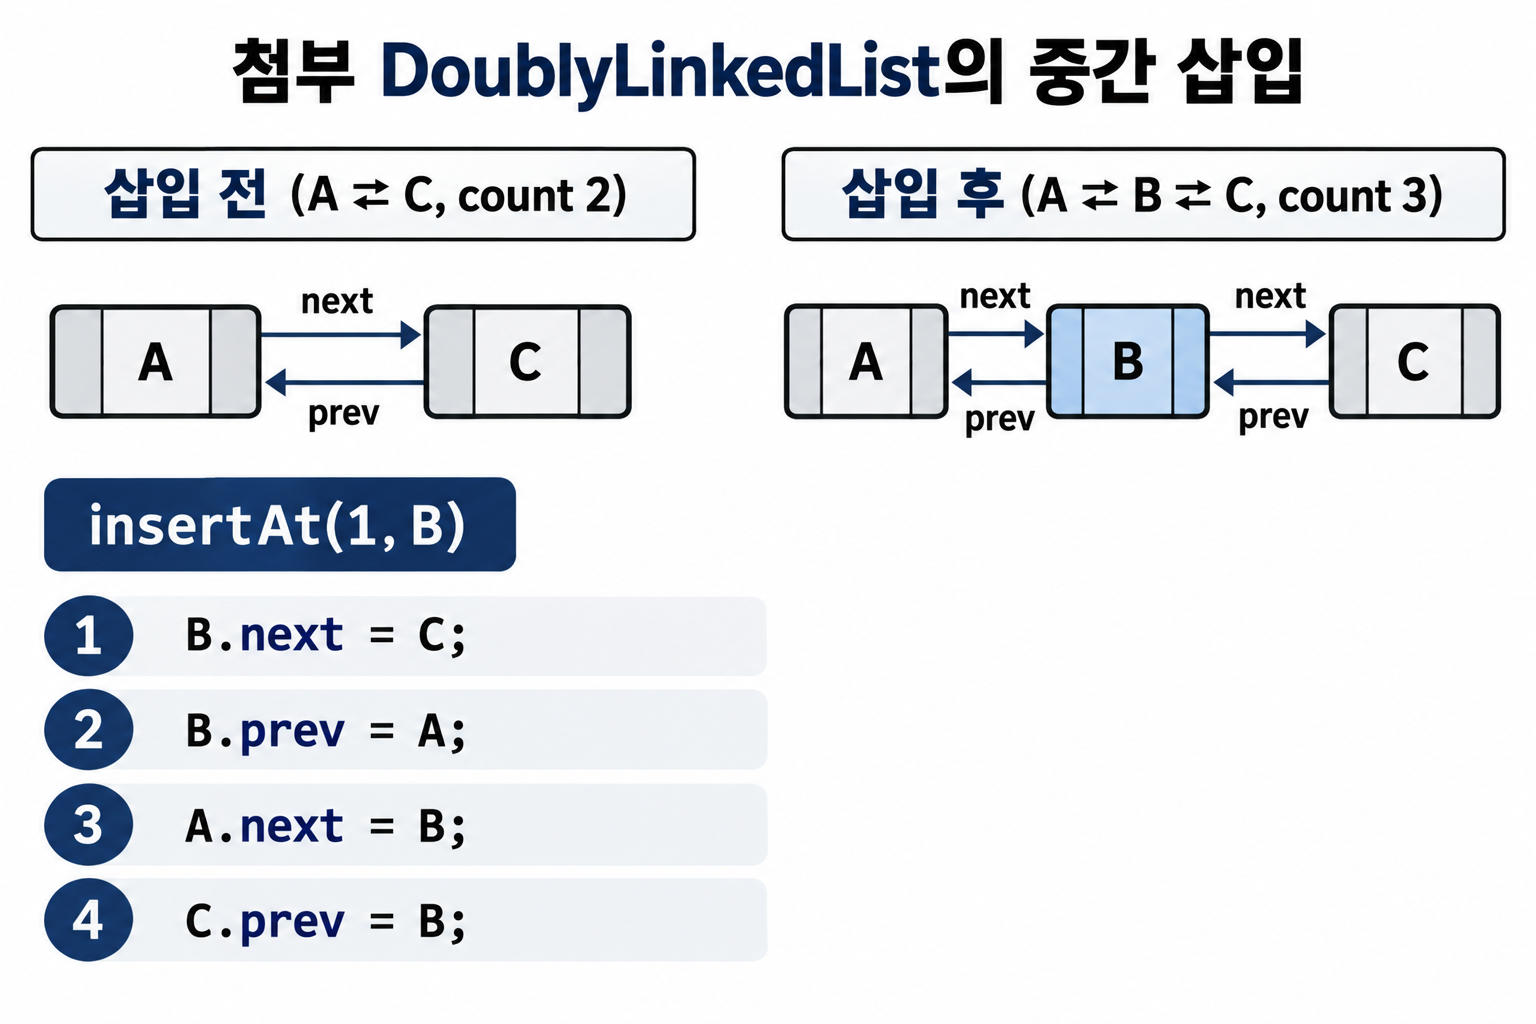
dev/DoublyLinkedList.mjs는 이중 연결 리스트입니다. 각 Node가 data와 함께 다음 노드 next, 이전 노드 prev를 저장합니다. A와 C가 서로 이어져 있으면 A.next===C인 동시에 C.prev===A여야 합니다. head부터 next로 읽은 [A,C]와 tail부터 prev로 읽은 [C,A]는 서로 반대 순서입니다. 이 지원 원본은 위 test.mjs가 사용하는 단방향 LinkedList와 별도 클래스이며 첨부 Queue·Deque·HashTable에서 사용합니다.
| 순서 | 원본에서 바꾸는 참조 | 이유 |
|---|---|---|
| 1 | newNode.next = currentNode.next | currentNode는 A이고 새 B의 next에 기존 오른쪽 C를 먼저 기억합니다. |
| 2 | newNode.prev = currentNode | B에서 왼쪽 A로 돌아갈 수 있게 합니다. |
| 3 | currentNode.next = newNode | A의 다음을 B로 바꿉니다. 기존 C는 B.next에 남아 있습니다. |
| 4 | newNode.next.prev = newNode | C의 이전도 B로 바꿉니다. A↔B↔C가 완성되고 count가 2에서 3으로 늘어납니다. |
A.next만 B로 바꾸고 C.prev를 A로 두면 앞으로는 A→B→C인데 뒤로는 C→A가 되어 두 방향이 어긋납니다. 반대로 먼저 A.next를 B로 바꾼 뒤 그 A.next에서 옛 C를 얻으려 하면 C를 잃습니다. 그래서 오른쪽 연결을 보관한 다음 양쪽 이웃이 새 B를 가리키게 만듭니다. 원본 insertAt/insertLast의 반환은 undefined이고, getNodeAt은 data 대신 Node를 돌려줍니다.
| 원본 호출·상황 | 연결 갱신과 반환 | 호출 뒤 상태 |
|---|---|---|
| A↔B↔C에서 deleteAt(1) | deletedNode에 B를 기억하고 A.next를 B.next인 C로 바꾼 뒤 C.prev를 A로 바꿉니다. B Node를 반환합니다. | 앞으로 [A,C], 뒤로 [C,A], count=2이며 head=A·tail=C입니다. |
| 빈 생성자에서 insertAt(0,A) | A.next와 A.prev는 null이고 head와 tail이 같은 새 A를 가리킵니다. | count=1, head===tail |
| 여러 노드에서 deleteAt(0) | head를 다음 노드로 옮기고 새 head.prev=null로 바꿉니다. | tail은 유지되며 count가 1 줄어듭니다. |
| 여러 노드에서 deleteLast() | 기존 tail.prev의 next를 null로 바꾸고 tail을 그 이전 노드로 옮깁니다. | head는 유지되며 새 tail.next=null입니다. |
| 한 노드에서 deleteAt(0) 또는 deleteLast() | head와 tail을 함께 null로 바꾸고 마지막 Node를 반환합니다. | count=0이며 다시 넣으면 head와 tail이 같은 새 Node가 됩니다. |
원본의 중간 삭제도 반환된 B의 prev와 next를 null로 지우지는 않습니다. A↔B↔C에서 B를 지운 뒤에도 removed.prev===A와 removed.next===C는 true입니다. 남은 목록은 A↔C로 올바르게 이어지지만, 반환 노드를 통해 남은 이웃에 접근할 수 있다는 별도 계약입니다. 본문의 값 반환 예제처럼 외부에서 링크를 볼 수 없는 방식과 구분하세요.
빈 상태에는 주의할 원본 차이도 있습니다. 생성자와 마지막 Node 삭제는 head·tail을 모두 null로 만들지만, 원본 clear()는 head=null·count=0만 설정하여 이전 tail 참조를 남깁니다. 따라서 원본 clear 직후까지 “양끝이 모두 null”이라고 설명하면 실제 코드와 다릅니다. 이후 insertAt(0,새 값)은 새 Node를 양끝으로 설정하지만, 그 전에 남아 있는 tail 참조가 없어졌다고 가정할 수는 없습니다. 학습용으로 clear를 개선한다면 tail도 null로 초기화하는 조건을 추가 검증해야 합니다.
두 방향 링크를 고치는 부분은 O(1)이지만 원본 insertAt·deleteAt의 가운데 위치 찾기는 head부터 걸으므로 O(N)입니다. tail을 직접 사용하는 끝 삽입·끝 삭제는 O(1)입니다. getNodeAt도 head부터 찾으며 이중 연결이라는 이유만으로 인덱스 조회가 O(1)이 되지는 않습니다.
자기 확인: A↔B↔C에서 B를 지울 때 A.next만 C로 바꾸면 충분한가요?
충분하지 않습니다. C.prev도 A로 바꿔야 양쪽 순회가 [A,C]와 [C,A]로 맞습니다. 원본은 두 참조를 갱신하지만, 반환한 B의 prev와 next는 남겨 둡니다.
직접 실습: 연산 비용으로 구조를 설명합니다
실습 주제: 단방향 연결 리스트: head·tail 삽입과 삭제
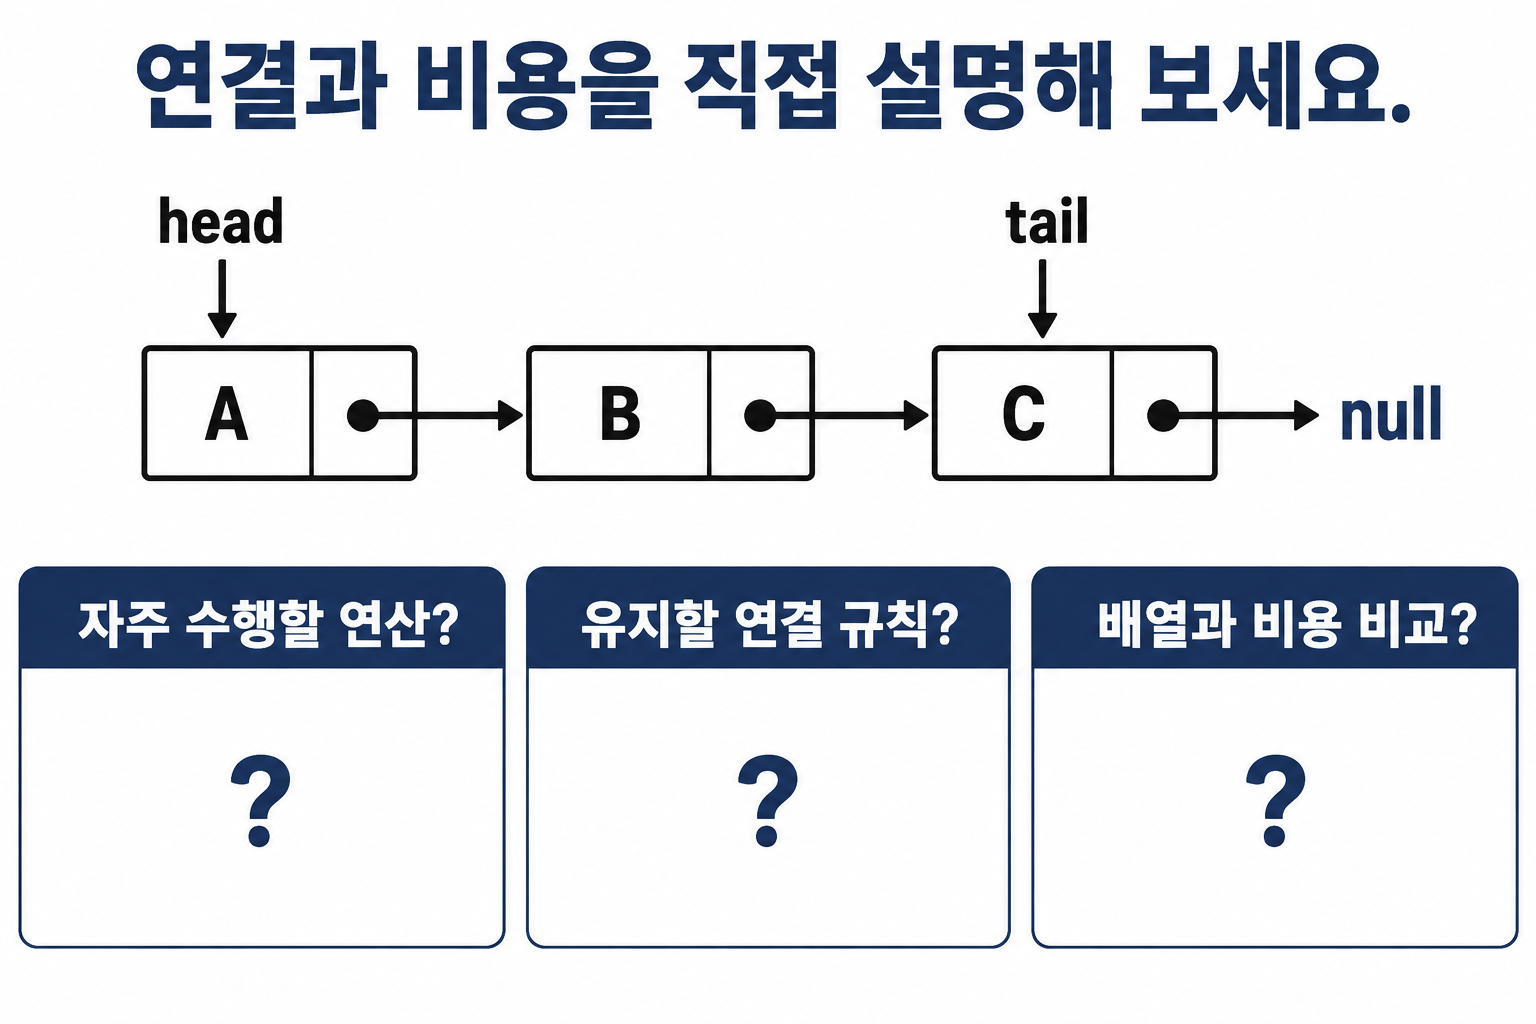
- 본문 구현에서 저장되는 값과 연결 관계를 그림으로 적습니다.
- 조회·삽입·삭제 중 이 구조가 가장 자주 수행할 연산을 고릅니다.
- 연산 전후에도 유지되어야 하는 규칙을 한 문장으로 적습니다.
- 배열이나 Map 같은 다른 구조로 바꿨을 때 시간·공간 비용을 비교합니다.
풀이 기준과 확인 결과
메서드 이름만 외우지 말고 한 번의 연산에서 어떤 값과 연결이 바뀌는지 추적하세요. 빈 구조, 원소 한 개, 중복값, 연속 삽입·삭제를 실행했을 때 본문이 설명한 불변식이 유지되면 성공입니다.
테스트 체크리스트
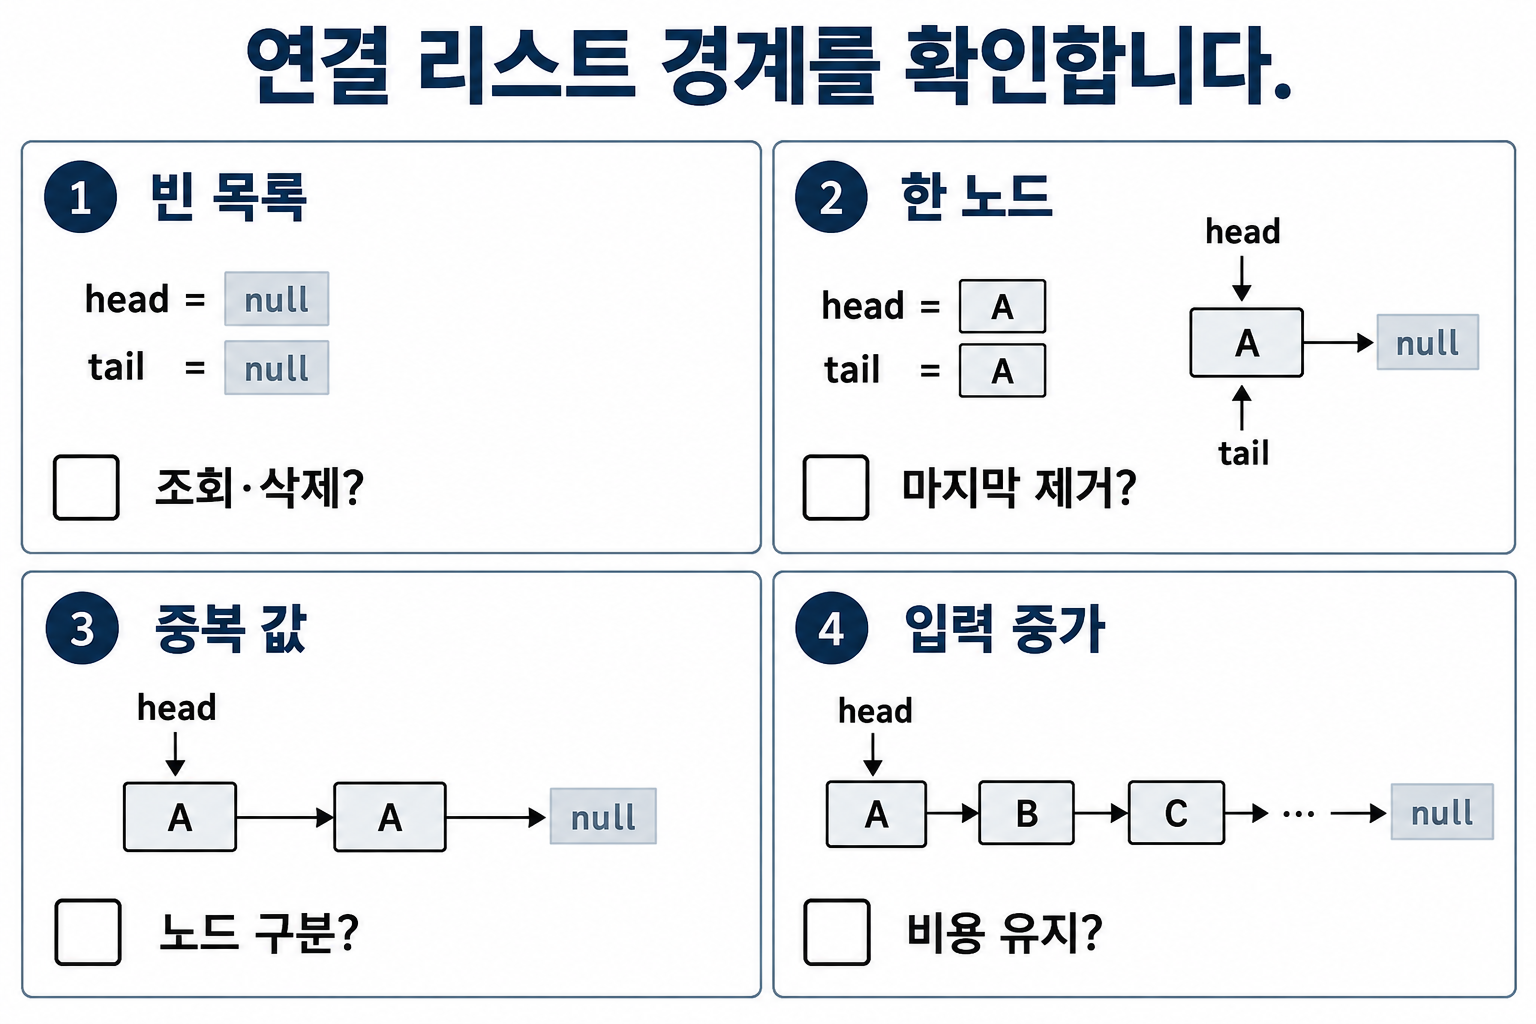
- 빈 구조에 대한 조회·삭제 처리
- 첫 원소와 마지막 원소 변경
- 중복값 또는 동일 우선순위 처리
- 입력 크기가 커졌을 때 예상 복잡도 유지
이 글이 도움이 되었나요?
이어서 공부하기
체크포인트: 예제의 상태 변화를 손으로 추적하고 아래 문제에 적용하세요. 값이 없는 경우와 원소 하나인 경우도 설명해 보세요. 삽입·제거 전후의 상태를 그리고, 내장 도구를 쓰는 풀이와 직접 구현의 목적을 구분하세요.
다음 추천 · 이 개념으로 풀 문제: 코딩테스트 연결 리스트: 재생 대기 목록 관리
권장 순서는 학습 가이드와 같습니다. 다른 순서는 접힌 참고 목록에서 확인할 수 있습니다. 읽음 표시는 숙달이나 채점 결과가 아닙니다.
원래 과정 목록 순서 (선택)
읽음 기록
읽음 — / 전체 23개 · 필수 23개
새 글 받아보기
RSS 리더에서 BlogFlow의 새 글을 확인할 수 있습니다.
