선택 정렬은 남은 구간의 최솟값을 찾아 어떻게 앞자리를 확정하나요?
선택 정렬은 아직 정렬하지 않은 구간에서 가장 작은 값을 찾아 맨 앞과 바꿉니다. 후보를 찾는 동안에는 배열을 건드리지 않고, 탐색이 끝난 뒤 한 자리를 확정합니다.
적용 조건·범위: 분석 조건: 원본을 유지하기 위한 반환 복사본을 포함합니다. 비교는 n(n - 1)/2번이며, 교환은 최대 n - 1번입니다. 표준 교환 방식은 안정 정렬이 아닙니다.
읽기 전에 알아두면 좋아요
아래 개념이 익숙하면 본문을 바로 읽으세요. 낯선 개념만 링크에서 복습하면 됩니다.
- 기초 구현 패턴: 조건·정수 계산·순회·상태 갱신변수에 값을 담고 조건에 따라 합·개수·최솟값을 갱신하는 기초부터 확인합니다.
- 완전탐색과 쌍 비교: 중복 없는 후보 열거와 순위 계산완전탐색은 가능한 후보를 빠짐없이 살펴보고 비교하는 방법입니다.
개념과 예제는 실행하지 않아도 읽을 수 있습니다. 내 컴퓨터·터미널에서 직접 실행하는 과정은 선택 실습입니다.
과정 위치와 선택 복습 안내
과정 위치: 정렬의 원리와 불변식 · 알고리즘 개념
과정 위치는 이 글이 속한 묶음입니다. 이 단계의 모든 개념을 먼저 읽을 필요는 없습니다. 위에 연결한 개념 중 낯선 내용만 복습하세요. 문제의 조건·상태·갱신 순서는 익숙한 언어로 설명하면 됩니다.
JavaScript로 문법·실행 복습하기 (선택)
개념 글의 코드는 JavaScript 예시입니다. 문제 화면에서는 JavaScript·Python·Java·C++·C# 중 익숙한 언어의 함수를 작성하세요. 본문의 Node.js 입출력 예시는 로컬 실행을 위한 별도 안내입니다.
선택 정렬은 아직 정렬하지 않은 구간에서 가장 작은 값을 찾아 맨 앞과 바꿉니다. 후보를 찾는 동안에는 배열을 건드리지 않고, 탐색이 끝난 뒤 한 자리를 확정합니다.
선수 지식: 배열 순회, 최솟값 갱신, 이중 반복문
- 최솟값의 값 대신 인덱스를 기억하는 이유를 이해합니다.
- 이미 확정된 앞부분과 탐색할 뒷부분을 나눕니다.
- 교환이 적어도 비교가 이차 시간인 이유를 설명합니다.
이번에 채울 자리와 최솟값 후보를 구분합니다
[4, 2, 1, 3]의 인덱스 0을 채우려면 전체에서 가장 작은 값 1을 찾아야 합니다. 처음에는 인덱스 0의 4를 후보로 삼고, 2를 만나면 후보를 인덱스 1로 바꿉니다. 1을 만나면 인덱스 2로 다시 바꿉니다. 3은 1보다 작지 않으므로 후보를 유지합니다. 구간을 끝까지 보아야 1이 이번 구간의 최솟값이라고 확정할 수 있습니다.
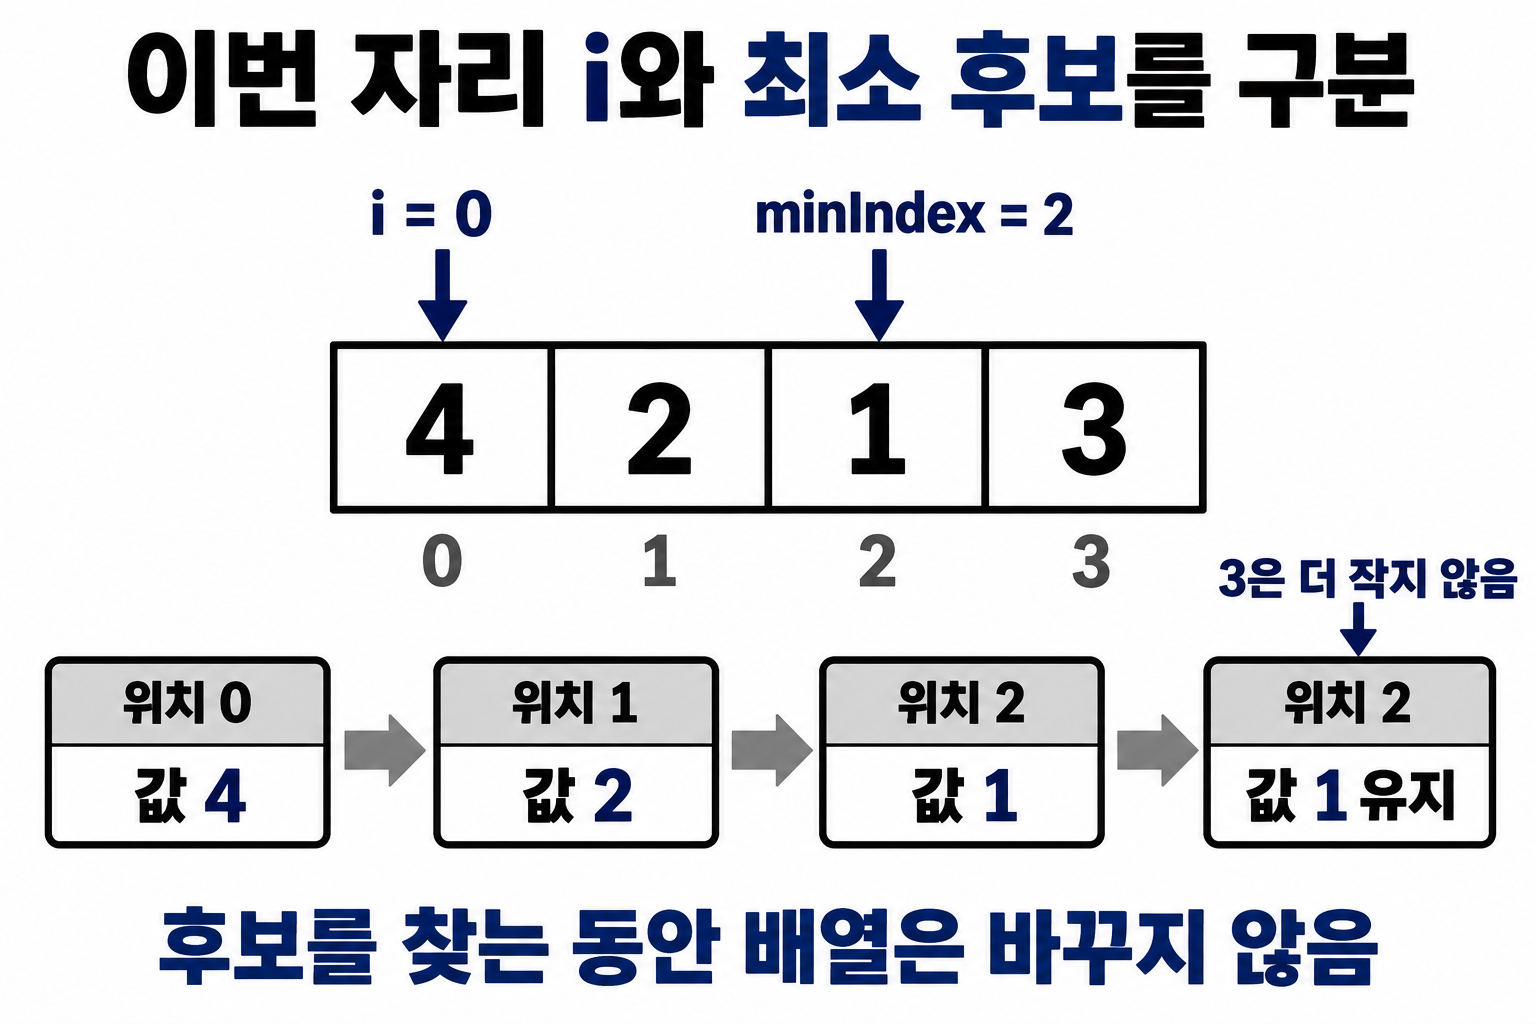
코드에서 i는 이번에 확정할 자리이고 minIndex는 지금까지 찾은 최솟값의 위치입니다. 숫자 최솟값만 저장하면 그 값을 원래 어디에서 가져와야 하는지 별도로 다시 찾아야 합니다. 위치를 저장하면 탐색 후 a[i]와 a[minIndex]를 곧바로 교환할 수 있습니다. 이 두 인덱스는 같은 값일 수도 있습니다.
후보를 찾는 도중에는 배열을 바꾸지 않습니다. 더 작은 후보를 찾을 때마다 바로 교환하는 방식은 비교하면서 작은 값을 끌고 오는 다른 동작입니다. 여기서는 한 구간의 최솟값을 선택한 뒤 최대 한 번 교환한다는 규칙을 유지합니다. 탐색과 배치를 나누어 읽으면 한 패스의 목적이 분명해집니다.
앞부분은 확정하고 뒷부분만 다시 찾습니다
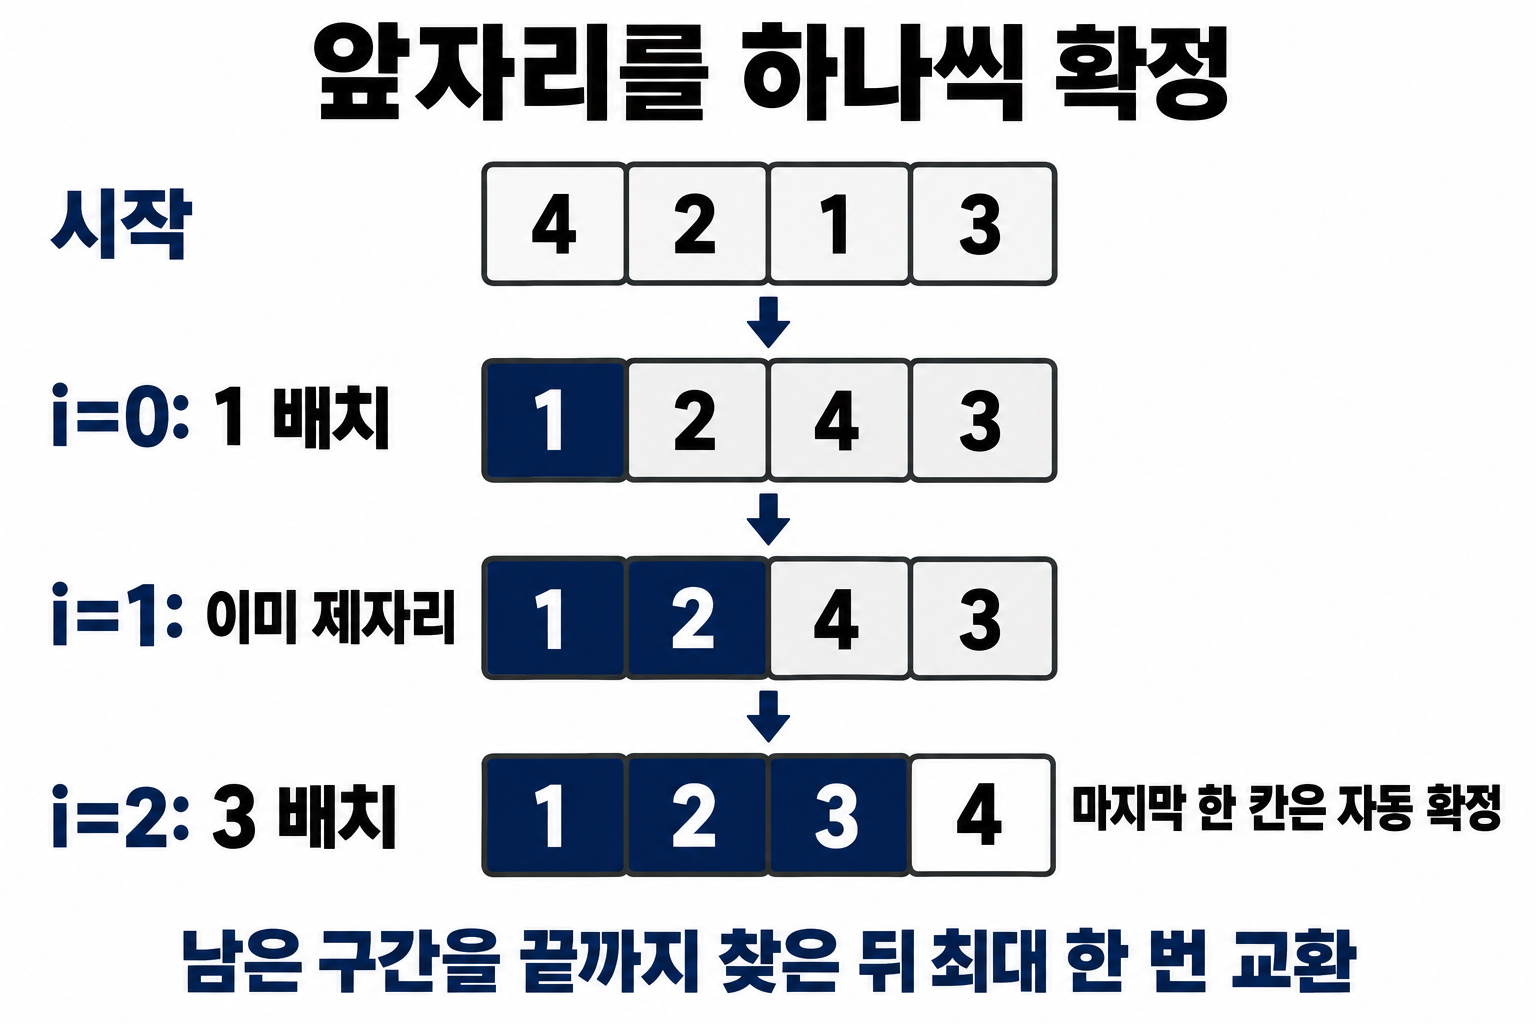
| 채울 위치 | 남은 구간의 최솟값 | 배치 후 배열 |
|---|---|---|
| i = 0 | 인덱스 2의 1 | [1, 2, 4, 3] |
| i = 1 | 인덱스 1의 2 | [1, 2, 4, 3] |
| i = 2 | 인덱스 3의 3 | [1, 2, 3, 4] |
첫 교환에서 원래 앞에 있던 4는 사라지지 않고 1이 있던 인덱스 2로 갑니다. 이제 1은 모든 원소 중 가장 작아 최종 위치가 맞습니다. 다음 패스에서는 1을 제외한 인덱스 1부터 끝까지만 찾습니다. 두 번째 패스에서는 2가 이미 제자리이므로 교환을 건너뜁니다. 남은 한 원소는 앞자리들이 확정되면 자동으로 맞으므로 마지막 인덱스에서 새 탐색을 할 필요가 없습니다.
후보의 규칙과 확정 구간의 규칙을 나눠 봅니다
안쪽 반복문이 인덱스 j를 보기 직전에는 minIndex가 i부터 j – 1까지 본 원소의 최솟값을 가리킵니다. 새 원소가 더 작으면 후보를 바꾸고, 아니면 유지하므로 이 규칙이 다음 비교에도 이어집니다. 마지막 원소까지 비교한 뒤에는 남은 구간 전체의 최솟값을 찾았다는 결론이 나옵니다.
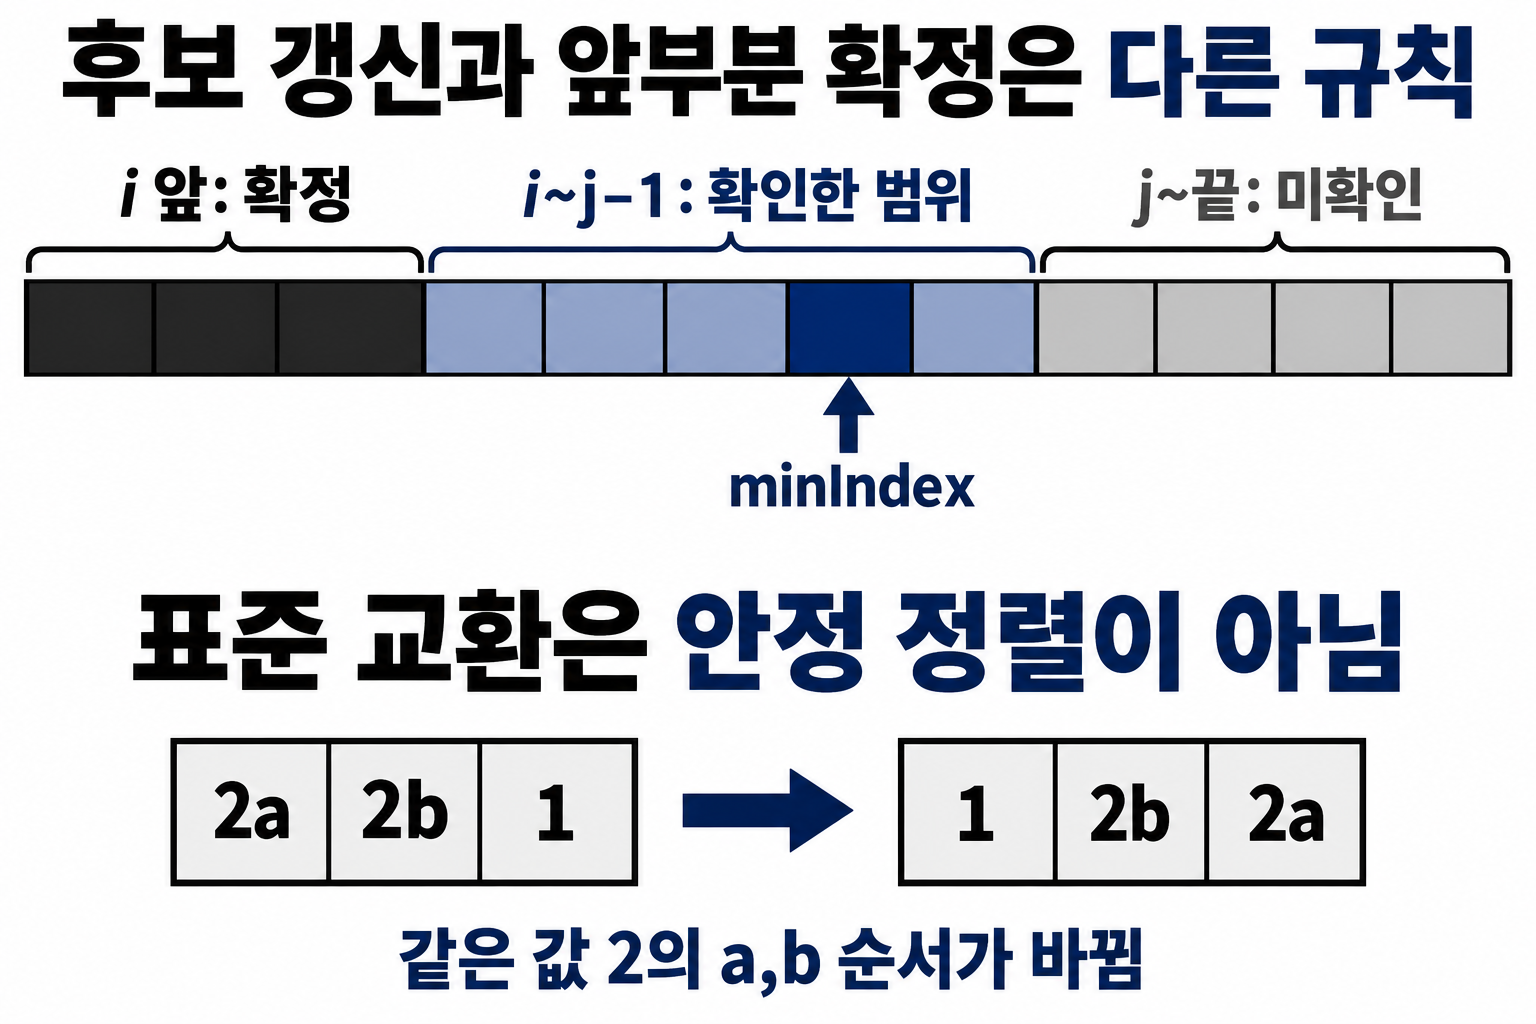
바깥 반복문에서는 인덱스 i 앞의 값들이 이미 오름차순으로 확정되어 있고, 남은 모든 값보다 작거나 같습니다. 이번 최솟값을 i에 넣으면 확정 구간이 한 칸 늘어납니다. 후보 갱신 규칙과 확정 구간 규칙은 서로 다른 범위를 설명합니다. 안쪽에서 무엇을 보장해야 바깥쪽 결과가 성립하는지 연결하면 코드의 정확성을 설명할 수 있습니다.
최솟값 후보를 같은 값으로 바꾸지 않더라도 표준 교환 방식은 안정 정렬이 아닙니다. 같은 값 2에 a, b를 붙인 [2a, 2b, 1]을 생각하면 첫 교환 뒤 [1, 2b, 2a]가 되어 같은 값의 원래 순서가 뒤집힙니다. 현재 예제는 숫자만 받지만, 이름표가 있는 항목을 정렬할 때는 이 성질이 중요합니다.
교환 수와 비교 수는 다른 비용입니다
각 자리에서 남은 구간을 전부 살피므로 비교 수는 (n - 1) + (n - 2) + … + 1입니다. 처음부터 정렬되어 있어도 더 작은 값이 뒤에 없는지 끝까지 확인하므로 최선·평균·최악 시간 모두 O(n²)입니다. 반면 교환은 각 패스에 최대 한 번이어서 O(n)번입니다. 교환을 줄였다는 설명을 전체 시간이 선형이라는 뜻으로 읽으면 안 됩니다.
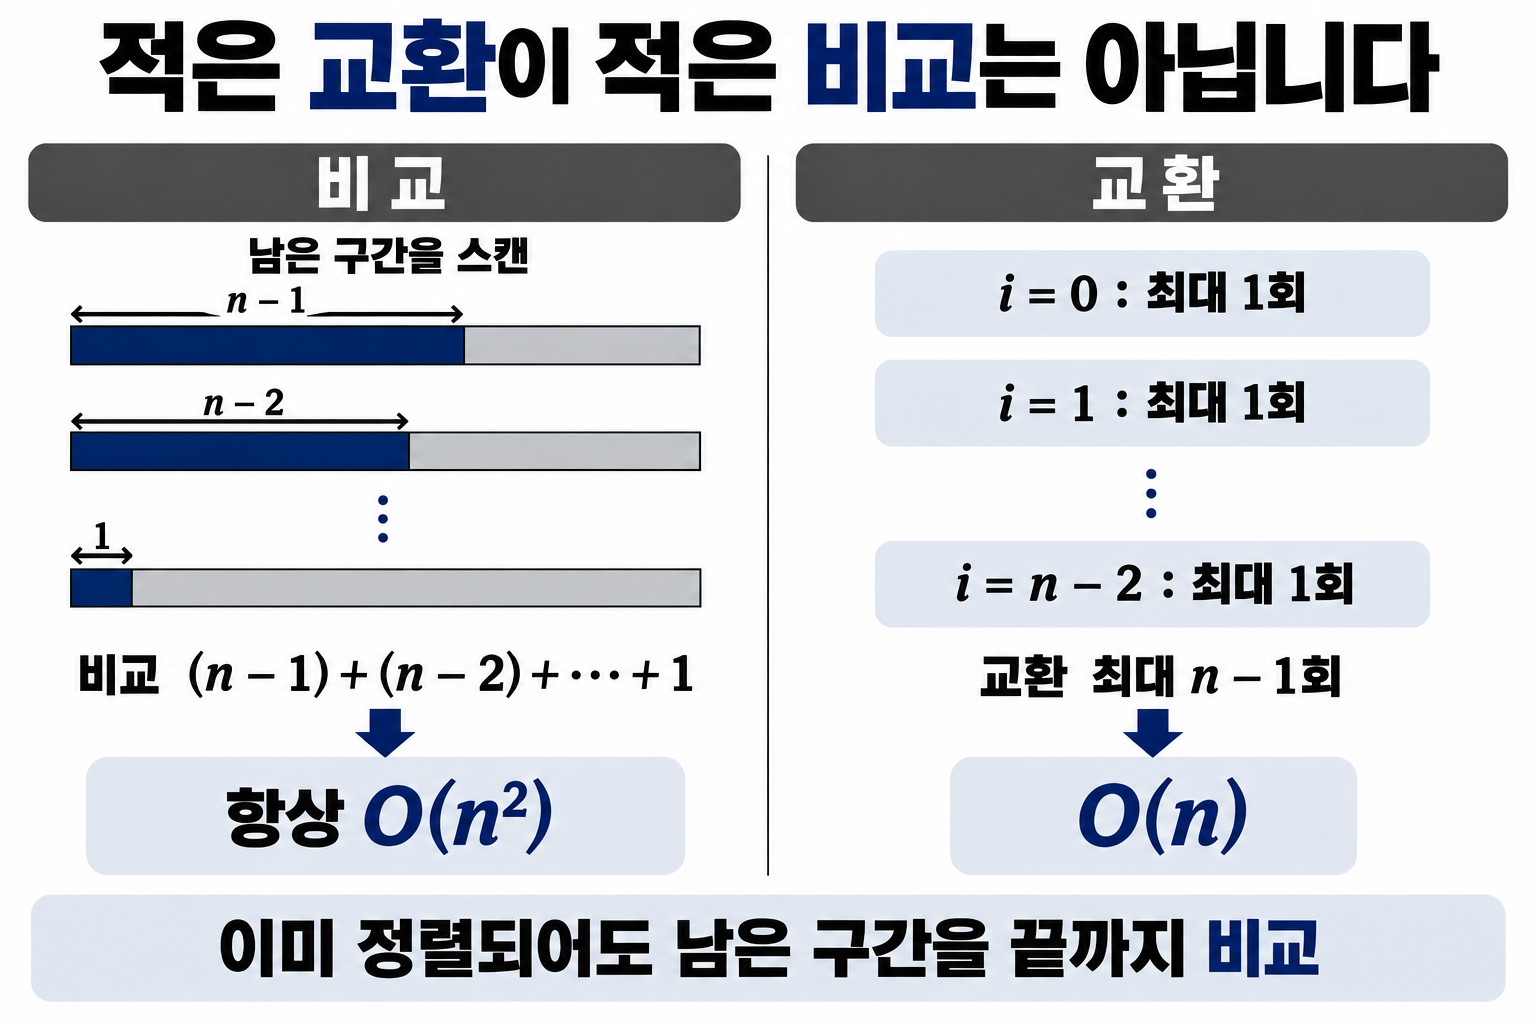
함수는 빈 칸 없는 유한 숫자 배열을 받아 새 오름차순 배열을 반환하고 원본은 유지합니다. 빈 배열과 한 원소도 허용하며, 음수·중복값은 숫자의 크기로 비교합니다. NaN이나 문자열은 같은 비교 의미를 보장하기 어려워 거절합니다. 복사본을 포함한 공간은 O(n)이고, 복사 이후 최솟값 인덱스와 교환에 필요한 공간은 O(1)입니다.
전체 코드와 직접 실행
개념을 읽었다면 아래 예제를 직접 실행하며 상태 변화를 확인할 수 있습니다.
전체 JavaScript 코드와 실행 방법 펼치기
별도 패키지는 필요하지 않습니다. Node.js가 처음이라면 브라우저와 Node.js 시작 안내부터 확인하세요.
javascript-selection-sort-minimum.mjs 파일을 만들고 아래 전체 코드를 저장합니다.
function copyFiniteNumbers(values) {
  if (!Array.isArray(values)) throw new TypeError('숫자 배열이 필요합니다.');
  for (let i = 0; i < values.length; i++) {
    if (!Object.hasOwn(values, i) || !Number.isFinite(values[i])) {
      throw new TypeError('빈 칸 없는 유한 숫자 배열이 필요합니다.');
    }
  }
  return values.slice();
}

function selectionSort(values) {
  const a = copyFiniteNumbers(values);
  for (let i = 0; i < a.length - 1; i++) {
    let minIndex = i;
    for (let j = i + 1; j < a.length; j++) {
      if (a[j] < a[minIndex]) minIndex = j;
    }
    if (minIndex !== i) [a[i], a[minIndex]] = [a[minIndex], a[i]];
  }
  return a;
}

const input = [4, 2, 1, 3];
console.log(JSON.stringify(selectionSort(input)));
console.log(JSON.stringify(input));
console.log(JSON.stringify(selectionSort([-1, 2, -1])));
파일이 있는 폴더의 터미널에서 실행합니다.
node javascript-selection-sort-minimum.mjs기대 출력
[1,2,3,4]
[4,2,1,3]
[-1,-1,2]
비용과 적용 범위
시간: 최선·평균·최악 O(n²)
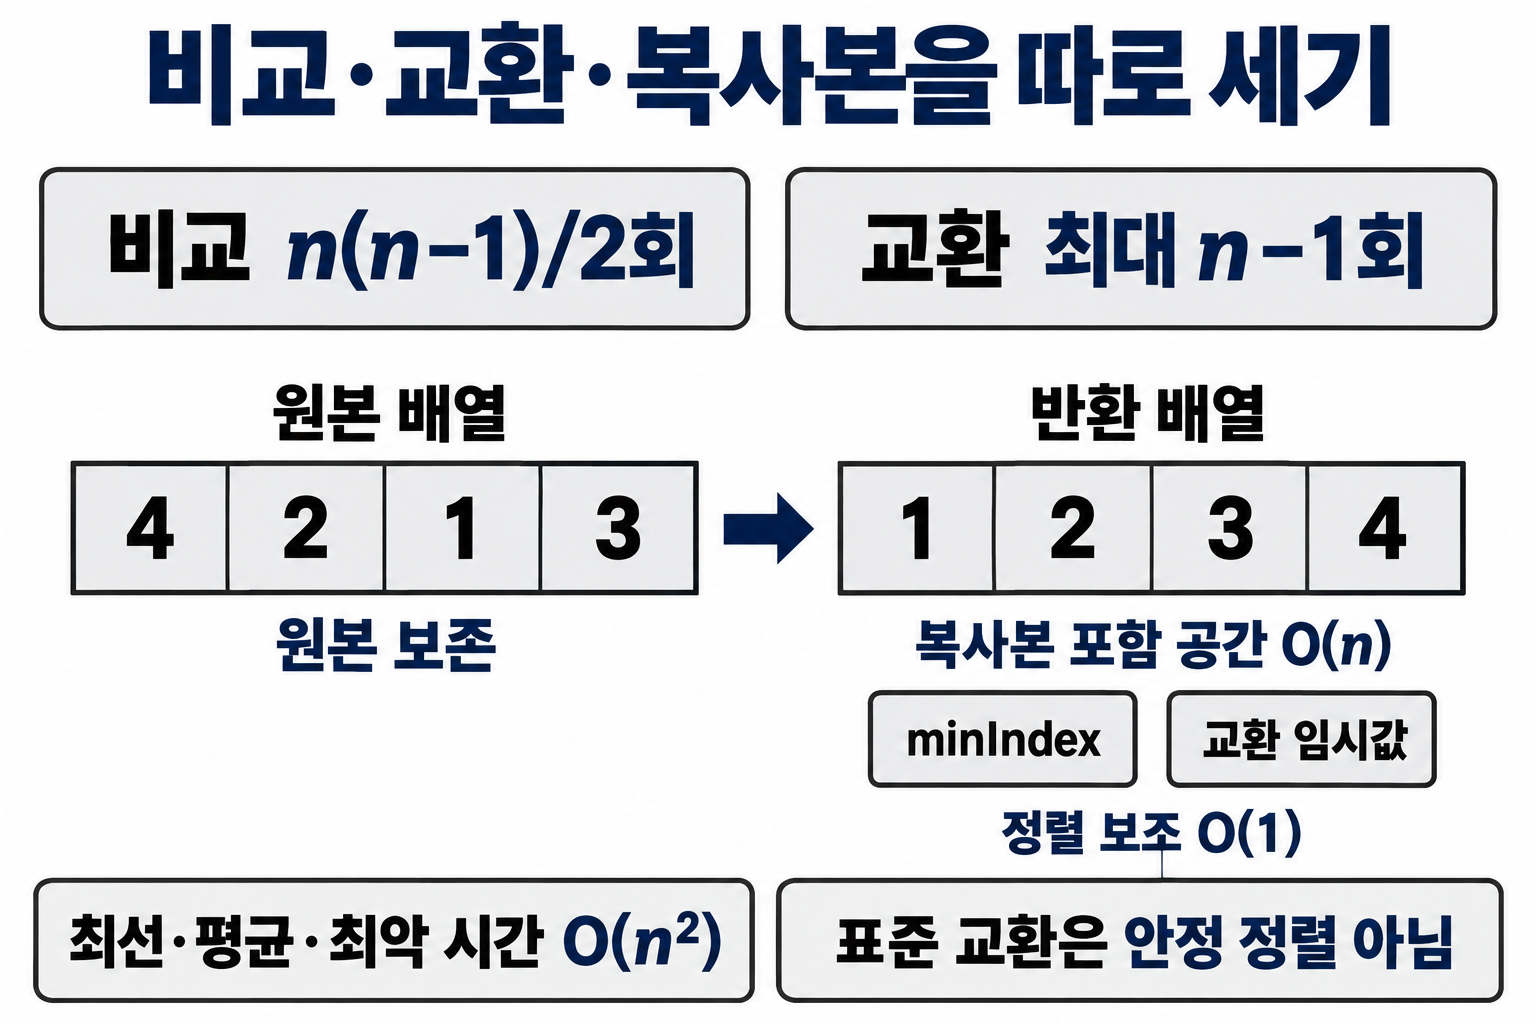
공간: O(n)
분석 조건: 원본을 유지하기 위한 반환 복사본을 포함합니다. 비교는 n(n – 1)/2번이며, 교환은 최대 n – 1번입니다. 표준 교환 방식은 안정 정렬이 아닙니다.
직접 확인해 보기
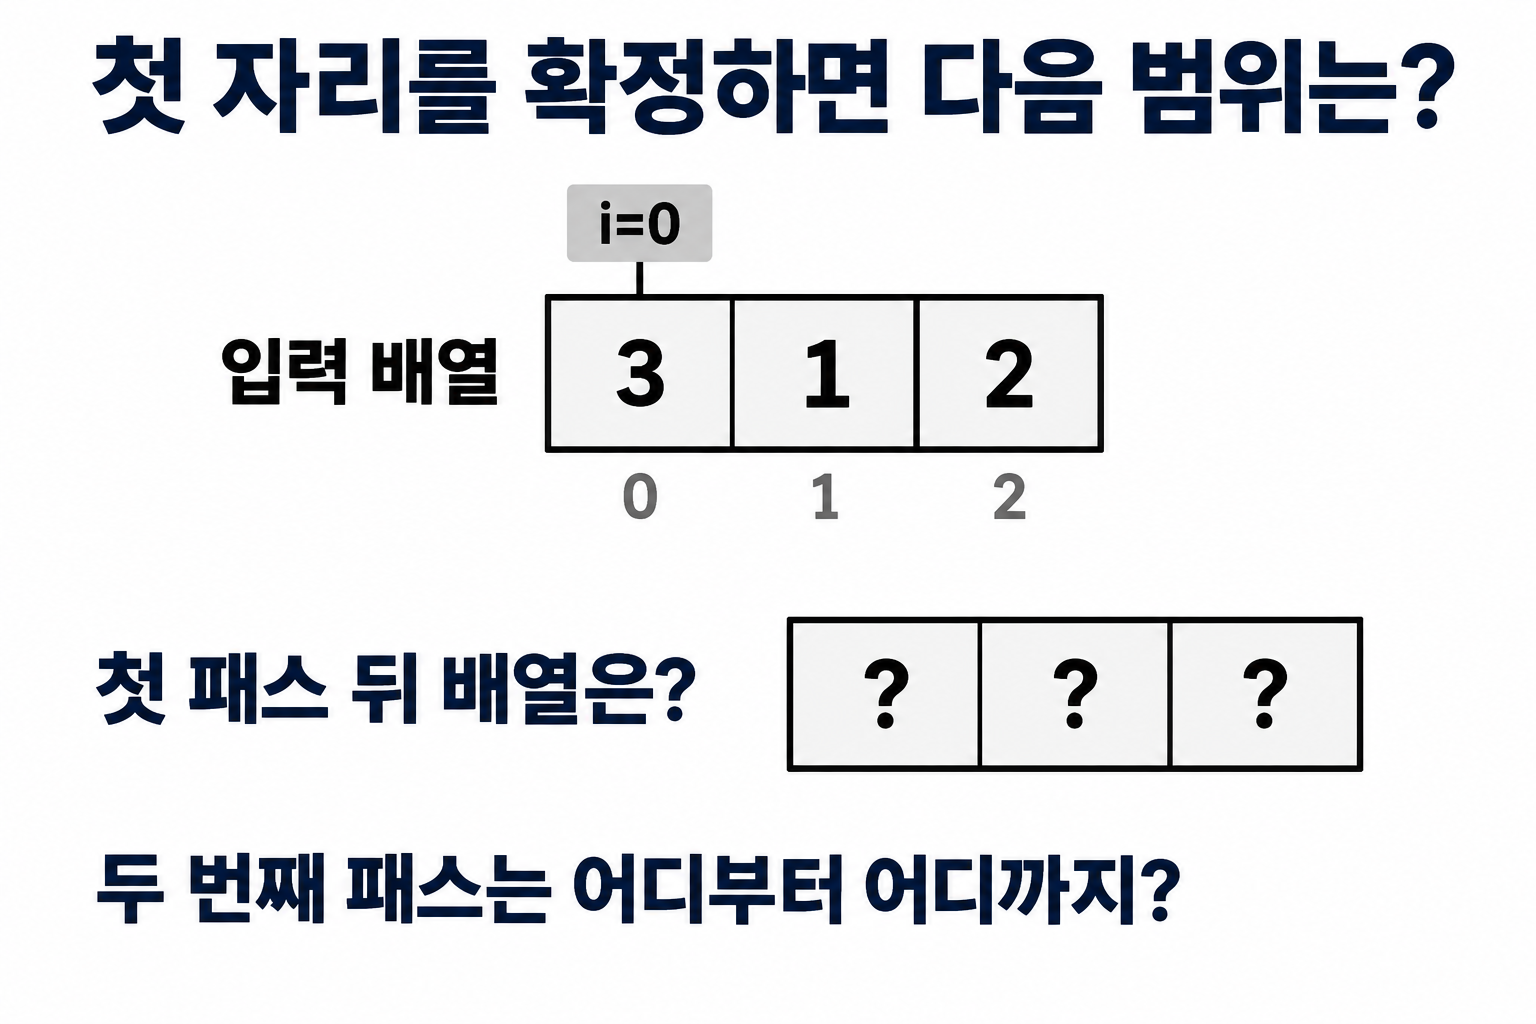
[3, 1, 2]에서 첫 패스가 끝난 배열과, 두 번째 패스가 탐색해야 할 구간을 적어 보세요.
답과 이유 확인
첫 패스는 인덱스 1의 1과 첫 값 3을 바꿔 [1, 3, 2]를 만듭니다. 1은 확정되므로 두 번째 패스는 인덱스 1~2의 [3, 2]만 탐색하고 2를 인덱스 1에 넣습니다.
함께 읽을 글
- 최솟값 구하기 풀이|배열 순회와 비교 갱신 원리 — 한 번 순회하며 최솟값 후보를 갱신하는 방법을 복습합니다.
- 완전탐색과 쌍 비교: 중복 없는 후보 열거와 순위 계산 — 구간을 줄이는 이중 반복문의 전체 비교 수를 셉니다.
참고 자료
- Princeton Algorithms — Elementary Sorts — 선택 정렬의 최솟값 탐색, 비교 수와 교환 수, 안정성 차이를 참고했습니다. 숫자 계약과 추적 예제는 직접 구성했습니다.
이 글이 도움이 되었나요?
이어서 공부하기
체크포인트: 예제의 상태 변화를 손으로 추적하고 아래 문제에 적용하세요. 값이 없는 경우와 원소 하나인 경우도 설명해 보세요. 중복 값과 이미 정렬된 입력을 확인하고 추가 공간과 최악 시간의 조건을 설명하세요.
다음 추천 · 알고리즘 개념: 삽입 정렬: 정렬된 앞부분에 다음 값을 끼워 넣기
권장 순서는 학습 가이드와 같습니다. 다른 순서는 접힌 참고 목록에서 확인할 수 있습니다. 읽음 표시는 숙달이나 채점 결과가 아닙니다.
원래 과정 목록 순서 (선택)
읽음 기록
읽음 — / 전체 30개 · 필수 0개
새 글 받아보기
RSS 리더에서 BlogFlow의 새 글을 확인할 수 있습니다.