읽기 전에 알아두면 좋아요
아래 개념이 익숙하면 본문을 바로 읽으세요. 낯선 개념만 링크에서 복습하면 됩니다.
- 2차원 배열 탐색: 행·열·대각선과 상하좌우 경계행과 열의 번호로 칸을 찾고 가장자리에서 배열 범위를 벗어나지 않는지 확인합니다. 상하좌우만 검사하고 바깥값·같은 높이·모서리를 처리합니다.
- JavaScript 배열: 인덱스 조회와 삽입·삭제 비용배열은 여러 값을 순서대로 담습니다. 인덱스로 값을 읽고 반복문으로 하나씩 살펴봅니다. 인덱스 접근과 배열을 순회할 때의 연산 비용을 확인합니다.
개념과 예제는 실행하지 않아도 읽을 수 있습니다. 내 컴퓨터·터미널에서 직접 실행하는 과정은 선택 실습입니다.
과정 위치와 선택 복습 안내
과정 위치: 완전탐색과 격자 · 문제
과정 위치는 이 글이 속한 묶음입니다. 이 단계의 모든 개념을 먼저 읽을 필요는 없습니다. 위에 연결한 개념 중 낯선 내용만 복습하세요. 문제의 조건·상태·갱신 순서는 익숙한 언어로 설명하면 됩니다.
JavaScript로 문법·실행 복습하기 (선택)
개념 글의 코드는 JavaScript 예시입니다. 문제 화면에서는 JavaScript·Python·Java·C++·C# 중 익숙한 언어의 함수를 작성하세요. 본문의 Node.js 입출력 예시는 로컬 실행을 위한 별도 안내입니다.
높이 격자에서 봉우리로 세는 칸의 조건은 무엇인가요?
높이 격자에서 상하좌우 이웃보다 높은 봉우리의 개수를 구하는 문제입니다. 2차원 배열·이웃·경계의 기본을 준비하고, 아래 입력·반환 계약을 확인해 직접 풀어보세요.
적용 조건·범위: isPeak가 끝까지 true라면 범위 안의 모든 이웃은 현재 높이보다 작습니다. 범위 밖의 이웃은 0이고 현재 높이는 양수이므로, 그쪽도 봉우리 조건을 만족합니다. 반대로 범위 안에 같거나 더 높은 이웃이 있다면 반드시 false가 되어 제외됩니다.
문제·입출력·제약
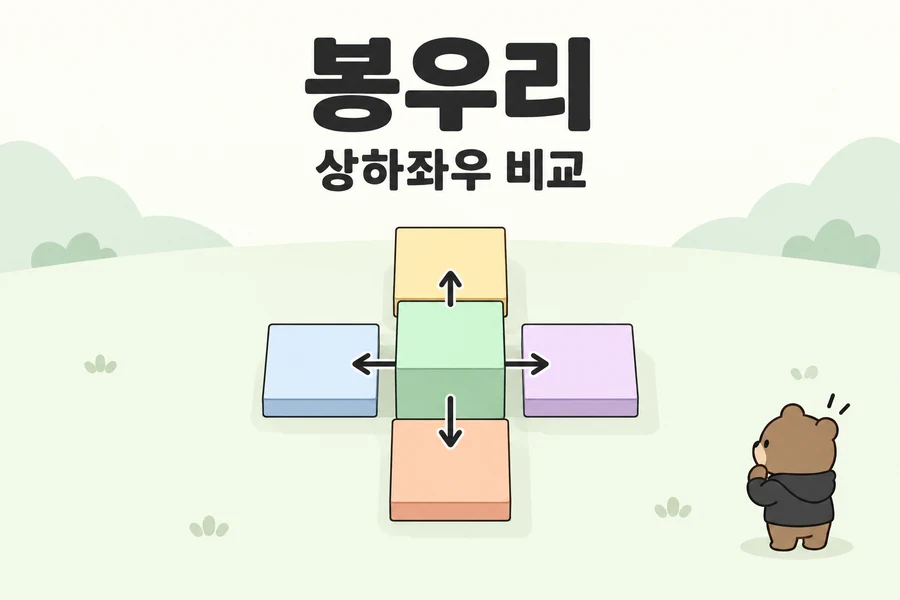
N×N 격자에 지역별 높이가 주어집니다. 각 칸이 자신의 상하좌우 네 칸보다 모두 높으면 봉우리로 세고, 그 개수를 출력합니다. 대각선의 높이는 비교하지 않습니다.
- 입력: 첫 줄에 N, 이어지는 N줄에 각 행의 높이 N개가 공백으로 주어집니다.
- 출력: 봉우리 개수를 한 줄로 출력합니다.
- 격자 크기: 1 ≤ N ≤ 50
- 높이: 100 이하의 자연수, 즉 1~100
- 격자 바깥의 높이: 0으로 가정합니다.
- 같은 높이의 이웃이 있으면 봉우리가 아닙니다.
제공된 「섹션 2. 1, 2차원 탐색.pdf」 7쪽과 「7. 봉우리.txt」를 직접 확인해 요약했습니다. 자료에 별도 온라인 채점 플랫폼이나 원문 URL은 기재되어 있지 않습니다. 아래 풀이는 PDF의 입출력 형식을 Node.js 표준 입출력으로 구현합니다.
원본 예제 입력
5
5 3 7 2 3
3 7 1 6 1
7 2 5 3 4
4 3 6 4 1
8 7 3 5 2
원본 예제 출력
10목차
코드를 보기 전에 원본 예제에서 첫째 행을 먼저 판별해 보세요.
- 왼쪽 위의 5는 위·왼쪽 이웃을 어떻게 처리해야 할까요?
- 첫째 행 셋째 칸의 7을 검사할 때, 대각선 아래의 7도 비교해야 할까요?
- 봉우리가 아니라는 사실을 확인한 뒤에도 나머지 방향을 계속 검사해야 할까요?
한 칸의 판정 방법을 먼저 정하면, 격자 전체에는 같은 검사를 반복하면 됩니다.
직접 풀어보기
먼저 선택한 언어의 입력·반환 계약에 맞춰 작성해 보세요. 힌트 받기와 정답과 비교하기는 코드를 실행하지 않는 AI 분석입니다. 해답·해설은 아래에서 필요할 때 펼칠 수 있습니다.
AI 힌트
코드를 실행한 채점 결과가 아닌 AI의 코드 분석입니다.
해답·해설 보기
function solve(input) {
    const tokens = input.trim().split(/\s+/).map(Number);
    const n = tokens[0];
    const grid = Array.from({ length: n }, (_, row) => tokens.slice(1 + row * n, 1 + (row + 1) * n));
    const directions = [[-1, 0], [1, 0], [0, -1], [0, 1]];
    let count = 0;
    for (let row = 0; row < n; row++) {
        for (let col = 0; col < n; col++) {
            let isPeak = true;
            for (const [dr, dc] of directions) {
                const nextRow = row + dr;
                const nextCol = col + dc;
                if (nextRow >= 0 && nextRow < n && nextCol >= 0 && nextCol < n
                    && grid[nextRow][nextCol] >= grid[row][col]) {
                    isPeak = false;
                    break;
                }
            }
            if (isPeak) count++;
        }
    }
    return String(count);
}
N과 N×N 높이를 읽어 상하좌우보다 엄격히 높은 칸의 개수를 십진 문자열로 반환합니다. 입력 예시 전체를 문자열 input으로 전달하고 출력 문자열을 반환합니다. solve(input)를 호출합니다. 표준 입력·출력 코드는 추가하지 않습니다. LF·CRLF·끝 줄바꿈 없음에 같은 결과를 반환합니다.
def solve(input):
    tokens = list(map(int, input.split()))
    n = tokens[0]
    grid = [tokens[1 + row * n:1 + (row + 1) * n] for row in range(n)]
    directions = [(-1, 0), (1, 0), (0, -1), (0, 1)]
    count = 0
    for row in range(n):
        for col in range(n):
            is_peak = True
            for dr, dc in directions:
                next_row = row + dr
                next_col = col + dc
                if (0 <= next_row < n and 0 <= next_col < n
                        and grid[next_row][next_col] >= grid[row][col]):
                    is_peak = False
                    break
            if is_peak:
                count += 1
    return str(count)
N과 N×N 높이를 읽어 상하좌우보다 엄격히 높은 칸의 개수를 십진 문자열로 반환합니다. 입력 예시 전체를 문자열 input으로 전달하고 출력 문자열을 반환합니다. solve(input)를 호출합니다. 표준 입력·출력 코드는 추가하지 않습니다. LF·CRLF·끝 줄바꿈 없음에 같은 결과를 반환합니다.
import java.util.Scanner;

class Solution {
    public String solve(String input) {
        Scanner scanner = new Scanner(input);
        int n = scanner.nextInt();
        int[][] grid = new int[n][n];
        for (int row = 0; row < n; row++) {
            for (int col = 0; col < n; col++) {
                grid[row][col] = scanner.nextInt();
            }
        }
        int[][] directions = {{-1, 0}, {1, 0}, {0, -1}, {0, 1}};
        int count = 0;
        for (int row = 0; row < n; row++) {
            for (int col = 0; col < n; col++) {
                boolean isPeak = true;
                for (int[] direction : directions) {
                    int nextRow = row + direction[0];
                    int nextCol = col + direction[1];
                    if (nextRow >= 0 && nextRow < n && nextCol >= 0 && nextCol < n
                            && grid[nextRow][nextCol] >= grid[row][col]) {
                        isPeak = false;
                        break;
                    }
                }
                if (isPeak) count++;
            }
        }
        return String.valueOf(count);
    }
}
N과 N×N 높이를 읽어 상하좌우보다 엄격히 높은 칸의 개수를 십진 문자열로 반환합니다. 입력 예시 전체를 문자열 input으로 전달하고 출력 문자열을 반환합니다. new Solution().solve(input)를 호출합니다. 표준 입력·출력 코드는 추가하지 않습니다. LF·CRLF·끝 줄바꿈 없음에 같은 결과를 반환합니다.
#include <sstream>
#include <string>
#include <vector>

std::string solve(const std::string& input) {
    std::istringstream in(input);
    int n;
    in >> n;
    std::vector<std::vector<int>> grid(n, std::vector<int>(n));
    for (int row = 0; row < n; row++) {
        for (int col = 0; col < n; col++) {
            in >> grid[row][col];
        }
    }
    const int directions[4][2] = {{-1, 0}, {1, 0}, {0, -1}, {0, 1}};
    int count = 0;
    for (int row = 0; row < n; row++) {
        for (int col = 0; col < n; col++) {
            bool isPeak = true;
            for (const auto& direction : directions) {
                int nextRow = row + direction[0];
                int nextCol = col + direction[1];
                if (nextRow >= 0 && nextRow < n && nextCol >= 0 && nextCol < n
                        && grid[nextRow][nextCol] >= grid[row][col]) {
                    isPeak = false;
                    break;
                }
            }
            if (isPeak) count++;
        }
    }
    return std::to_string(count);
}
N과 N×N 높이를 읽어 상하좌우보다 엄격히 높은 칸의 개수를 십진 문자열로 반환합니다. 입력 예시 전체를 문자열 input으로 전달하고 출력 문자열을 반환합니다. solve(input)를 호출합니다. 표준 입력·출력 코드는 추가하지 않습니다. LF·CRLF·끝 줄바꿈 없음에 같은 결과를 반환합니다.
using System;

public class Solution {
    public string Solve(string input) {
        string[] tokens = input.Split((char[])null, StringSplitOptions.RemoveEmptyEntries);
        int n = int.Parse(tokens[0]);
        int[,] grid = new int[n, n];
        for (int row = 0; row < n; row++) {
            for (int col = 0; col < n; col++) {
                grid[row, col] = int.Parse(tokens[1 + row * n + col]);
            }
        }
        int[,] directions = {{-1, 0}, {1, 0}, {0, -1}, {0, 1}};
        int count = 0;
        for (int row = 0; row < n; row++) {
            for (int col = 0; col < n; col++) {
                bool isPeak = true;
                for (int direction = 0; direction < 4; direction++) {
                    int nextRow = row + directions[direction, 0];
                    int nextCol = col + directions[direction, 1];
                    if (nextRow >= 0 && nextRow < n && nextCol >= 0 && nextCol < n
                            && grid[nextRow, nextCol] >= grid[row, col]) {
                        isPeak = false;
                        break;
                    }
                }
                if (isPeak) count++;
            }
        }
        return count.ToString();
    }
}
N과 N×N 높이를 읽어 상하좌우보다 엄격히 높은 칸의 개수를 십진 문자열로 반환합니다. 입력 예시 전체를 문자열 input으로 전달하고 출력 문자열을 반환합니다. new Solution().Solve(input)를 호출합니다. 표준 입력·출력 코드는 추가하지 않습니다. LF·CRLF·끝 줄바꿈 없음에 같은 결과를 반환합니다.
접근 과정
1. 한 칸을 기준으로 네 방향을 표현합니다
현재 위치를 (row, column)이라고 하면 위는 (row-1, column), 오른쪽은 (row, column+1), 아래는 (row+1, column), 왼쪽은 (row, column-1)입니다. 행 변화량 [-1, 0, 1, 0]과 열 변화량 [0, 1, 0, -1]을 같은 인덱스로 읽으면 네 방향을 빠짐없이 방문할 수 있습니다.
2. 범위를 확인한 다음 높이를 읽습니다
배열 인덱스는 0부터 size-1까지입니다. 다음 위치가 범위를 벗어나면 실제 배열 값을 읽지 않고 건너뜁니다. 원본에서 바깥 높이는 0이고 입력 높이는 모두 양수이므로, 바깥과의 비교는 항상 통과합니다. 따라서 여기서는 0으로 둘러싼 새 배열을 만들지 않아도 됩니다.
3. 탈락 조건을 먼저 찾습니다
각 칸에서 isPeak를 true로 시작합니다. 범위 안의 이웃이 현재 높이 이상이면 false로 바꾸고 방향 반복문을 종료합니다. 네 방향을 처리한 뒤에도 true일 때만 peakCount를 1 늘립니다. 이때 종료되는 것은 현재 칸의 방향 검사이며, 다른 칸의 검사는 계속됩니다.
원본 접근을 유지하고 실행부를 정리했습니다
원본 TXT 역시 방향 배열, 범위 검사, 이웃의 높이가 현재 값 이상일 때 중단하는 방식을 사용합니다. 이 접근에 오류가 없어 그대로 유지했습니다. flag·i·j 대신 역할이 드러나는 이름을 쓰고, HTML 안에서 예제 배열을 직접 넣던 실행부를 표준 입력 처리로 바꿨습니다. 별도 라이브러리나 격자 값의 변경은 필요하지 않습니다.
해설과 정답의 근거
isPeak가 끝까지 true라면 범위 안의 모든 이웃은 현재 높이보다 작습니다. 범위 밖의 이웃은 0이고 현재 높이는 양수이므로, 그쪽도 봉우리 조건을 만족합니다. 반대로 범위 안에 같거나 더 높은 이웃이 있다면 반드시 false가 되어 제외됩니다.
이 판정을 모든 칸에 정확히 한 번씩 적용하므로, 증가한 횟수가 곧 봉우리의 개수입니다. 여기서는 경로를 찾거나 연결된 지역을 묶지 않으므로 DFS·BFS나 방문 배열은 사용하지 않습니다.
아래 코드를 solution.cjs, 원본 예제 입력을 input.txt로 저장하고 node solution.cjs < input.txt를 실행하세요. 별도 패키지는 필요하지 않습니다.
const fs = require("fs");

const values = fs.readFileSync(0, "utf8").trim().split(/\s+/).map(Number);
const size = values[0];
const grid = Array.from({ length: size }, (_, row) => {
  const start = 1 + row * size;
  return values.slice(start, start + size);
});

const rowOffsets = [-1, 0, 1, 0];
const columnOffsets = [0, 1, 0, -1];
let peakCount = 0;

for (let row = 0; row < size; row += 1) {
  for (let column = 0; column < size; column += 1) {
    let isPeak = true;

    for (let direction = 0; direction < 4; direction += 1) {
      const nextRow = row + rowOffsets[direction];
      const nextColumn = column + columnOffsets[direction];
      const isOutside =
        nextRow < 0 || nextRow >= size ||
        nextColumn < 0 || nextColumn >= size;

      if (isOutside) continue;

      if (grid[nextRow][nextColumn] >= grid[row][column]) {
        isPeak = false;
        break;
      }
    }

    if (isPeak) peakCount += 1;
  }
}

console.log(peakCount);/\s+/는 공백·탭·줄바꿈을 구분하므로 LF와 CRLF 입력을 모두 처리합니다. Node.js 공식 fs.readFileSync 문서의 파일 디스크립터·인코딩 인수에 맞춰 표준 입력을 문자열로 읽습니다. API 문서는 2026년 10월 3일 확인했습니다.
예제 추적
아래 위치는 설명을 위해 행과 열을 1부터 셉니다. 코드의 인덱스는 0부터 시작합니다.
- 첫째 행: (1,1)의 5, (1,3)의 7, (1,5)의 3으로 3개
- 둘째 행: (2,2)의 7, (2,4)의 6으로 2개
- 셋째 행: (3,1)의 7, (3,5)의 4로 2개
- 넷째 행: (4,3)의 6으로 1개
- 다섯째 행: (5,1)의 8, (5,4)의 5로 2개
예를 들어 (1,1)의 5는 위·왼쪽의 0과 오른쪽·아래의 3보다 큽니다. (3,3)의 5는 아래의 6보다 낮아 제외됩니다. 행별 개수 3+2+2+1+2를 더하면 원본 예상 출력인 10이 됩니다.
경계값과 시간·공간 복잡도
N=1이면 유일한 칸의 네 이웃이 모두 바깥의 0이므로 봉우리 하나입니다. N≥2에서 높이가 모두 같으면 같은 높이의 이웃 때문에 봉우리가 없습니다. 가장자리·모서리도 실제 이웃만 비교하면 되며, 대각선의 큰 값 때문에 탈락시켜서는 안 됩니다.
Node.js v24.19.0에서 원본 예제를 LF·CRLF로 각각 실행해 실제 출력 10이 원문 예상 출력과 일치함을 확인했습니다. 최소·최대 크기, 높이의 최솟값·최댓값, 동일값, 모서리·중앙, 대각선과의 구분을 포함한 12가지 입력을 두 줄바꿈 방식으로 실행한 총 24개 검사가 모두 통과했습니다. 경계값 입력은 구현 확인용이며 원본 예제를 추가로 제시한 것은 아닙니다.
- 시간 복잡도: 입력 변환 O(N²), N²개 칸마다 최대 네 방향 검사 O(N²)이므로 전체 O(N²)입니다.
- 공간 복잡도: 입력 토큰과 격자 저장에 O(N²)을 사용합니다. 입력 저장을 제외한 방향 배열·판정 변수의 추가 공간은 O(1)입니다.
- N=50이면 2,500칸, 방향 검사는 최대 10,000회입니다. 출력 개수도 칸 수를 넘지 않으며, 주어진 제한에서 이 방식으로 충분히 처리할 수 있습니다.
자가 확인
- 탈락 조건을
>=에서>로 바꾸면 같은 높이의 이웃을 왜 잘못 처리하게 되나요? - 원본 조건을 바꿔 높이 0도 허용한다면, 바깥을 건너뛰는 방법은 N=1·높이 0에서 여전히 맞을까요?
- 행 변화량과 열 변화량을 같은 방향 인덱스로 읽는 이유를 설명할 수 있나요?
이차원 배열의 순회를 더 연습하려면 격자판 최대합 풀이를 참고하세요. 이 글의 코드는 이전 회차 없이 독립적으로 실행할 수 있습니다.
글 소개·학습 준비·전체 목차
봉우리는 한 칸의 높이를 상하좌우와 비교하고, 같거나 더 높은 이웃이 하나라도 있으면 제외해서 셉니다. 이 글에서는 방향 배열로 네 이웃을 찾아, 입력된 격자의 봉우리 개수를 출력하는 JavaScript 프로그램을 완성합니다. 배열 인덱스·조건문·이중 반복문을 알고 있으면 따라올 수 있습니다.
이 글이 도움이 되었나요?
이어서 공부하기
체크포인트: 해설을 가리고 다시 풀고, 경계 입력을 하나 바꾸어 예상 결과와 실제 결과를 비교하세요. 같은 쌍을 두 번 세지 않는 이유와 모서리·대각선의 좌표를 설명하세요.
다음 추천 · 알고리즘 개념: 재귀의 종료 조건: 작은 문제와 기저 조건으로 거듭제곱 계산하기
권장 순서는 학습 가이드와 같습니다. 다른 순서는 접힌 참고 목록에서 확인할 수 있습니다. 읽음 표시는 숙달이나 채점 결과가 아닙니다.
원래 과정 목록 순서 (선택)
읽음 기록
읽음 — / 전체 57개 · 필수 57개
새 글 받아보기
RSS 리더에서 BlogFlow의 새 글을 확인할 수 있습니다.