읽기 전에 알아두면 좋아요
아래 개념이 익숙하면 본문을 바로 읽으세요. 낯선 개념만 링크에서 복습하면 됩니다.
- 완전탐색과 쌍 비교: 중복 없는 후보 열거와 순위 계산완전탐색은 가능한 후보를 빠짐없이 살펴보고 비교하는 방법입니다. 자신보다 큰 점수의 수에 1을 더해 공동 순위와 건너뛰는 등수를 처리합니다.
- JavaScript 배열: 인덱스 조회와 삽입·삭제 비용배열은 여러 값을 순서대로 담습니다. 인덱스로 값을 읽고 반복문으로 하나씩 살펴봅니다. 인덱스 접근과 배열을 순회할 때의 연산 비용을 확인합니다.
개념과 예제는 실행하지 않아도 읽을 수 있습니다. 내 컴퓨터·터미널에서 직접 실행하는 과정은 선택 실습입니다.
과정 위치와 선택 복습 안내
과정 위치: 완전탐색과 격자 · 문제
과정 위치는 이 글이 속한 묶음입니다. 이 단계의 모든 개념을 먼저 읽을 필요는 없습니다. 위에 연결한 개념 중 낯선 내용만 복습하세요. 문제의 조건·상태·갱신 순서는 익숙한 언어로 설명하면 됩니다.
JavaScript로 문법·실행 복습하기 (선택)
개념 글의 코드는 JavaScript 예시입니다. 문제 화면에서는 JavaScript·Python·Java·C++·C# 중 익숙한 언어의 함수를 작성하세요. 본문의 Node.js 입출력 예시는 로컬 실행을 위한 별도 안내입니다.
등수구하기 문제는 학생 점수를 받아 동점자를 포함한 어떤 결과를 구하나요?
학생 점수를 입력받아 공동 순위를 포함한 각 학생의 등수를 구하는 문제입니다. 배열·비교·중첩 반복문의 기본을 준비하고, 아래 입력·반환 계약을 확인해 직접 풀어보세요.
적용 조건·범위: 각 점수마다 전체 점수를 다시 비교하므로 시간 복잡도는 O(N²)입니다. 등수를 저장하는 길이 N의 배열을 사용하므로 추가 공간 복잡도는 O(N)입니다. 원자료의 두 상한을 따로 계산하면 N=100일 때 최대 10,000번, N=1,000일 때 최대 1,000,000번 비교합니다. 어느 상한이 실제 제약인지는 위 대조 메모처럼 미확정이며, 이 연산 수만으로 특정 시간 제한의 통과를 단정하지 않습니다.
공식 문서 참고: 관련 개념: MDN 동점을 제외하는 엄격한 비교
문제
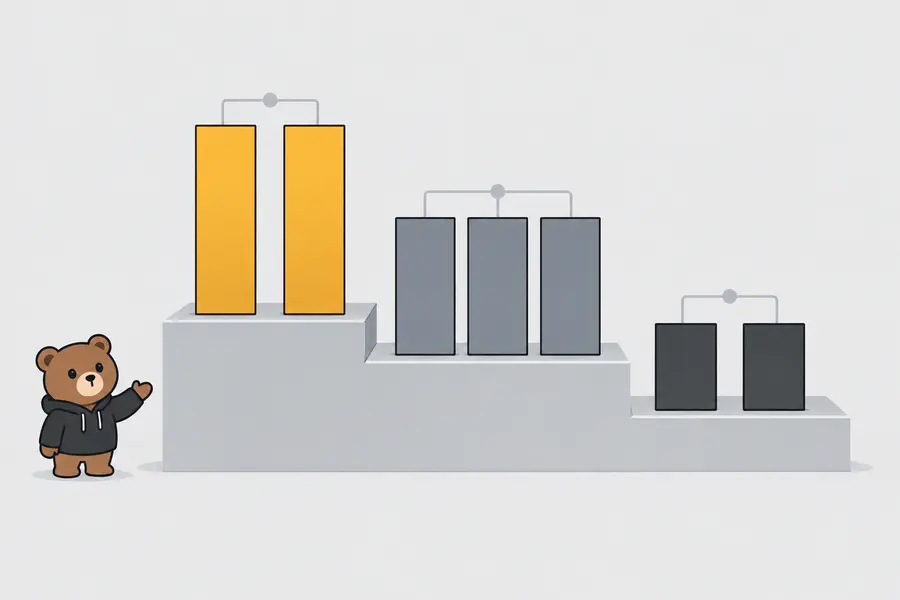
N명의 시험 점수가 입력 순서대로 주어집니다. 각 학생의 등수를 같은 순서로 출력해야 합니다. 점수가 높을수록 등수가 앞서며, 동점자는 같은 등수를 받습니다. 동점자 수만큼 다음 등수는 건너뜁니다.
첫째 줄에 N, 둘째 줄에 N개의 정수 점수가 주어집니다. 원자료의 N 범위는 문제 설명과 입력 설명이 서로 다르므로 아래 대조 메모를 확인하세요. 점수의 개별 상한은 원자료에 명시되어 있지 않습니다.
| 구분 | 값 |
|---|---|
| 예제 입력 | 5 |
| 예제 출력 | 4 3 2 1 5 |
| 공동 순위 예시 | 90 90 80 → 1 1 3 |
직접 풀어보기
먼저 선택한 언어의 입력·반환 계약에 맞춰 작성해 보세요. 힌트 받기와 정답과 비교하기는 코드를 실행하지 않는 AI 분석입니다. 해답·해설은 아래에서 필요할 때 펼칠 수 있습니다.
AI 힌트
코드를 실행한 채점 결과가 아닌 AI의 코드 분석입니다.
해답·해설 보기
function solve(input) {
    const t = input.trim().split(/\s+/).map(Number);
    const n = t[0], a = t.slice(1, n + 1);
    return a.map(x => 1 + a.filter(y => y > x).length).join(' ');
}
입력 예시 전체를 문자열로 전달하고 출력 문자열을 반환합니다. solve(input)를 호출합니다. 표준 입력·출력 코드는 추가하지 않습니다. 입력 공백과 LF/CRLF 줄바꿈을 처리합니다.
def solve(input):
    t = list(map(int, input.split()))
    n, a = t[0], t[1:1+t[0]]
    return ' '.join(str(1 + sum(y > x for y in a)) for x in a)
입력 예시 전체를 문자열로 전달하고 출력 문자열을 반환합니다. solve(input)를 호출합니다. 표준 입력·출력 코드는 추가하지 않습니다. 입력 공백과 LF/CRLF 줄바꿈을 처리합니다.
import java.util.*;
class Solution {
    public String solve(String input) {
        Scanner sc = new Scanner(input);
        int n = sc.nextInt();
        int[] a = new int[n];
        for (int i = 0; i < n; i++) a[i] = sc.nextInt();
        StringJoiner out = new StringJoiner(" ");
        for (int x : a) {
            int rank = 1;
            for (int y : a) if (y > x) rank++;
            out.add(String.valueOf(rank));
        }
        return out.toString();
    }
}
입력 예시 전체를 문자열로 전달하고 출력 문자열을 반환합니다. new Solution().solve(input)를 호출합니다. 표준 입력·출력 코드는 추가하지 않습니다. 입력 공백과 LF/CRLF 줄바꿈을 처리합니다.
#include <algorithm>
#include <sstream>
#include <string>
#include <vector>
std::string solve(const std::string & input) {
    std::istringstream in(input);
    int n;
    in >> n;
    std::vector < int > a(n);
    for (int & x : a) in >> x;
    std::ostringstream out;
    for (int i = 0; i < n; i++) {
        int rank = 1;
        for (int y : a) if (y > a[i]) rank++;
        if (i) out << " ";
        out << rank;
    }
    return out.str();
}
입력 예시 전체를 문자열로 전달하고 출력 문자열을 반환합니다. solve(input)를 호출합니다. 표준 입력·출력 코드는 추가하지 않습니다. 입력 공백과 LF/CRLF 줄바꿈을 처리합니다.
using System;
using System.Collections.Generic;
public class Solution {
    public string Solve(string input) {
        string[] t = input.Split((char[]) null, StringSplitOptions.RemoveEmptyEntries);
        int n = int.Parse(t[0]);
        int[] a = new int[n];
        for (int i = 0; i < n; i++) a[i] = int.Parse(t[i + 1]);
        int[] ranks = new int[n];
        for (int i = 0; i < n; i++) {
            ranks[i] = 1;
            foreach(int y in a) if (y > a[i]) ranks[i]++;
        }
        return string.Join(" ", ranks);
    }
}
입력 예시 전체를 문자열로 전달하고 출력 문자열을 반환합니다. new Solution().Solve(input)를 호출합니다. 표준 입력·출력 코드는 추가하지 않습니다. 입력 공백과 LF/CRLF 줄바꿈을 처리합니다.
원자료와 확인 범위
2026-10-12에 제공된 학습 자료 섹션 2. 1, 2차원 탐색.pdf의 5쪽 ‘등수구하기’와 문제 조건·예제를 대조했습니다. 같은 ZIP의 해당 문제 TXT는 풀이 코드 자료입니다. 이 자료의 최초 출제 원문·저자·공개 배포 주소까지 확인한 것은 아닙니다.
원자료의 제약 충돌: 문제 설명은 N을 1~100으로, 입력 설명은 3~1,000으로 적고 있습니다. 예제 N=5와 동점 순위 규칙은 일치하지만 정확한 N 범위는 최초 원문 확인 전까지 미확정입니다.
이번 대조는 원자료의 문제 조건과 예제 확인입니다. 이 글의 전체 코드를 새로 실행하거나 공식 채점에 제출한 결과를 뜻하지 않습니다. 아래 예제·자가 확인 항목은 직접 실행해 기대 출력과 비교하는 기준입니다.
풀이와 정답 보기 (클릭)
각 학생의 등수를 1로 시작합니다. 현재 점수보다 높은 점수를 발견할 때마다 등수를 1씩 증가시키면 모든 비교가 끝난 뒤 정확한 순위가 남습니다. 같은 점수에는 증가 조건이 적용되지 않아 자연스럽게 공동 순위가 만들어집니다.
알고리즘 설계
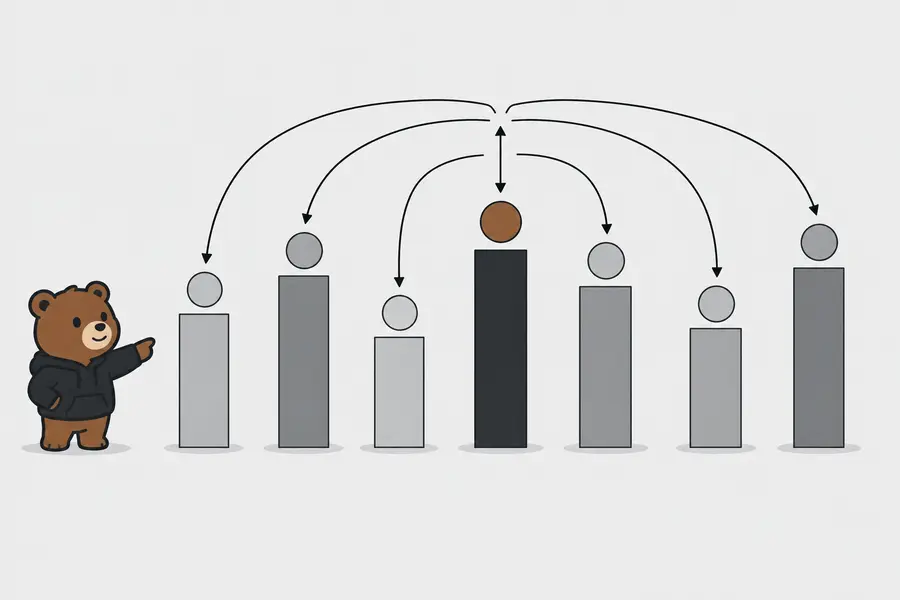
- 길이가 N인 등수 배열을 만들고 모든 값을 1로 초기화합니다.
- 한 학생의 점수를 기준으로 N개의 점수를 모두 확인합니다.
- 기준 점수보다 높은 점수를 만나면 해당 학생의 등수를 1 증가시킵니다.
- 모든 학생에 대해 비교를 반복한 뒤 등수 배열을 공백으로 연결해 출력합니다.
예를 들어 87점보다 높은 점수는 89점, 92점, 100점의 세 개이므로 87점의 등수는 1 + 3인 4등입니다. 90점이 두 명이라면 서로의 점수는 더 높지 않으므로 둘 다 같은 등수를 받습니다.
배열 인덱스와 이중 반복문을 알고 시작합니다. Node.js가 설치되어 node --version에 버전이 표시되는 환경에서 아래 전체 코드를 solution.cjs로 저장하세요. 같은 폴더의 UTF-8 input.txt에는 예제의 학생 수 5와 점수 다섯 개를 넣습니다. PowerShell 7에서는 Get-Content -Raw -Encoding UTF8 ./input.txt | node ./solution.cjs로 전달하고, Bash·명령 프롬프트에서는 node solution.cjs < input.txt를 사용합니다. 예제의 기대 출력은 4 3 2 1 5이며 현재 편집에서 실행한 결과는 아닙니다.
const fs = require("fs");

const inputText = fs.readFileSync(0, "utf8");
const input = inputText
  .trim()
  .replaceAll(String.fromCharCode(13), " ")
  .replaceAll(String.fromCharCode(10), " ")
  .split(" ")
  .filter(Boolean)
  .map(Number);
const count = input[0];
const scores = input.slice(1, count + 1);
const ranks = Array(count).fill(1);

for (let i = 0; i < count; i += 1) {
  for (let j = 0; j < count; j += 1) {
    if (scores[j] > scores[i]) {
      ranks[i] += 1;
    }
  }
}

console.log(ranks.join(" "));
입력의 CR과 LF를 공백으로 바꾸고 빈 값을 제거하므로 Windows의 CRLF와 Linux의 LF 줄바꿈을 모두 처리합니다. 첫 번째 값은 학생 수로, 이어지는 N개 값만 점수 배열로 사용합니다.
복잡도와 검증
각 점수마다 전체 점수를 다시 비교하므로 시간 복잡도는 O(N²)입니다. 등수를 저장하는 길이 N의 배열을 사용하므로 추가 공간 복잡도는 O(N)입니다. 원자료의 두 상한을 따로 계산하면 N=100일 때 최대 10,000번, N=1,000일 때 최대 1,000,000번 비교합니다. 어느 상한이 실제 제약인지는 위 대조 메모처럼 미확정이며, 이 연산 수만으로 특정 시간 제한의 통과를 단정하지 않습니다.
| 검증 항목 | 입력 특징 | 기대 출력 |
|---|---|---|
| 제공 예제 | 87 89 92 100 76 |
4 3 2 1 5 |
| 최소 입력 | 100 |
1 |
| 공동 순위 | 90 90 80 |
1 1 3 |
| 오름차순 | 10 20 30 40 50 |
5 4 3 2 1 |
| 모두 같은 점수 | 70 70 70 70 |
1 1 1 1 |
이전 문제의 누적 상태 흐름은 점수계산 JavaScript 풀이에서 확인할 수 있습니다. 배열을 순회하며 기준값과 비교하는 기초는 보이는 학생 JavaScript 풀이도 함께 참고할 수 있습니다.
이 문제를 푼 뒤 확인하기
동점이 있는 경우 같은 등수를 주는지, 더 높은 점수의 개수로 각 등수를 계산해 보세요.
본문의 예제와 이 반례를 직접 실행해 예상 출력과 비교하고, 결과가 다르면 입력 조건과 반복 범위를 다시 확인하세요.
글 소개·학습 준비·전체 목차
각 학생의 점수를 다른 모든 점수와 비교해 등수를 구하는 문제입니다. 자신보다 높은 점수의 개수에 1을 더하면 해당 학생의 등수가 되며, 같은 점수는 서로 순위를 앞서지 않으므로 같은 등수를 받습니다.
이 글이 도움이 되었나요?
이어서 공부하기
체크포인트: 해설을 가리고 다시 풀고, 경계 입력을 하나 바꾸어 예상 결과와 실제 결과를 비교하세요. 같은 쌍을 두 번 세지 않는 이유와 모서리·대각선의 좌표를 설명하세요.
다음 추천 · 알고리즘 개념: 2차원 배열 탐색: 행·열·대각선과 상하좌우 경계
권장 순서는 학습 가이드와 같습니다. 다른 순서는 접힌 참고 목록에서 확인할 수 있습니다. 읽음 표시는 숙달이나 채점 결과가 아닙니다.
원래 과정 목록 순서 (선택)
읽음 기록
읽음 — / 전체 57개 · 필수 57개
새 글 받아보기
RSS 리더에서 BlogFlow의 새 글을 확인할 수 있습니다.