이번 글에서 배우는 내용
AI 에이전트가 긴 작업을 수행하다가 중단됐을 때 중요한 것은 모델이 이전 대화를 얼마나 잘 기억하느냐만이 아닙니다. 현재 작업이 어디까지 확정됐고, 외부 시스템에는 실제로 어떤 결과가 남았으며, 다음에 무엇을 확인해야 하는지를 별도의 상태로 기록해야 안전하게 이어갈 수 있습니다.
이 글에서는 Context, Memory, State, Checkpoint를 구분하고, 보고서 업로드 예제로 상태 전이를 설계합니다. 마지막에는 외부 라이브러리 없이 Node.js로 업로드 성공 후 응답이 유실된 상황을 재현하고, 프로그램을 다시 실행했을 때 중복 업로드 없이 복구하는 과정까지 직접 확인합니다.
선수 지식은 JSON 객체와 JavaScript 함수, 파일 읽기·쓰기의 기본 개념입니다. 제목은 상태 관리의 중요성을 강조하지만 모든 에이전트 실패가 상태 문제라는 뜻은 아닙니다. 추론 오류, 잘못된 도구 선택, 권한 부족, 입력 품질 문제도 별도로 진단해야 합니다.
목차
- 결론부터: 좋은 모델도 상태를 잃으면 작업을 안전하게 이어갈 수 없다
- AI 에이전트에서 상태란 무엇인가
- 상태·컨텍스트·메모리·체크포인트 차이
- 같은 모델인데 왜 한쪽만 실패할까
- 보고서 업로드 예제로 상태 흐름 이해하기
- 상태 전이는 어떻게 설계할까
- 가장 위험한 상태: 성공했는지 모르는 경우
- 재시도만으로 해결할 수 없는 이유
- 상태에 무엇을 저장해야 할까
- 실패 복구에 필요한 설계 원칙
- 직접 실행: 중단된 에이전트 다시 시작하기
- 누적 프로젝트: 게시 자동화 에이전트에 상태 저장 추가
- 흔한 실수
- 핵심 정리
결론부터: 좋은 모델도 상태를 잃으면 작업을 안전하게 이어갈 수 없다
에이전트 작업은 보통 현재 상태 → 판단 → 행동 → 외부 결과 → 검증 → 새로운 상태의 반복입니다. 이 흐름에서 모델은 다음 행동을 판단하지만, 이미 실행한 행동과 외부 결과를 확정하는 일은 시스템이 맡아야 합니다.
현재 상태
→ 판단
→ 행동
→ 외부 결과
→ 검증
→ 새로운 상태
중간에 프로세스가 종료되거나 네트워크가 끊겼다면 시작점은 모델의 기억이 아니라 마지막으로 저장된 상태입니다. 저장된 상태를 읽고 실제 외부 결과와 대조한 뒤 다음 행동을 결정해야 합니다.
저장된 상태
→ 실제 외부 상태 확인
→ 이미 끝난 작업인지 검증
→ 필요한 다음 행동만 실행
AI 에이전트에서 상태란 무엇인가
여기서 말하는 상태는 단순한 대화 기록이 아닙니다. 예를 들어 에이전트가 보고서를 생성해 외부 저장소에 올리는 작업을 수행한다면, 대화에는 “보고서를 업로드해 주세요”라는 요청이 남을 수 있습니다. 하지만 실제 운영에 필요한 정보는 보고서 생성 완료, 로컬 검증 통과, 업로드 요청 전송, 외부 결과 확인 필요처럼 현재 작업의 진행 위치입니다.
대화 기록은 무엇을 이야기했는지 보여 주고, 작업 상태는 무엇이 확정됐고 무엇을 확인해야 하는지 보여 줍니다. “업로드를 시도했다”와 “대상에 파일이 실제로 생겼다”를 같은 완료 표시로 저장하면 복구할 때 중복 작업이 발생할 수 있습니다.
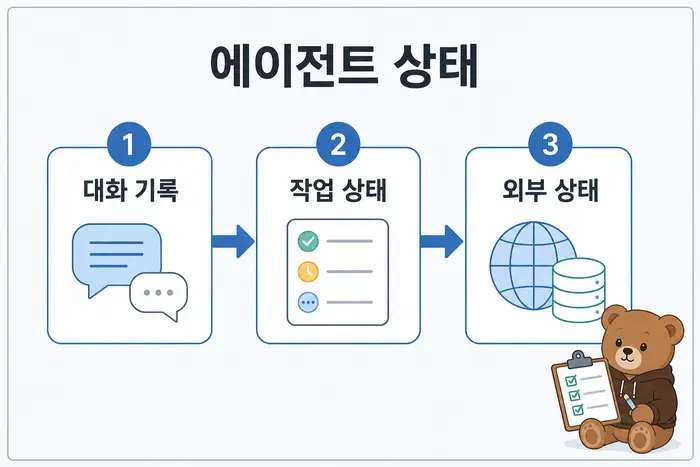
상태·컨텍스트·메모리·체크포인트 차이
| 개념 | 쉽게 말하면 | 예시 |
|---|---|---|
| Context | 지금 판단할 때 모델이 보고 있는 정보 | 현재 요청, 도구 결과, 이번 실행의 입력 |
| Memory | 이전 상호작용에서 이어지는 정보 | 이전 대화 내용, 사용자 선호, 세션 이력 |
| State | 현재 작업이 어디까지 진행됐는지 나타내는 값 | stage: "upload_unknown" |
| Checkpoint | 나중에 재개할 수 있도록 특정 시점의 상태를 저장한 것 | 업로드 직전 상태 저장 |
| External state | 에이전트 바깥 시스템에 실제로 존재하는 결과 | 서버에 생성된 파일·게시글·결제 기록 |
OpenAI Agents SDK도 이 역할을 구분합니다. Sessions는 여러 실행에 걸친 대화 이력을 유지하는 메모리 역할을 하고, RunState는 중단된 실행을 직렬화하고 다시 이어가기 위한 실행 상태를 다룹니다. 즉 이전 대화를 기억하는 문제와 중단된 작업을 정확한 지점에서 재개하는 문제는 같지 않습니다.
같은 모델인데 왜 한쪽만 실패할까
같은 모델과 같은 요청을 사용해도 상태 관리 여부에 따라 결과가 달라질 수 있습니다. 먼저 작업 상태를 별도로 관리하지 않는 경우입니다.
보고서 생성
→ 업로드 요청
→ 서버는 저장 성공
→ 응답 도중 네트워크 끊김
→ 에이전트는 실패라고 판단
→ 같은 업로드 다시 실행
→ 중복 생성
상태 관리가 있다면 네트워크 오류를 곧바로 “업로드 실패”로 확정하지 않습니다.
보고서 생성
→ 업로드 직전 상태 저장
→ 업로드 요청
→ 응답 유실
→ upload_unknown 저장
→ 외부 결과 조회
→ 이미 존재함 확인
→ uploaded
→ verified
두 경우 모두 모델은 같습니다. 차이는 모델의 추론 능력이 아니라 시스템이 이전 행동과 외부 결과를 얼마나 정확히 기록하고 검증하느냐입니다.
보고서 업로드 예제로 상태 흐름 이해하기
처음부터 복잡한 상태 객체를 만들 필요는 없습니다. 가장 먼저 작업 식별자, 현재 단계, 시도 횟수, 외부 결과 ID 정도만 기록해도 흐름을 설명할 수 있습니다.
{
  "jobId": "report-001",
  "stage": "upload_unknown",
  "attempt": 1,
  "externalId": null
}
이후 실제 운영에서 필요한 문제를 하나씩 만나면서 필드를 늘립니다.
기본 상태
→ 파일 무결성 확인 필요: digest 추가
→ 수정 충돌 방지 필요: revision 추가
→ 로컬·원격 검증 구분 필요: verification 추가
→ 실패 원인 추적 필요: last_error 추가
→ 재개 행동 명시 필요: next_action 추가
상태 전이는 어떻게 설계할까
stage는 모델의 자신감이 아니라 확인된 사건에 따라 바꿉니다. 아래 표는 보고서 업로드 예제의 운영 계약입니다.
| 현재 상태 | 확인한 사건 | 다음 상태·행동 |
|---|---|---|
| prepared | 로컬 검증 통과 | ready: 업로드 대상과 파일 버전 고정 |
| ready | 외부 쓰기 요청 전송 | uploading: 시도 ID 기록 |
| uploading | 외부 ID가 담긴 성공 응답 | uploaded: ID로 결과 재조회 |
| uploading | 타임아웃·연결 단절 | upload_unknown: 결과 조회 전 재전송 금지 |
| uploaded | 대상 내용과 상태가 일치 | verified: 완료 처리 |
| 어느 단계든 | 입력 검증 실패 | blocked: 같은 입력 재시도 대신 입력 수정 |
이렇게 전이를 먼저 정하면 “오류가 났으니 다시 실행” 같은 단순한 재시도에서 벗어날 수 있습니다. 특히 쓰기 작업은 전송 여부보다 외부 결과가 실제로 생겼는지를 기준으로 다음 행동을 결정해야 합니다.
가장 위험한 상태: 성공했는지 모르는 경우
외부 서비스가 파일을 저장한 직후 네트워크가 끊기면 클라이언트에는 실패처럼 보일 수 있습니다. 문제는 서버에서는 이미 작업이 끝났을 가능성이 있다는 점입니다. 이때 같은 생성 요청을 반복하면 파일이나 게시글이 두 개 생길 수 있습니다.
따라서 성공과 실패 사이에 upload_unknown 같은 상태를 두는 것이 안전합니다. 재개 시에는 작업 식별자, 외부 결과 ID, 서비스가 제공하는 조회 조건을 이용해 이미 처리됐는지 먼저 확인합니다. 조회만으로 구분할 수 없다면 임의로 재전송하지 말고 unknown을 유지한 채 사람의 확인이 필요하다는 상태로 넘겨야 합니다.
재시도만으로 해결할 수 없는 이유
재시도는 네트워크 오류를 줄이는 데 유용하지만 쓰기 작업에서는 중복 실행 문제를 만들 수 있습니다. API가 공식적으로 멱등성 키를 지원한다면 같은 요청을 안전하게 재전송할 수 있는 계약을 사용할 수 있습니다. 하지만 모든 POST 요청이 이런 기능을 제공하는 것은 아닙니다.
직접 만든 job_id를 요청 본문에 넣는 것만으로 서버의 중복 방지가 생기지는 않습니다. 서버가 그 값을 고유 키로 강제하거나 원자적으로 처리해야 실제 중복 방지가 됩니다. 동시에 여러 워커가 같은 작업을 실행할 수 있다면 고유 제약, 잠금, 낙관적 버전 검사 같은 동시성 설계도 필요합니다.
상태에 무엇을 저장해야 할까
간단한 상태로 흐름을 이해했다면 실제 운영에 필요한 정보를 추가할 수 있습니다. 아래 객체는 특정 SDK의 정해진 스키마가 아니라 직접 설계하는 상태 데이터의 예시입니다.
{
  "job_id": "report-2026-09-demo",
  "revision": 2,
  "goal": "검수된 보고서 한 건 등록",
  "stage": "upload_unknown",
  "artifact": {
    "path": "out/report.md",
    "digest": "실제 파일 해시를 기록"
  },
  "external_id": null,
  "verification": {
    "local": "passed",
    "remote": "not_checked"
  },
  "last_error": {
    "kind": "timeout",
    "attempt": 1
  },
  "next_action": "외부 결과 존재 여부 조회"
}revision은 산출물이 바뀌었을 때 과거 승인이나 검증을 잘못 재사용하지 않기 위해 필요합니다. digest는 같은 파일인지 확인하고, verification은 로컬 검증과 외부 결과 검증을 분리합니다. last_error와 attempt는 무한 재시도를 막는 정책에 사용할 수 있습니다.
실패 복구에 필요한 설계 원칙
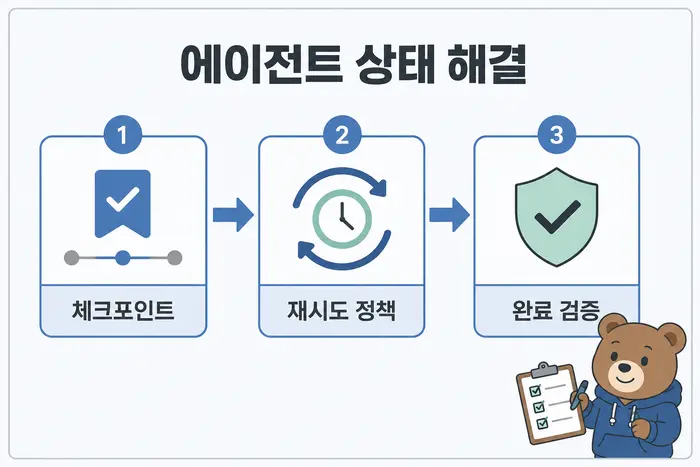
- 행동 전에 체크포인트를 남깁니다. 외부 쓰기처럼 되돌리기 어려운 작업은 실행 직전 상태를 저장합니다.
- 시도와 완료를 구분합니다. 요청을 보냈다는 사실과 외부 결과가 생성됐다는 사실은 다른 상태입니다.
- 모호한 실패는 unknown으로 남깁니다. 확인 전까지 실패나 성공으로 단정하지 않습니다.
- 재개할 때 외부 상태를 먼저 조회합니다. 저장된 상태만 믿지 않고 실제 대상과 대조합니다.
- 산출물 버전을 함께 저장합니다. revision 2에서 받은 승인을 revision 3에 재사용하지 않습니다.
- 재시도 횟수와 종료 조건을 정합니다. 같은 오류를 무한 반복하지 않습니다.
- 비밀키는 상태 파일에 저장하지 않습니다. 재개에 필요한 식별자와 검증 정보만 남깁니다.
직접 실행: 중단된 에이전트 다시 시작하기
이번 실습은 외부 API나 AI 모델 없이 상태 관리만 분리해서 확인합니다. Node.js만 있으면 되고 별도 패키지는 설치하지 않습니다. 프로그램은 첫 실행에서 원격 저장을 성공시킨 뒤 응답을 잃었다고 가정해 종료합니다. 두 번째 실행에서는 상태와 원격 저장소를 읽고 이미 업로드된 결과를 찾아 중복 생성 없이 완료합니다.
1. 실습 폴더 만들기
mkdir agent-state-demo
cd agent-state-demo
파일은 agent.js 하나만 직접 만들면 됩니다. state.json과 remote-store.json은 실행 중 자동으로 생성됩니다.
agent-state-demo/
├─ agent.js
├─ state.json
└─ remote-store.json
2. agent.js 작성
const fs = require('node:fs');

const STATE_FILE = './state.json';
const REMOTE_FILE = './remote-store.json';

const initialState = {
  jobId: 'report-001',
  stage: 'prepared',
  attempt: 0,
  externalId: null,
};

function readJson(path, fallback) {
  if (!fs.existsSync(path)) return fallback;
  return JSON.parse(fs.readFileSync(path, 'utf8'));
}

function writeJson(path, value) {
  fs.writeFileSync(path, JSON.stringify(value, null, 2), 'utf8');
}

let state = readJson(STATE_FILE, initialState);
let remoteStore = readJson(REMOTE_FILE, []);

if (state.stage === 'prepared') {
  state.stage = 'ready';
  writeJson(STATE_FILE, state);
}

if (state.stage === 'ready') {
  state.stage = 'uploading';
  state.attempt += 1;
  writeJson(STATE_FILE, state);

  const remoteItem = {
    id: `remote-${Date.now()}`,
    jobId: state.jobId,
  };

  remoteStore.push(remoteItem);
  writeJson(REMOTE_FILE, remoteStore);

  state.stage = 'upload_unknown';
  writeJson(STATE_FILE, state);

  console.log('원격 저장은 성공했지만 응답을 잃었다고 가정합니다.');
  console.log('프로그램을 다시 실행해 보세요.');
  process.exit(1);
}

if (state.stage === 'uploading' || state.stage === 'upload_unknown') {
  const existing = remoteStore.find((item) => item.jobId === state.jobId);

  if (!existing) {
    state.stage = 'ready';
    writeJson(STATE_FILE, state);
    console.log('원격 결과가 없으므로 다음 실행에서 다시 업로드합니다.');
    process.exit(0);
  }

  state.externalId = existing.id;
  state.stage = 'uploaded';
  writeJson(STATE_FILE, state);
}

if (state.stage === 'uploaded') {
  const verified = remoteStore.some((item) => item.id === state.externalId);

  if (verified) {
    state.stage = 'verified';
    writeJson(STATE_FILE, state);
  }
}

console.log(state);
3. 첫 번째 실행
node agent.js첫 실행에서는 remote-store.json에 항목이 저장된 뒤 프로그램이 종료됩니다. state.json은 upload_unknown 상태로 남습니다. 중요한 점은 외부 저장은 이미 끝났지만 프로그램이 아직 완료라고 확정하지 않았다는 것입니다.
4. 같은 명령을 다시 실행
node agent.js두 번째 실행에서는 같은 업로드를 다시 만들지 않습니다. remote-store.json에서 동일한 jobId를 먼저 조회하고 기존 결과의 ID를 가져온 뒤 uploaded → verified로 진행합니다.
{
  "jobId": "report-001",
  "stage": "verified",
  "attempt": 1,
  "externalId": "remote-..."
}
여기서 핵심은 첫 번째 실행과 두 번째 실행의 모델이 아니라 상태 파일과 실제 외부 결과를 대조하는 복구 절차입니다. 실제 에이전트에서는 이 자리에 데이터베이스, 작업 큐, SaaS API, WordPress REST API 같은 외부 시스템이 들어갑니다.
누적 프로젝트: 게시 자동화 에이전트에 상태 저장 추가
이 글의 실습을 이후 게시 자동화 프로젝트로 확장하면 각 학습 글이 하나의 작업 러너를 점진적으로 발전시키는 구조가 됩니다. 처음에는 로컬 파일로 상태를 저장하고, 이후 실제 WordPress 게시 API와 연결하면서 외부 ID와 검증 단계를 추가할 수 있습니다.
| 단계 | 프로젝트 변화 | 상태에서 추가로 관리할 값 |
|---|---|---|
| 1 | 게시글 파일 생성 | artifact.path, revision |
| 2 | 검수 절차 추가 | verification.local |
| 3 | 게시 요청 추가 | stage, attempt |
| 4 | WordPress 응답 저장 | external_id |
| 5 | 실제 게시 여부 재조회 | verification.remote |
미니 작업 러너
→ 상태 저장
→ 검토 절차
→ 게시 요청
→ 외부 결과 검증
→ 실제 WordPress 게시 자동화
흔한 실수
- 대화 이력을 작업 상태로 사용: “전에 업로드했다”는 문장을 실제 외부 결과 검증 대신 사용하면 안 됩니다.
- 오류를 모두 실패로 처리: 타임아웃은 외부 작업 실패가 아니라 결과 미확정일 수 있습니다.
- 재시도를 기본 해결책으로 사용: 쓰기 요청에서는 중복 생성 위험을 먼저 확인해야 합니다.
- 과거 승인을 새 revision에 재사용: 산출물 내용이 바뀌었다면 다시 검증해야 합니다.
- 상태 파일에 비밀키 저장: API 키와 전체 인증 응답은 별도의 안전한 자격 증명 저장소에서 관리해야 합니다.
- 여러 워커가 같은 상태를 동시에 수정: 버전 검사나 잠금 없이 갱신하면 상태가 서로 덮어써질 수 있습니다.
핵심 정리
- 에이전트의 대화 기억과 작업 상태는 다른 문제입니다.
- 상태는 모델의 판단이 아니라 확인된 사건을 기준으로 변경합니다.
- 외부 쓰기 작업에서는 성공·실패 외에
unknown상태가 필요할 수 있습니다. - 재개할 때는 저장된 상태와 실제 외부 결과를 함께 확인합니다.
- 멱등성은 클라이언트가 ID를 하나 넣는 것만으로 생기지 않고 서버의 계약과 동시성 설계가 필요합니다.
- 작은
state.json부터 시작해 revision, 검증, 오류, 외부 ID를 점진적으로 추가하는 방식이 이해하기 쉽습니다.
관련 학습
공식 자료와 확인 범위
공식 자료 확인일은 2026-09-17입니다. OpenAI Agents SDK의 세션 메모리와 실행 상태 재개 방식을 확인했고, 누적 프로젝트의 외부 게시 대상 예시를 위해 WordPress REST API 게시글 문서를 함께 연결했습니다. 본문의 상태 객체와 Node.js 실습은 특정 제품의 공식 스키마가 아니라 상태 관리 원리를 이해하기 위한 학습용 예제입니다.
이 글이 도움이 되었나요?
AI 코딩 도구 학습 순서
필수 5개 · 전체 9개
읽음 기록 관리
전체 과정 목차 (9개)
- 필수 학습 · 바이브 코딩이란? Cursor, Claude Code, Codex로 앱 만드는 방식과 현실
- 필수 길잡이 · AI 바이브 코딩 기준: 코드 품질이 무너지기 전 확인할 것
- 필수 학습 · AI 하네스 파일 사용법: AGENTS.md와 Codex 지침 구조 이해하기
- 필수 학습 · 개발자가 AI 코딩 도구를 쓸 때 생기는 검토 부채 문제
- 필수 학습 · AI 에이전트가 실패하는 진짜 이유: 모델 성능보다 상태 관리가 먼저다 현재 글
- 선택 참고 · obra/superpowers 소개: AI 코딩 에이전트에 개발 방법론을 입히는 방식
- 선택 참고 · Ponytail 소개: AI 코딩 에이전트에게 게으른 시니어 개발자의 판단을 입히는 도구
- 선택 참고 · ChatGPT와 Codex로 워드프레스 블로그 자동 업로드 파이프라인 만들기
- 선택 참고 · Claude와 GPT 비교: 코딩, 글쓰기, 문서 작업 평가 기준
새 글 받아보기
RSS 리더에서 BlogFlow의 새 글을 확인할 수 있습니다.