읽기 전에 알아두면 좋아요
아래 개념이 익숙하면 본문을 바로 읽으세요. 낯선 개념만 링크에서 복습하면 됩니다.
- 트리 자료구조 차이: 이진 트리 BST MST 구분하기트리는 노드가 부모와 자식으로 연결된 구조입니다. 연결을 따라 읽는 방법을 확인합니다.
- 자료구조 스택 쉽게 이해하기: push pop으로 문제 풀이 감 잡기스택은 마지막에 넣은 값을 먼저 꺼냅니다. 넣고 꺼낼 때 남는 순서를 확인합니다.
개념과 예제는 실행하지 않아도 읽을 수 있습니다. 내 컴퓨터·터미널에서 직접 실행하는 과정은 선택 실습입니다.
과정 위치와 선택 복습 안내
과정 위치: 트리·그래프와 최단거리 · 자료구조 개념
과정 위치는 이 글이 속한 묶음입니다. 이 단계의 모든 개념을 먼저 읽을 필요는 없습니다. 위에 연결한 개념 중 낯선 내용만 복습하세요. 문제의 조건·상태·갱신 순서는 익숙한 언어로 설명하면 됩니다.
JavaScript로 문법·실행 복습하기 (선택)
개념 글의 코드는 JavaScript 예시입니다. 문제 화면에서는 JavaScript·Python·Java·C++·C# 중 익숙한 언어의 함수를 작성하세요. 본문의 Node.js 입출력 예시는 로컬 실행을 위한 별도 안내입니다.
JavaScript 이진 탐색 트리는 중복 키와 노드 삭제를 어떻게 처리하나요?
이진 탐색 트리는 작은 키는 왼쪽, 큰 키는 오른쪽에 둡니다. 이 방향을 따라 값을 찾고, 삭제할 때는 자식 수에 따라 연결을 바꿉니다. 중복 키도 별도로 관리합니다.
적용 조건·범위: 검증 범위: 위 독립 예제의 출력만 로컬에서 확인했습니다. 이 글은 독립 자료구조 실습입니다. 실제 브라우저 표시와 모든 입력·플랫폼의 실행은 검증하지 않았습니다.
BST: 비교해서 방향을 고르고, 삭제 후 연결을 다시 잇습니다
작은 숫자 트리로 탐색 방향과 삭제의 세 경우를 배웁니다. 남은 자식과 후계자를 어디에 연결하는지 먼저 확인하고 전체 구현을 읽습니다.
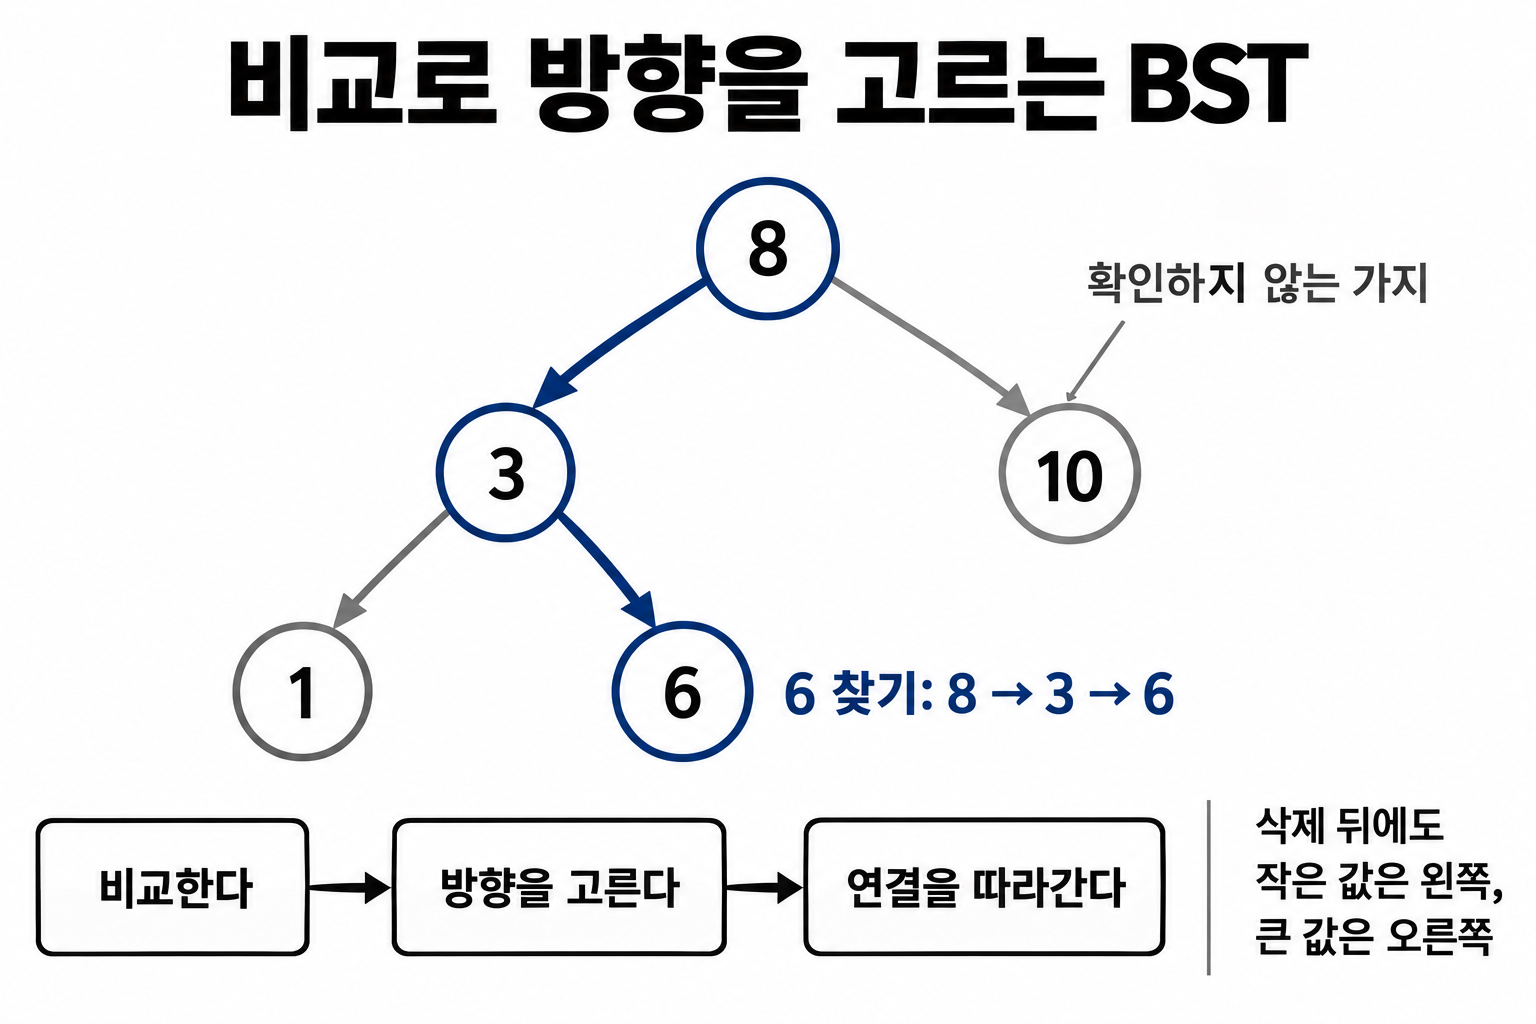
먼저 작은 예제로 원리를 익히고, 마지막에 전체 구현을 펼쳐 보세요. 앞쪽 예제는 각각 독립적으로 브라우저 개발자 도구 Console에서 실행합니다. 같은 이름을 다시 선언했다는 오류가 나오면 새로고침 후 해당 예제를 실행하세요. 출력 뒤에 콘솔이 별도로 보여주는 undefined는 마지막 명령의 반환값일 수 있습니다.
선수 지식: JavaScript 변수·배열·조건문을 먼저 익힙니다. 객체 참조나 함수가 낯설면 아래 단계별 예제부터 시작하고, class 전체 구현은 해당 동작을 손으로 추적한 뒤 읽습니다. 각각의 코드는 독립 실행합니다.
숫자를 비교하며 갈림길을 고릅니다
이진 탐색 트리는 숫자를 찾을 때 매 갈림길에서 왼쪽 또는 오른쪽 하나를 고릅니다. 현재 숫자보다 작으면 왼쪽, 크면 오른쪽으로 갑니다.
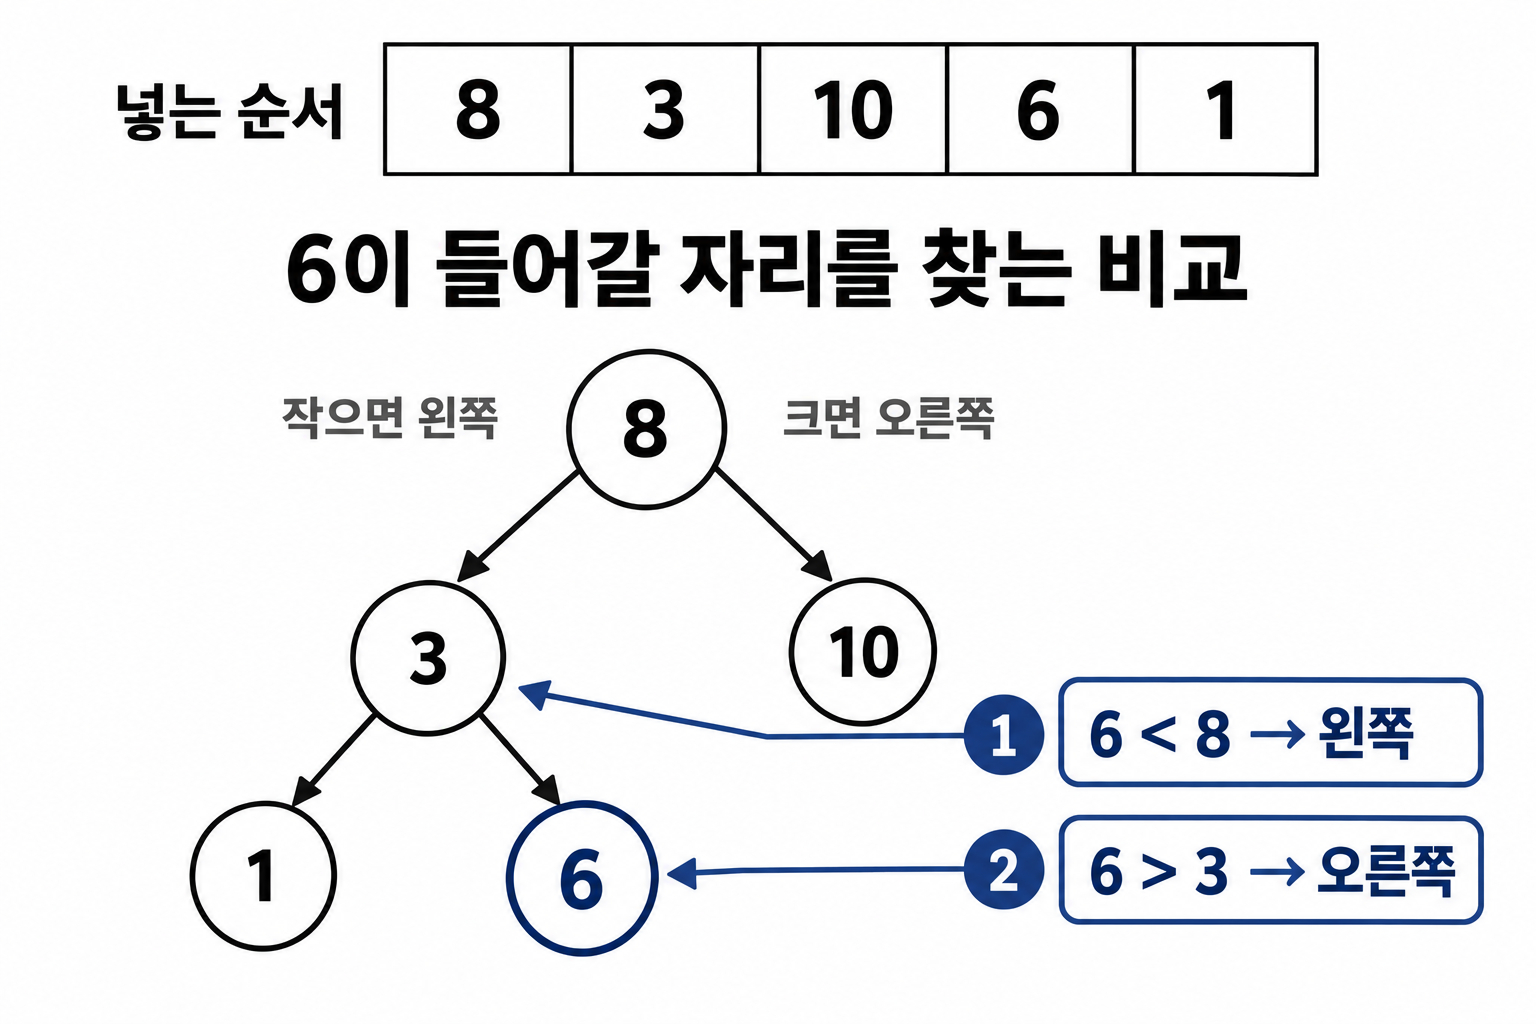
| 넣는 값 | 비교 경로 | 놓이는 자리 |
|---|---|---|
| 8 | 첫 값 | 맨 위 |
| 3 | 3 < 8 | 8의 왼쪽 |
| 10 | 10 > 8 | 8의 오른쪽 |
| 6 | 6 < 8 → 6 > 3 | 3의 오른쪽 |
| 1 | 1 < 8 → 1 < 3 | 3의 왼쪽 |
모양을 글로 쓰면 맨 위 8, 왼쪽 3, 오른쪽 10이며 3 아래에는 왼쪽 1과 오른쪽 6이 있습니다. 이 규칙 덕분에 6을 찾을 때 8의 오른쪽 가지는 확인하지 않아도 됩니다.
탐색은 같은 비교를 반복합니다
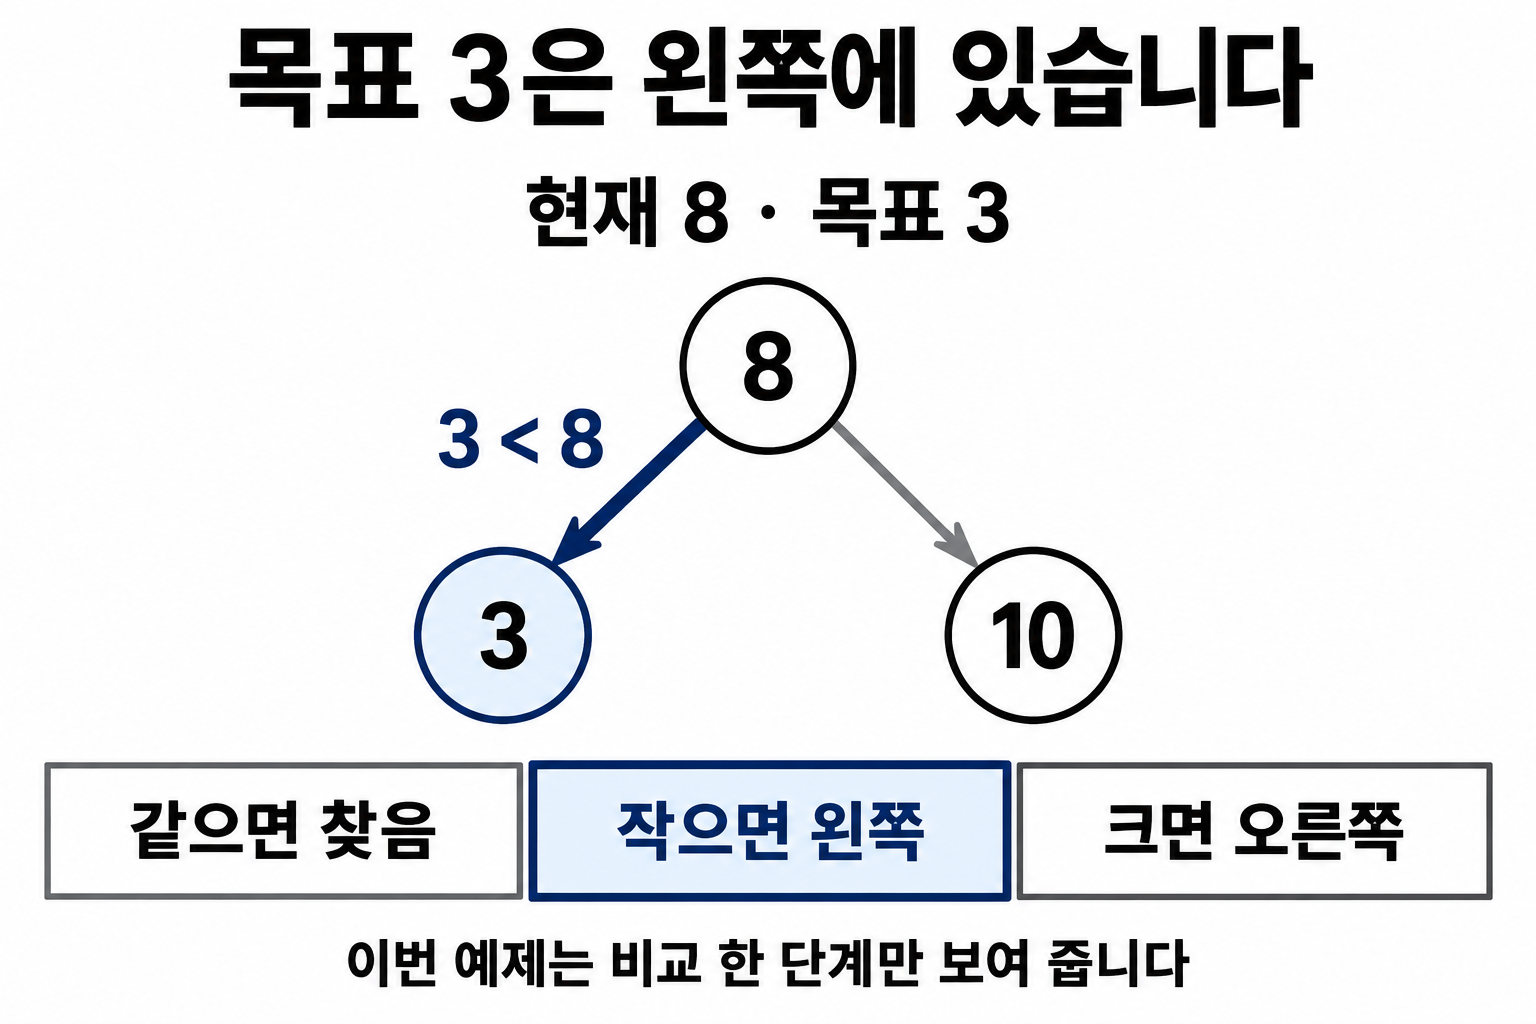
const node = { key: 8, left: { key: 3 }, right: { key: 10 } };
const target = 3;
const next = target < node.key ? node.left : node.right;

console.log(next.key);
3
현재 노드는 8이고 목표는 3입니다. 3이 더 작으므로 왼쪽 연결을 선택합니다. 비교 방향을 거꾸로 쓰면 값이 실제로 있는 반대편 가지를 버려 찾지 못합니다. 이 축소 코드는 목표가 현재 값과 다른 한 단계만 보여 줍니다. 완성 탐색 함수는 목표와 현재 키가 같으면 그 자리에서 즉시 반환하고, 다르면 이 단계를 빈 연결을 만날 때까지 반복합니다.
삭제는 자식 수에 따라 세 경우로 나눕니다
값을 지운 뒤에도 작은 값은 왼쪽, 큰 값은 오른쪽이라는 배치를 지켜야 합니다. 그래서 삭제할 노드의 자식 수를 먼저 봅니다.
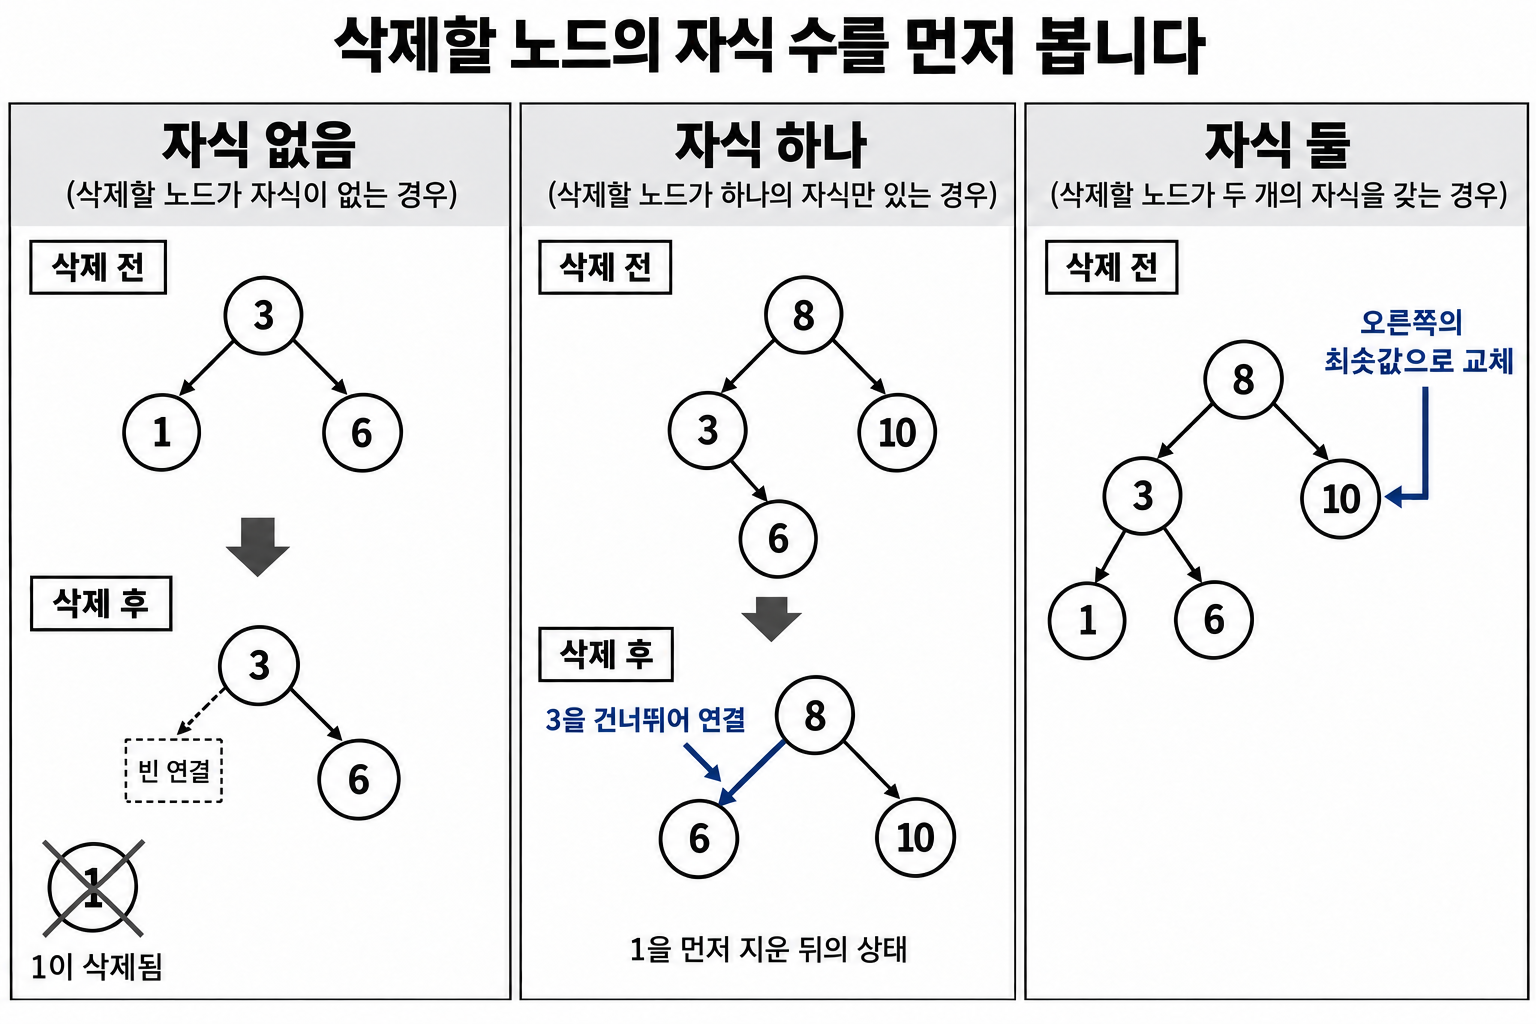
| 삭제할 값 | 현재 자식 | 연결을 바꾸는 방법 |
|---|---|---|
| 1 | 없음 | 부모 3의 왼쪽을 빈칸으로 |
| 3 (1을 먼저 지운 뒤) | 오른쪽 6 하나 | 부모 8의 왼쪽을 6에 바로 연결 |
| 8 | 왼쪽과 오른쪽 둘 | 오른쪽 가지의 가장 작은 값으로 자리 교체 |
자식이 없는 1은 연결만 끊으면 됩니다. 자식 하나를 가진 3을 지울 때는 남은 6을 위로 이어 줍니다. 자식 둘인 8은 양쪽 가지를 모두 버릴 수 없으므로, 정렬 순서를 깨지 않는 대체 값을 찾습니다.
자식 하나는 남은 연결을 부모에게 넘깁니다
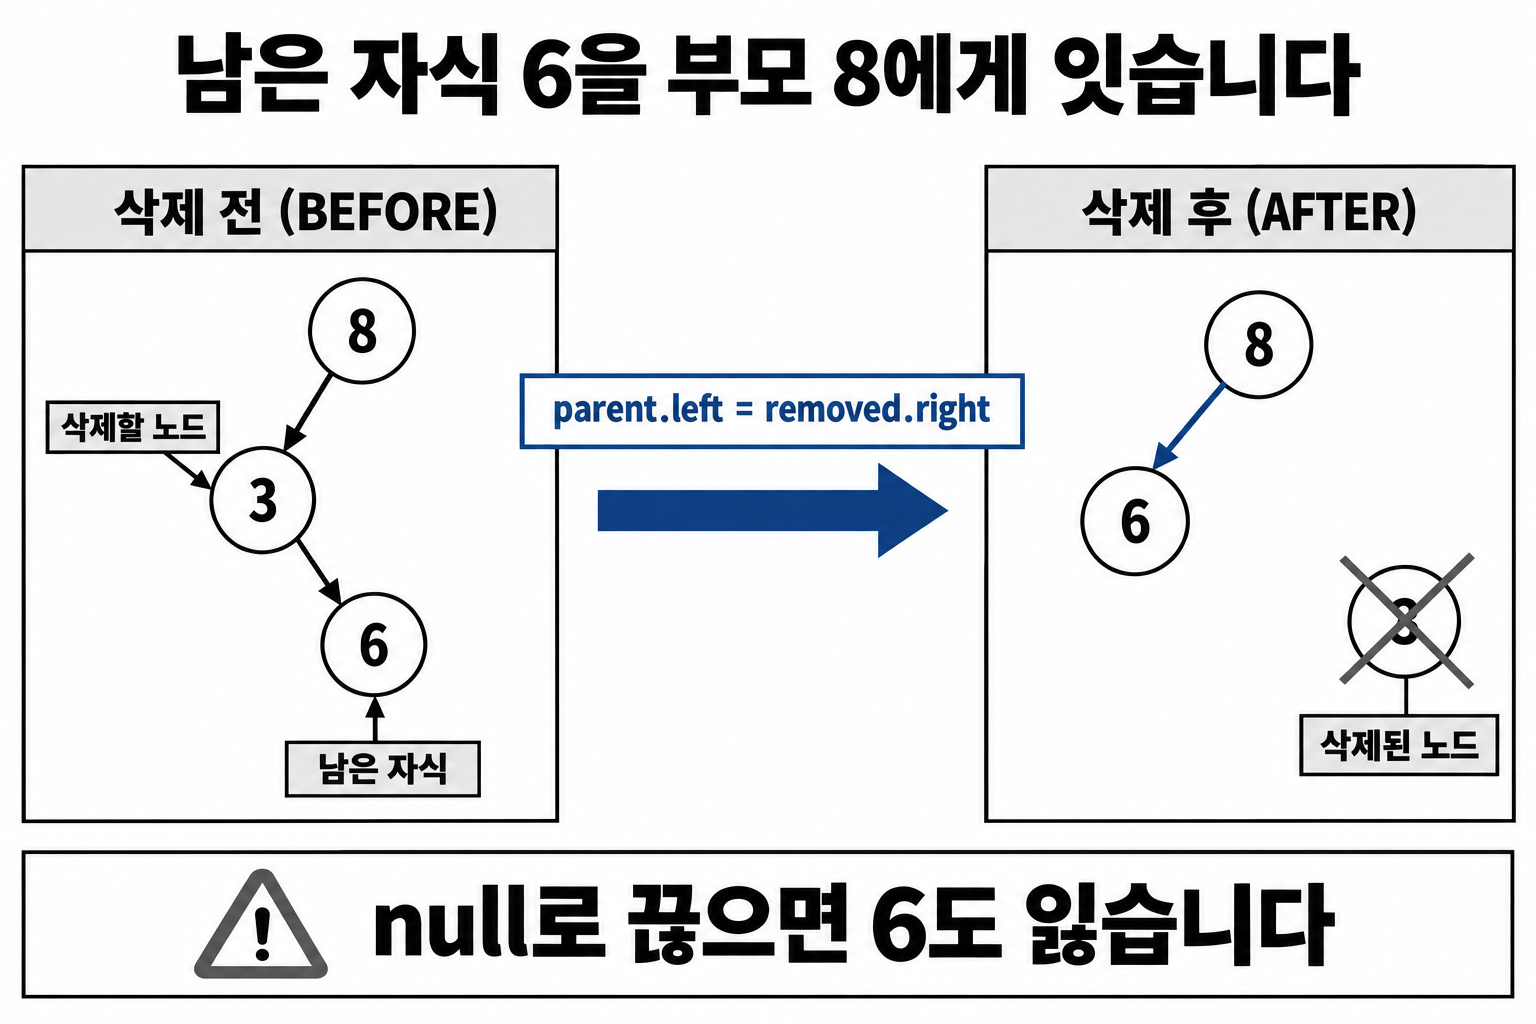
const parent = { key: 8, left: { key: 3, right: { key: 6 } } };
const removed = parent.left;
parent.left = removed.right;

console.log(parent.left.key);
6
지울 3을 removed로 기억한 뒤, 부모의 왼쪽 연결이 3의 남은 자식 6을 가리키게 합니다. 단순히 parent.left = null로 만들면 6까지 트리에서 사라집니다. 삭제에서 “값을 지운다”보다 “어느 연결을 어디로 다시 잇는가”가 중요한 이유입니다.
자식 둘이면 오른쪽에서 가장 작은 값을 찾습니다
const rightTree = { key: 12, left: { key: 10, left: { key: 9 } } };
let successor = rightTree;
while (successor.left != null) successor = successor.left;

console.log(successor.key);
9
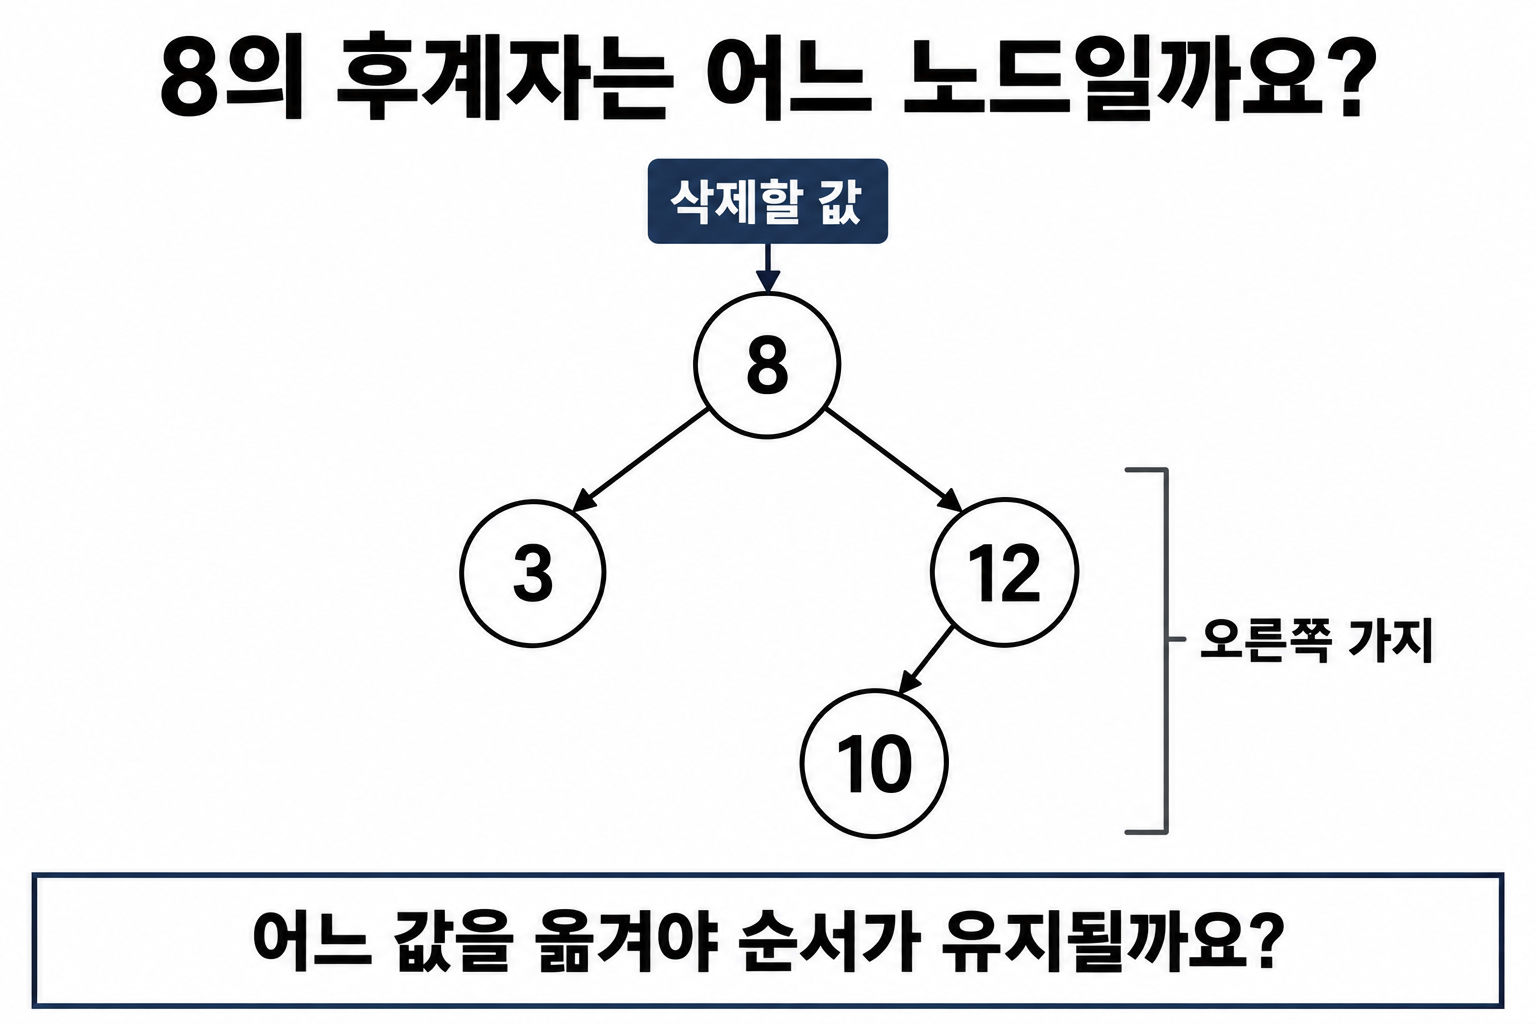
오른쪽 가지의 값은 모두 삭제 대상보다 큽니다. 그중 가장 작은 값은 왼쪽 연결을 끝까지 따라가면 만납니다. 이 값을 후계자라고 합니다. != null은 왼쪽 자리가 null인 경우와 프로퍼티를 생략해 undefined인 경우를 모두 빈자리로 봅니다. 오른쪽 가지의 첫 값 12를 무조건 고르면 그 아래의 9와 10을 어떻게 다시 놓을지 더 복잡해집니다.
확인 문제: 8의 왼쪽이 3, 오른쪽이 12이고 12의 왼쪽이 10이라면 8의 후계자는?
정답은 10입니다. 오른쪽 가지로 한 번 간 뒤 왼쪽으로 끝까지 이동한 값이기 때문입니다.
같은 키가 여러 번 들어오면 개수로 보관할 수 있습니다
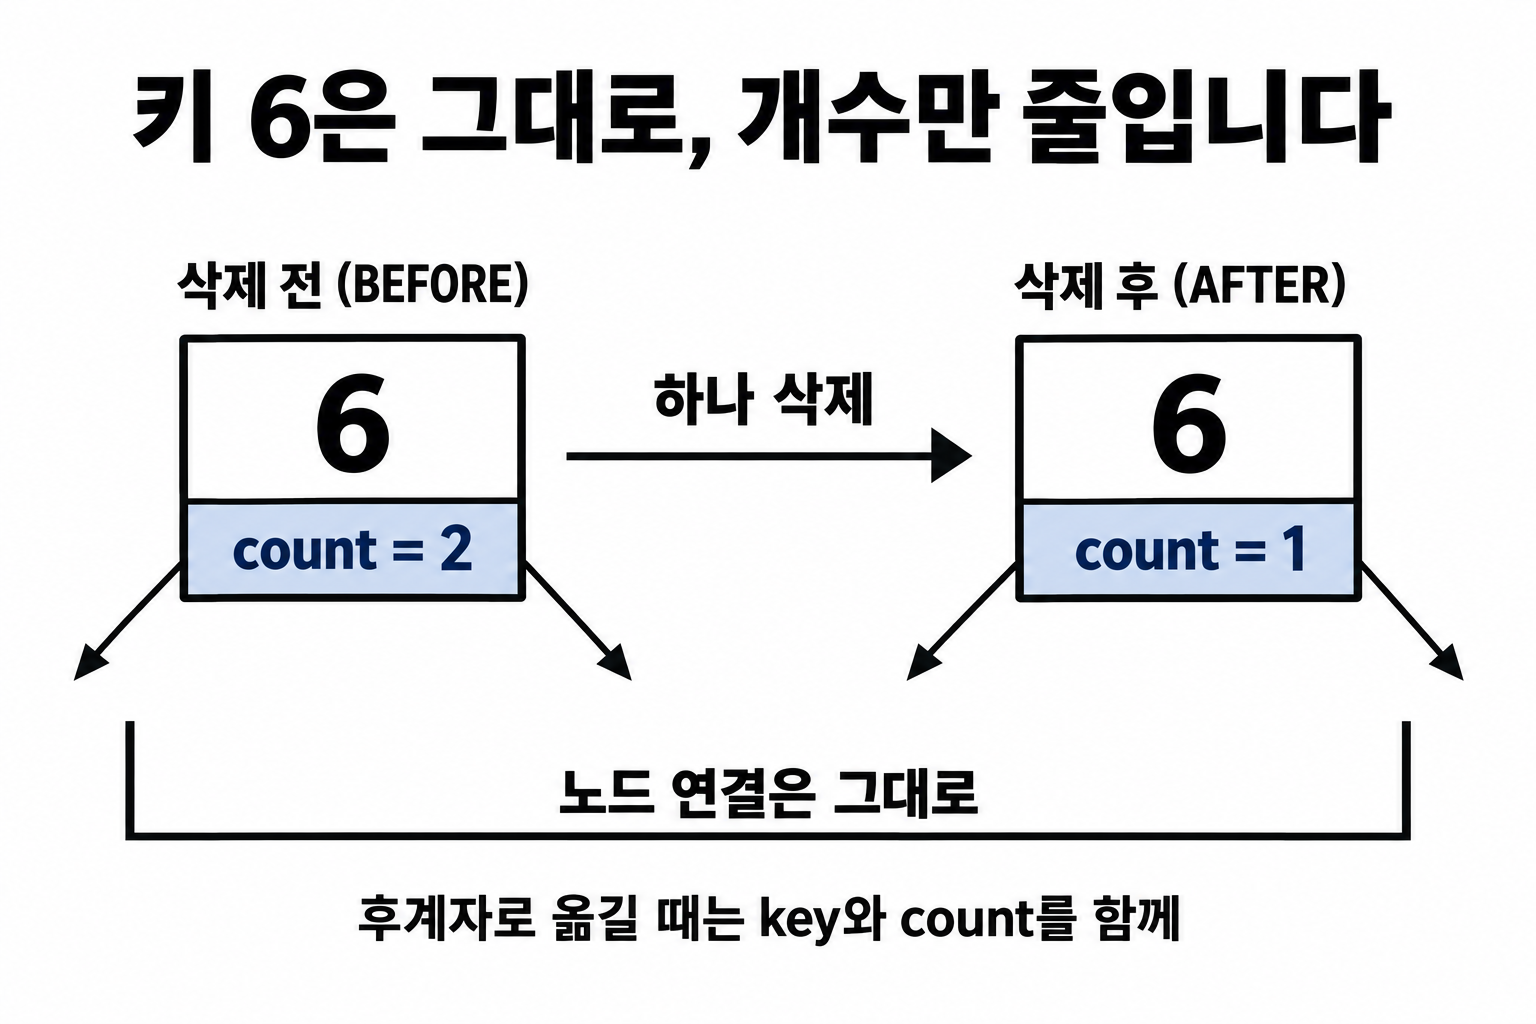
const item = { key: 6, count: 2 };
item.count -= 1;

console.log(item.key);
console.log(item.count);
6 1
같은 6을 별도 노드로 어느 방향에 놓을지 정하는 대신 한 노드의 count를 늘릴 수 있습니다. 하나를 삭제할 때 count가 2 이상이면 연결을 바꾸지 않고 개수만 줄입니다. 자식 둘인 노드를 후계자로 바꿀 때는 후계자의 키뿐 아니라 count도 함께 옮겨야 중복 개수가 사라지지 않습니다.
바로 실행해 보는 핵심 예제
독자 질문: BST에서 자식이 둘인 노드를 지우면 연결을 어떻게 유지하나요?
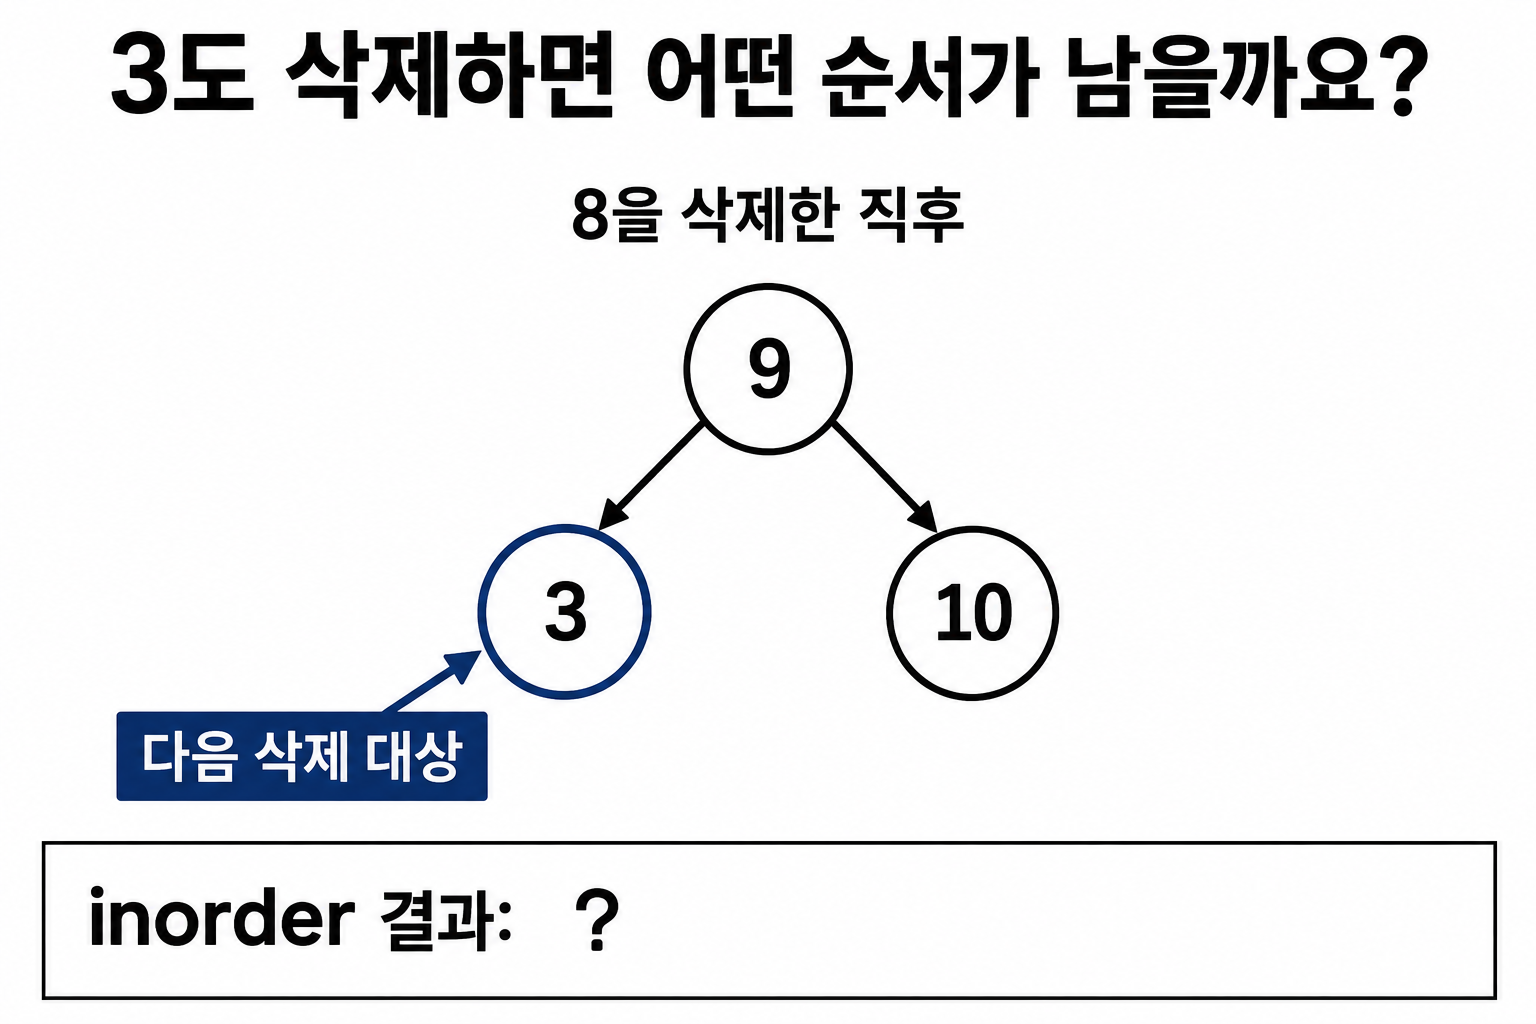
왜 쓰나요? 오른쪽 부분 트리에서 가장 작은 후계자 값으로 교체한 뒤 후계자 노드를 제거합니다. 여기서는 중복 키를 무시합니다.
아래 바닐라 JavaScript 코드는 독립 실행 예제입니다. 본문에서 배운 개념을 새 데이터로 확인합니다. 다른 예제와 같은 콘솔에 이어 붙이지 말고 새 콘솔 또는 새 .cjs 파일에서 실행하세요.
class BST {
  root = null;
  insert(value) {
    const add = (node) => {
      if (!node) return { value, left: null, right: null };
      if (value < node.value) node.left = add(node.left);
      if (value > node.value) node.right = add(node.right);
      return node;
    };
    this.root = add(this.root);
  }
  delete(value) {
    const remove = (node, key) => {
      if (!node) return null;
      if (key < node.value) node.left = remove(node.left, key);
      else if (key > node.value) node.right = remove(node.right, key);
      else {
        if (!node.left) return node.right;
        if (!node.right) return node.left;
        let next = node.right;
        while (next.left) next = next.left;
        node.value = next.value;
        node.right = remove(node.right, next.value);
      }
      return node;
    };
    this.root = remove(this.root, value);
  }
  inorder(node = this.root) {
    return node ? [...this.inorder(node.left), node.value, ...this.inorder(node.right)] : [];
  }
}
const tree = new BST();
[8, 3, 10, 9].forEach((x) => tree.insert(x));
tree.delete(8);
console.log(tree.inorder().join(","));
실행 결과와 비용
이번 검토에서는 Node.js v24.18.0에서 위 독립 예제를 실행해 다음 출력과 일치하는지 확인했습니다.
3,9,10시간·공간 복잡도: 삽입·삭제·탐색은 높이 h에 비례해 O(h): 평균 균형 O(log n), 편향되면 O(n)입니다. 이 예제의 inorder 배열 만들기는 출력 편의를 위한 별도 비용입니다.
직접 풀 문제
위 결과에서 3도 삭제하면 inorder는?
풀이와 기대 결과
9,10입니다. 루트 삭제 뒤 후계자 9가 중복으로 남지 않아야 합니다.
원자료의 다른 학습 순서 (선택)
자료구조 과정 원래 순서의 다음 글: 11 최소 힙으로 가장 우선인 값 꺼내기
검증 범위: 위 독립 예제의 출력만 로컬에서 확인했습니다. 이 글은 독립 자료구조 실습입니다. 실제 브라우저 표시와 모든 입력·플랫폼의 실행은 검증하지 않았습니다.
이제 기존 전체 구현을 읽는 순서
먼저 삽입과 탐색에서 작은 값은 왼쪽, 큰 값은 오른쪽으로 가는지 봅니다. 삭제에서는 count 감소가 먼저인지 확인하고, 그 다음 자식 없음, 자식 하나, 자식 둘의 세 갈래를 위 표와 맞춥니다. 마지막으로 후계자의 키와 count를 옮긴 뒤 원래 후계자 노드를 연결에서 제거하는지 읽으세요.
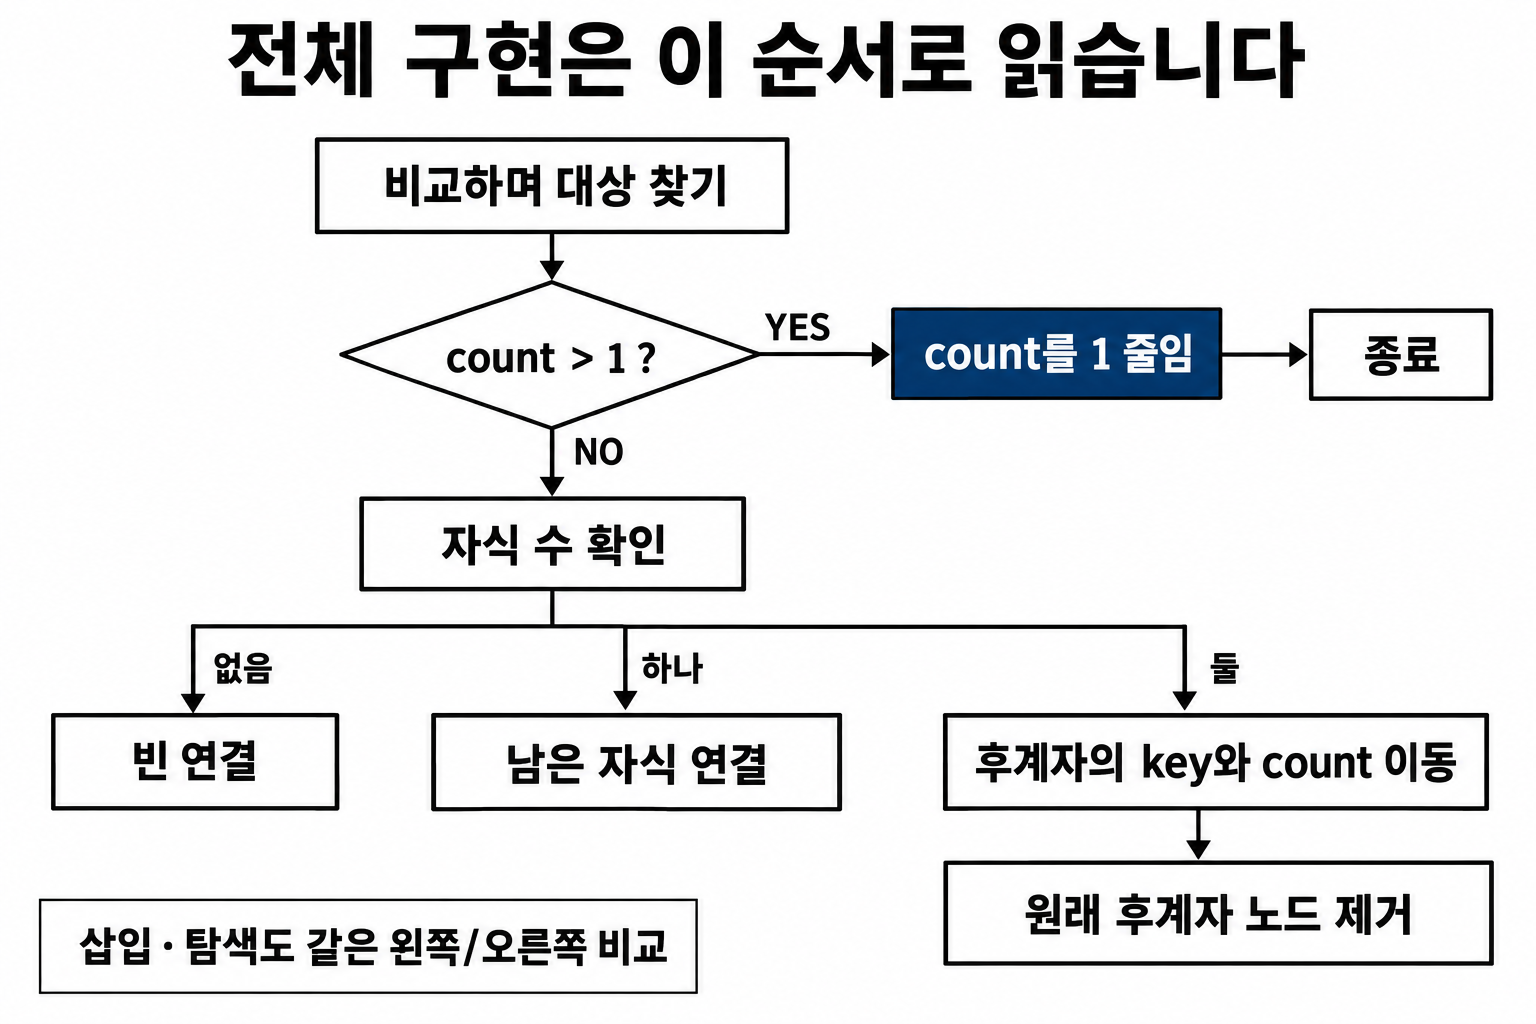
아래 전체 구현에는 범위 검색과 경계 검사도 들어 있습니다. 먼저 다섯 값의 작은 트리로 연결 변화를 이해한 다음 전체 코드를 읽으면 각 조건문의 목적이 훨씬 선명해집니다.
관련 코딩테스트 문제로 이어서 연습합니다
이 자료구조의 블로그 연습 문제와 해설에서 배운 동작을 적용해 보세요. 먼저 작은 예시를 직접 처리한 뒤 입력 전체를 다루는 코드로 확장하면 됩니다. 아래 전체 구현은 연결된 문제의 기존 메서드와 반환 형식을 유지합니다.
전체 구현 · 상세 설명 · 예외와 성능 분석 펼치기
여기부터는 필요한 기능을 골라 읽는 참고 영역입니다. 새로운 파일로 전체 코드를 실행할 때는 아래 Node.js 실행 안내를 따르세요. 앞쪽의 작은 브라우저 실습과 전체 파일을 한 콘솔에 이어 붙이지 마세요. 기능별 입력 조건과 반환 형식은 아래 설명을 기준으로 합니다.
순서 정보를 저장하면 어떤 일이 쉬워지는가
일반 이진 트리는 왼쪽과 오른쪽의 값 관계를 보장하지 않아 특정 값을 찾으려면 모든 노드를 볼 수 있습니다. BST는 각 노드의 왼쪽 부분 트리에 더 작은 키, 오른쪽 부분 트리에 더 큰 키만 두어 한쪽을 제외합니다. 단순 존재 확인뿐 아니라 정렬 순회와 범위 검색이 필요한 상황에 의미가 있습니다.
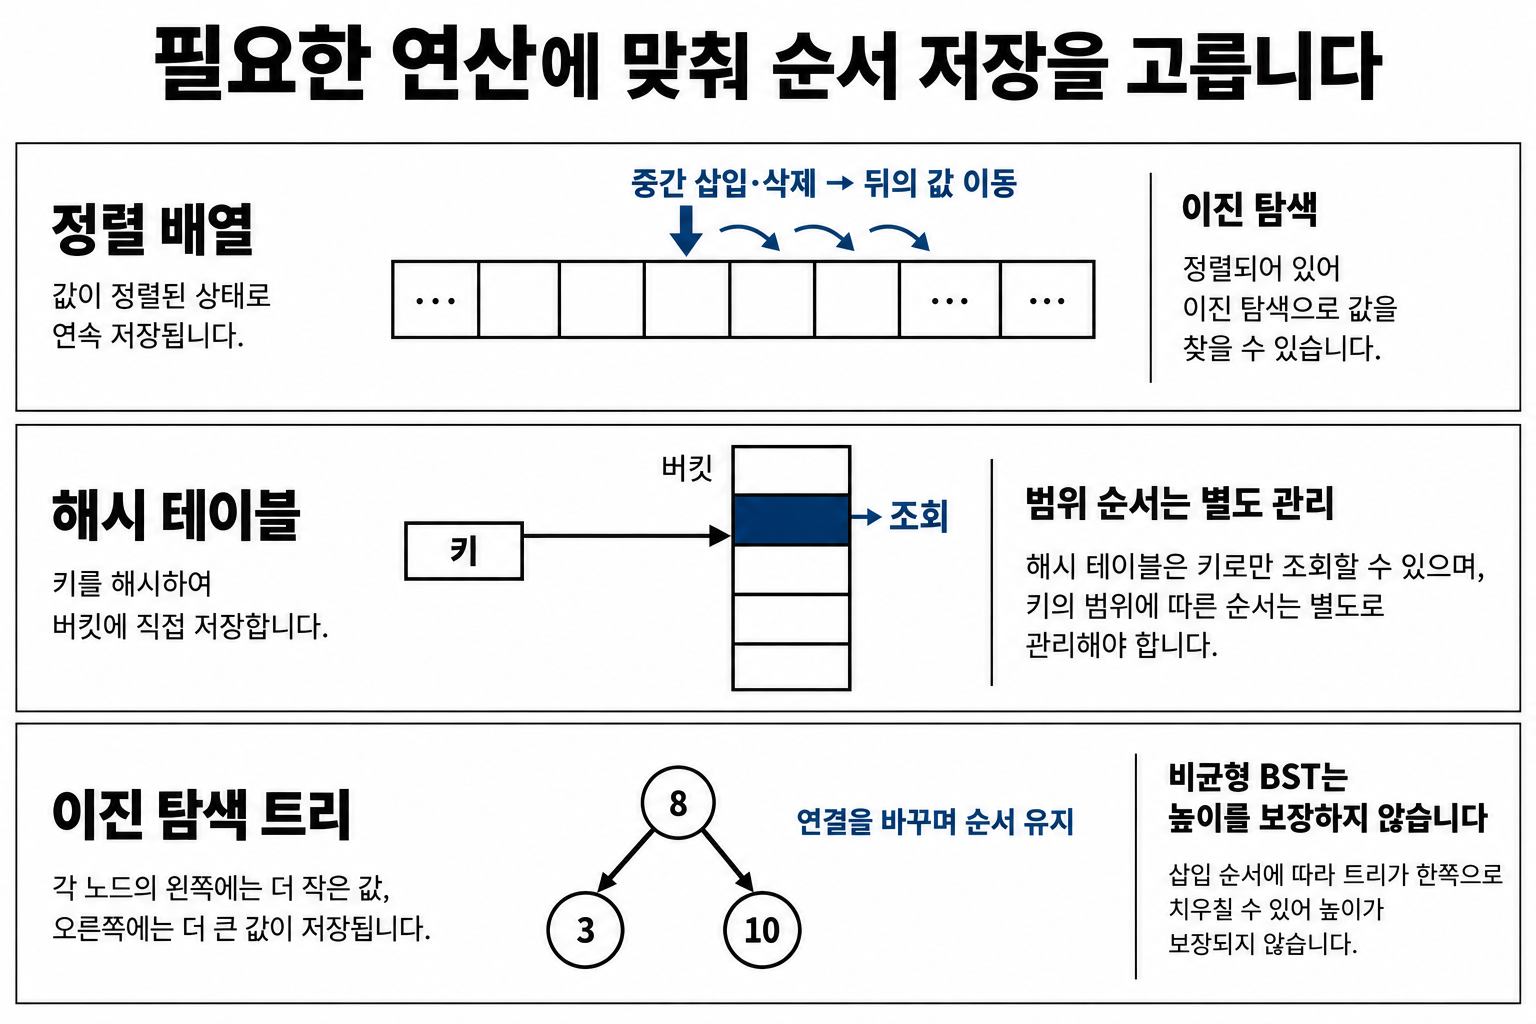
정렬 배열은 이진 탐색이 빠르지만 중간 삽입·삭제에 이동이 필요합니다. 해시 테이블은 정확한 키 조회에 적합하지만 순서에 따른 범위 열거를 직접 지원하지 않습니다. BST는 연결을 바꿔 갱신하면서 순서를 유지하는 선택이며, 이 글의 비균형 BST는 높이까지 보장하지 않는다는 대가가 있습니다.
키·중복·반환값 계약
키는 JavaScript 안전 정수만 허용합니다. NaN은 작다·크다 비교가 모두 false이므로 검사 없이 넣으면 다른 키를 같은 키처럼 처리할 위험이 있습니다. 실수나 문자열 정렬이 필요하다면 모든 메서드에서 일관된 비교 규칙을 별도로 설계해야 합니다.
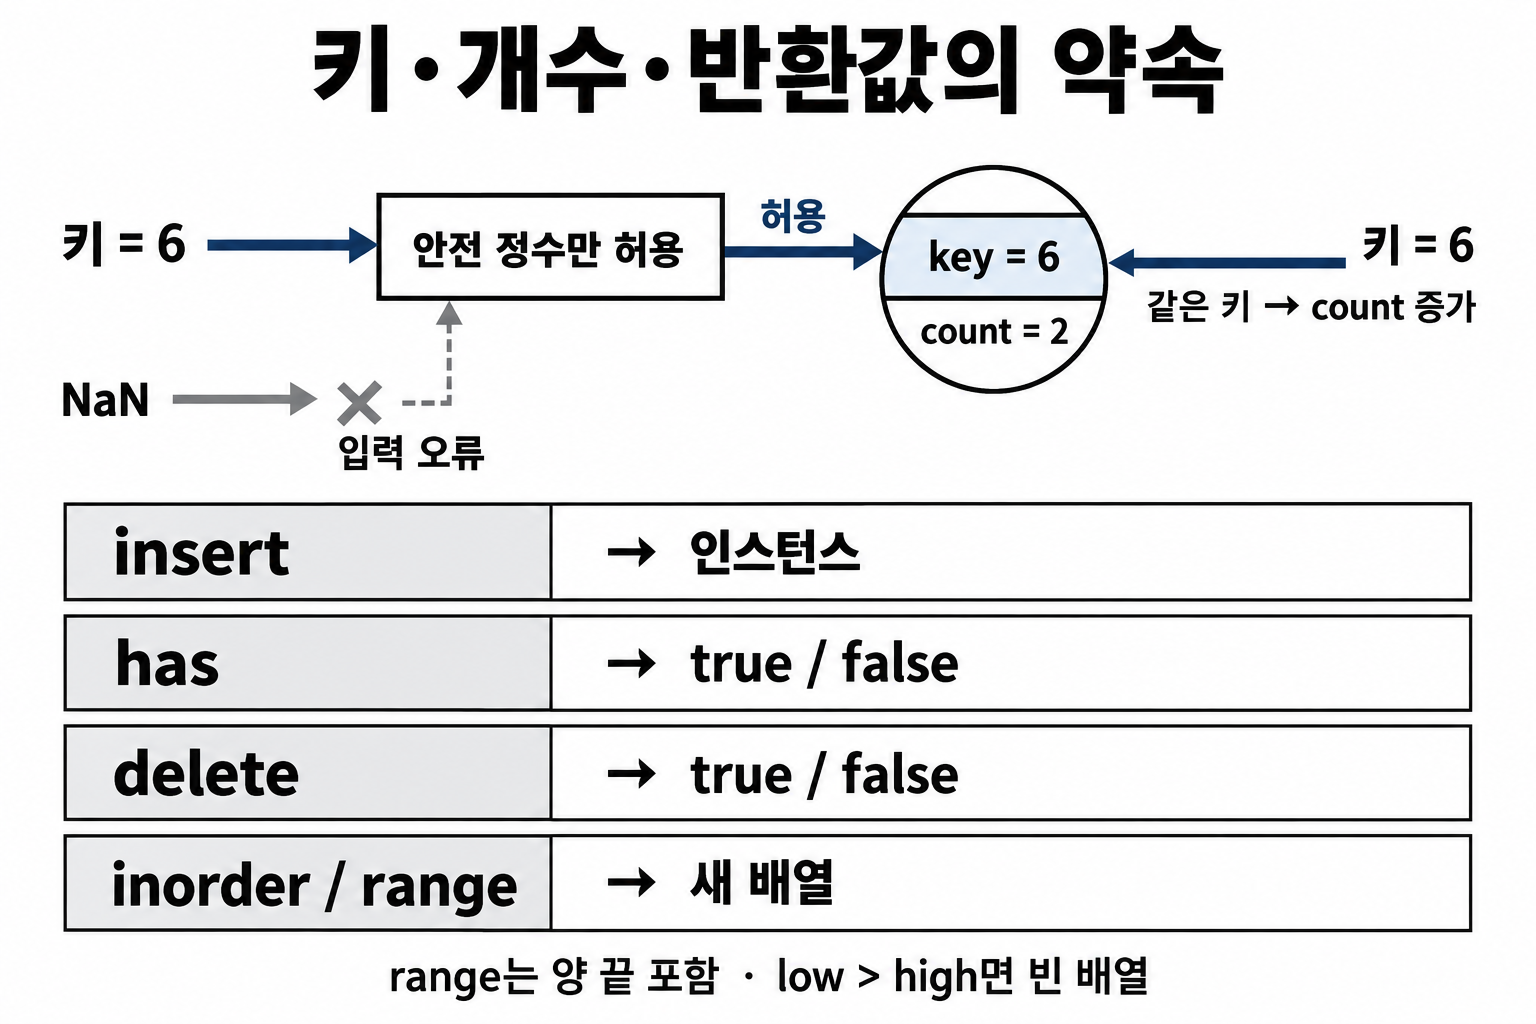
같은 키는 새 노드로 만들지 않고 count를 증가시킵니다. 따라서 부분 트리 간 비교는 엄격한 부등호이고 각 키는 노드 하나에만 존재합니다. delete는 해당 키 한 개만 지워 성공 여부를 반환합니다. count가 2라면 첫 삭제 후 노드는 남고 두 번째 삭제에서 연결 구조를 바꿉니다.
root와 노드는 설명을 위해 노출하지만 외부에서 key·count·연결을 바꾸지 않는 계약입니다. insert는 인스턴스를 반환하고 has는 불리언, inorder와 range는 중복 횟수만큼 키를 담은 새 배열을 반환합니다. 범위는 양 끝을 포함하며 low > high면 빈 배열입니다.
전체 코드와 실행
아래를 bst.cjs로 저장하고 Node.js 터미널에서 node ./bst.cjs로 실행합니다. CommonJS 한 파일에 전체 클래스와 범위 함수, 직접 실행 예제가 들어 있습니다. 재귀 대신 반복문을 사용해 한쪽으로 긴 트리도 호출 스택을 계속 늘리지 않습니다.
'use strict';

function checkKey(key) {
  if (!Number.isSafeInteger(key)) throw new TypeError('key must be a safe integer');
}

function rangeValues(root, low, high) {
  checkKey(low);
  checkKey(high);
  const result = [];
  if (low > high) return result;
  const stack = [];
  let current = root;
  while (current != null || stack.length > 0) {
    while (current != null) {
      if (current.key < low) {
        current = current.right;
      } else {
        stack.push(current);
        current = current.left;
      }
    }
    if (stack.length === 0) break;
    current = stack.pop();
    if (current.key > high) break;
    for (let copy = 0; copy < current.count; copy += 1) {
      result.push(current.key);
    }
    current = current.right;
  }
  return result;
}

class BinarySearchTree {
  constructor() {
    this.root = null;
  }

  insert(key) {
    checkKey(key);
    const fresh = { key, count: 1, left: null, right: null };
    if (this.root === null) {
      this.root = fresh;
      return this;
    }
    let current = this.root;
    while (true) {
      if (key === current.key) {
        current.count += 1;
        return this;
      }
      const side = key < current.key ? 'left' : 'right';
      if (current[side] === null) {
        current[side] = fresh;
        return this;
      }
      current = current[side];
    }
  }

  has(key) {
    checkKey(key);
    let current = this.root;
    while (current !== null) {
      if (key === current.key) return true;
      current = key < current.key ? current.left : current.right;
    }
    return false;
  }

  delete(key) {
    checkKey(key);
    let parent = null;
    let current = this.root;
    while (current !== null && current.key !== key) {
      parent = current;
      current = key < current.key ? current.left : current.right;
    }
    if (current === null) return false;
    if (current.count > 1) {
      current.count -= 1;
      return true;
    }

    if (current.left !== null && current.right !== null) {
      let successorParent = current;
      let successor = current.right;
      while (successor.left !== null) {
        successorParent = successor;
        successor = successor.left;
      }
      current.key = successor.key;
      current.count = successor.count;
      if (successorParent === current) {
        successorParent.right = successor.right;
      } else {
        successorParent.left = successor.right;
      }
      return true;
    }

    const child = current.left !== null ? current.left : current.right;
    if (parent === null) {
      this.root = child;
    } else if (parent.left === current) {
      parent.left = child;
    } else {
      parent.right = child;
    }
    return true;
  }

  range(low, high) {
    return rangeValues(this.root, low, high);
  }

  inorder() {
    return this.range(Number.MIN_SAFE_INTEGER, Number.MAX_SAFE_INTEGER);
  }
}

module.exports = { BinarySearchTree, rangeValues };

if (require.main === module) {
  const tree = new BinarySearchTree();
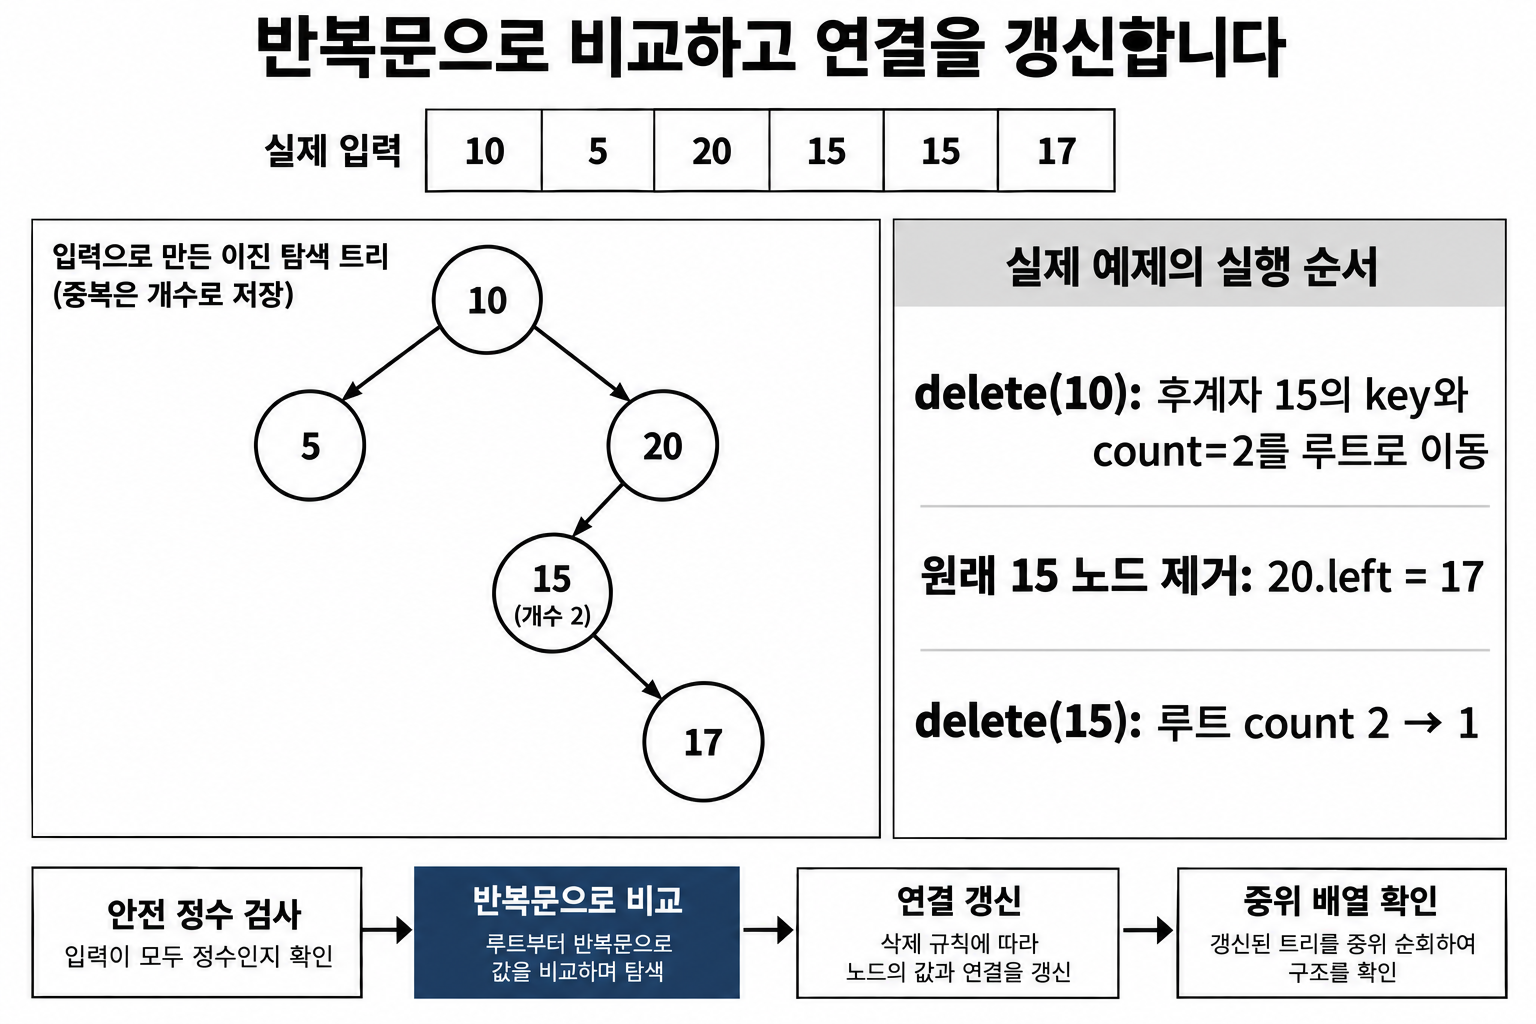
  for (const key of [10, 5, 20, 15, 15, 17]) tree.insert(key);
  const before = tree.inorder();
  tree.delete(10);
  const afterRoot = tree.inorder();
  tree.delete(15);
  console.log(JSON.stringify({ before, afterRoot, afterOne: tree.inorder(), found: tree.has(10) }));
}
실행 출력
{"before":[5,10,15,15,17,20],"afterRoot":[5,15,15,17,20],"afterOne":[5,15,17,20],"found":false}삽입과 탐색: 같은 비교로 같은 경로를 따라갑니다
insert는 현재 노드와 비교해 left 또는 right를 선택합니다. 빈 연결을 만나면 그 위치에 새 노드를 연결합니다. 처음부터 root가 비어 있으면 루트를 만드는 별도 분기가 필요합니다. 중복이면 count만 증가시켜 같은 키가 양쪽에 흩어지는 상황을 막습니다.
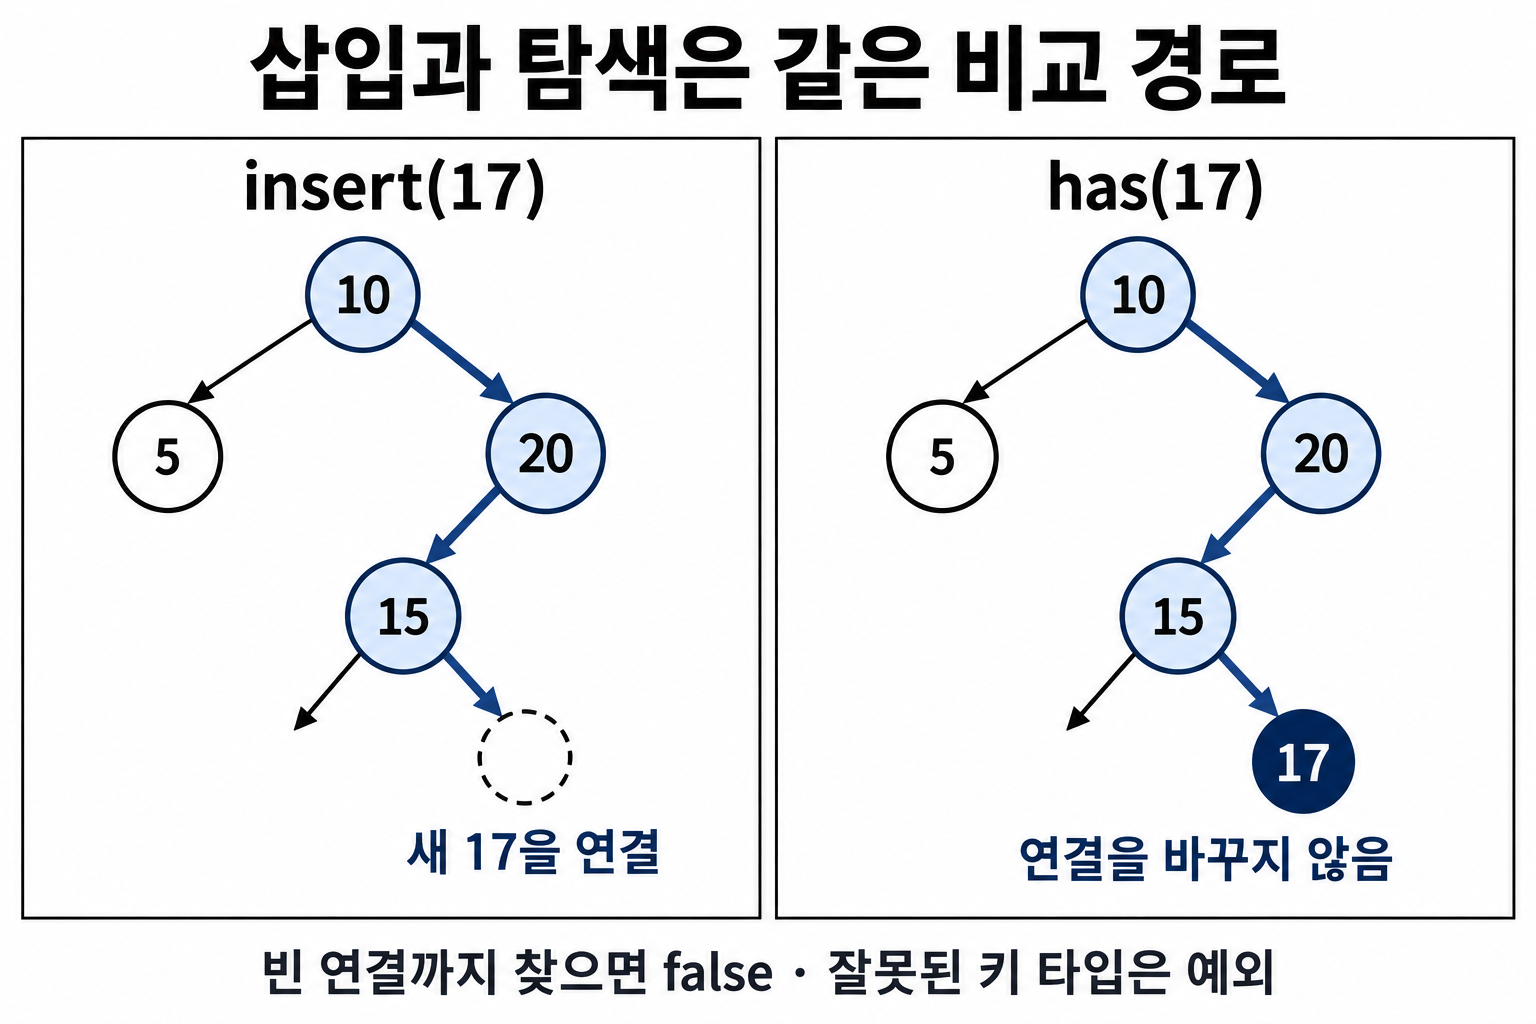
has도 같은 경로를 따르지만 연결을 만들지 않습니다. null에 도착하면 그 키가 들어갈 자리가 비었다는 뜻입니다. 검색 실패를 예외가 아니라 false로 돌려주는 이유는 정상적인 조회 결과이기 때문입니다. 반면 잘못된 키 타입은 입력 계약 위반으로 예외를 던집니다.
삭제는 어느 연결을 다시 이어야 하는가
삭제 대상을 찾는 동안 parent를 함께 기억합니다. 목표 노드가 없어졌을 때 부모가 어느 자식을 가리켜야 하는지 바꾸기 위해서입니다. 대상이 루트인 경우에는 부모가 없으므로 this.root 자체를 교체해야 합니다. 이 구분을 놓치면 루트 삭제만 실패합니다.
| 대상 상태 | 처리 | 유지되는 조건 |
|---|---|---|
| 없음 | false 반환 | 트리를 바꾸지 않음 |
| count > 1 | count를 1 줄임 | 키당 노드 하나 |
| 자식 없음 | 부모 연결을 null로 | 나머지 키의 순서 유지 |
| 자식 하나 | 부모 연결을 그 자식으로 | 해당 부분 트리의 키 범위 유지 |
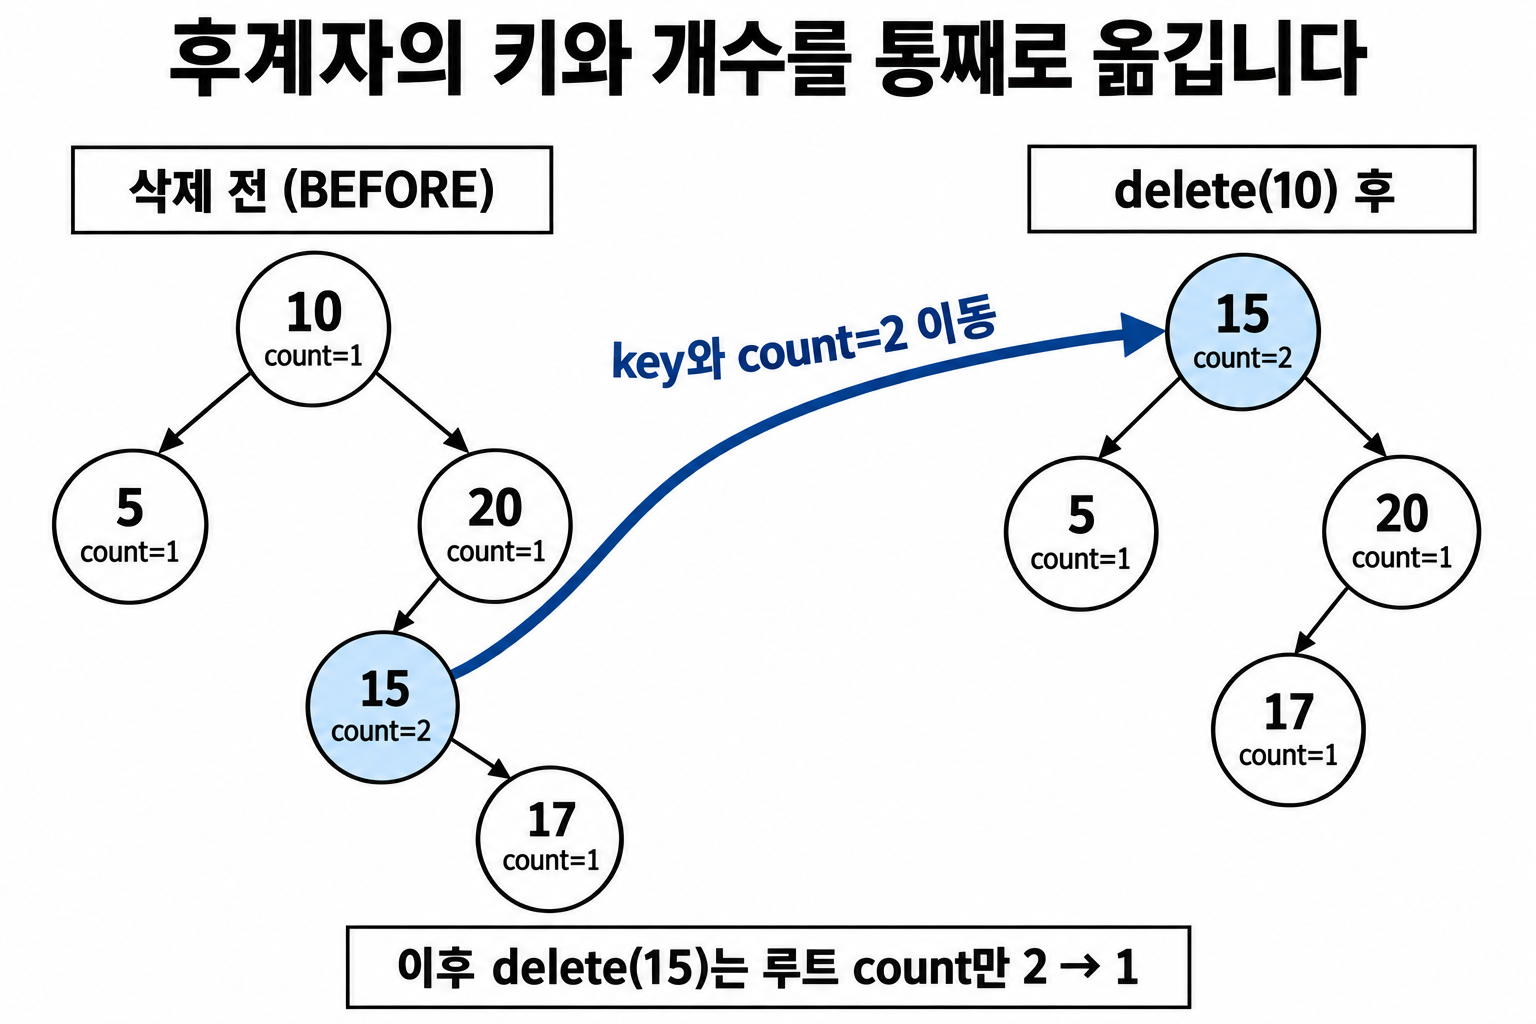
| 자식 둘 | 오른쪽 최솟값의 key와 count 이동 후 후계자 노드 제거 | 왼쪽 < 새 키 < 오른쪽 |
자식이 둘이면 한쪽만 부모에 연결할 수 없으므로 중위 후계자를 사용합니다. 오른쪽 부분 트리에서 가장 왼쪽에 있는 노드는 대상보다 큰 키 중 최솟값입니다. 후계자에게 왼쪽 자식은 없으므로 그 노드의 제거는 오른쪽 자식 하나를 올려 잇는 문제로 줄어듭니다.
중복 정책 때문에 후계자의 key뿐 아니라 count 전체를 옮깁니다. 예를 들어 15가 두 개면 현재 노드에 15×2를 담고 원래 후계자 노드는 통째로 제거합니다. 일반 delete(15)를 한 번 호출해 count만 줄이면 두 노드에 같은 키가 남아 엄격한 순서 불변식이 깨집니다.
| 작업 | 중위 결과 | 상태 해석 |
|---|---|---|
| 10,5,20,15,15,17 삽입 | 5,10,15,15,17,20 | 루트 10, 오른쪽 최솟값 15×2 |
| delete(10) | 5,15,15,17,20 | 루트에 15×2 이동, 20.left는 17 |
| delete(15) | 5,15,17,20 | 루트 count만 2→1 |
| has(10) | false | 10은 더 이상 저장되지 않음 |
후계자가 바로 오른쪽 자식이면 successorParent가 current입니다. 이때는 current.right를 후계자의 오른쪽 자식으로 바꿉니다. 더 깊은 왼쪽 경로에 있었다면 successorParent.left를 바꿉니다. 두 경우를 분리해야 바로 옆 후계자에서 자기 참조나 연결 손실이 생기지 않습니다.
범위 검색은 중위 순회에서 불가능한 가지를 건너뜁니다
rangeValues에서 current.key < low이면 그 노드와 왼쪽 전체가 범위 밖이므로 오른쪽으로 바로 이동합니다. 나머지는 왼쪽을 먼저 방문하는 중위 순서로 스택에 쌓습니다. 꺼낸 키가 high를 넘으면 이후 키도 모두 더 크므로 전체 반복을 끝냅니다. 범위 안의 키는 count번 출력합니다.
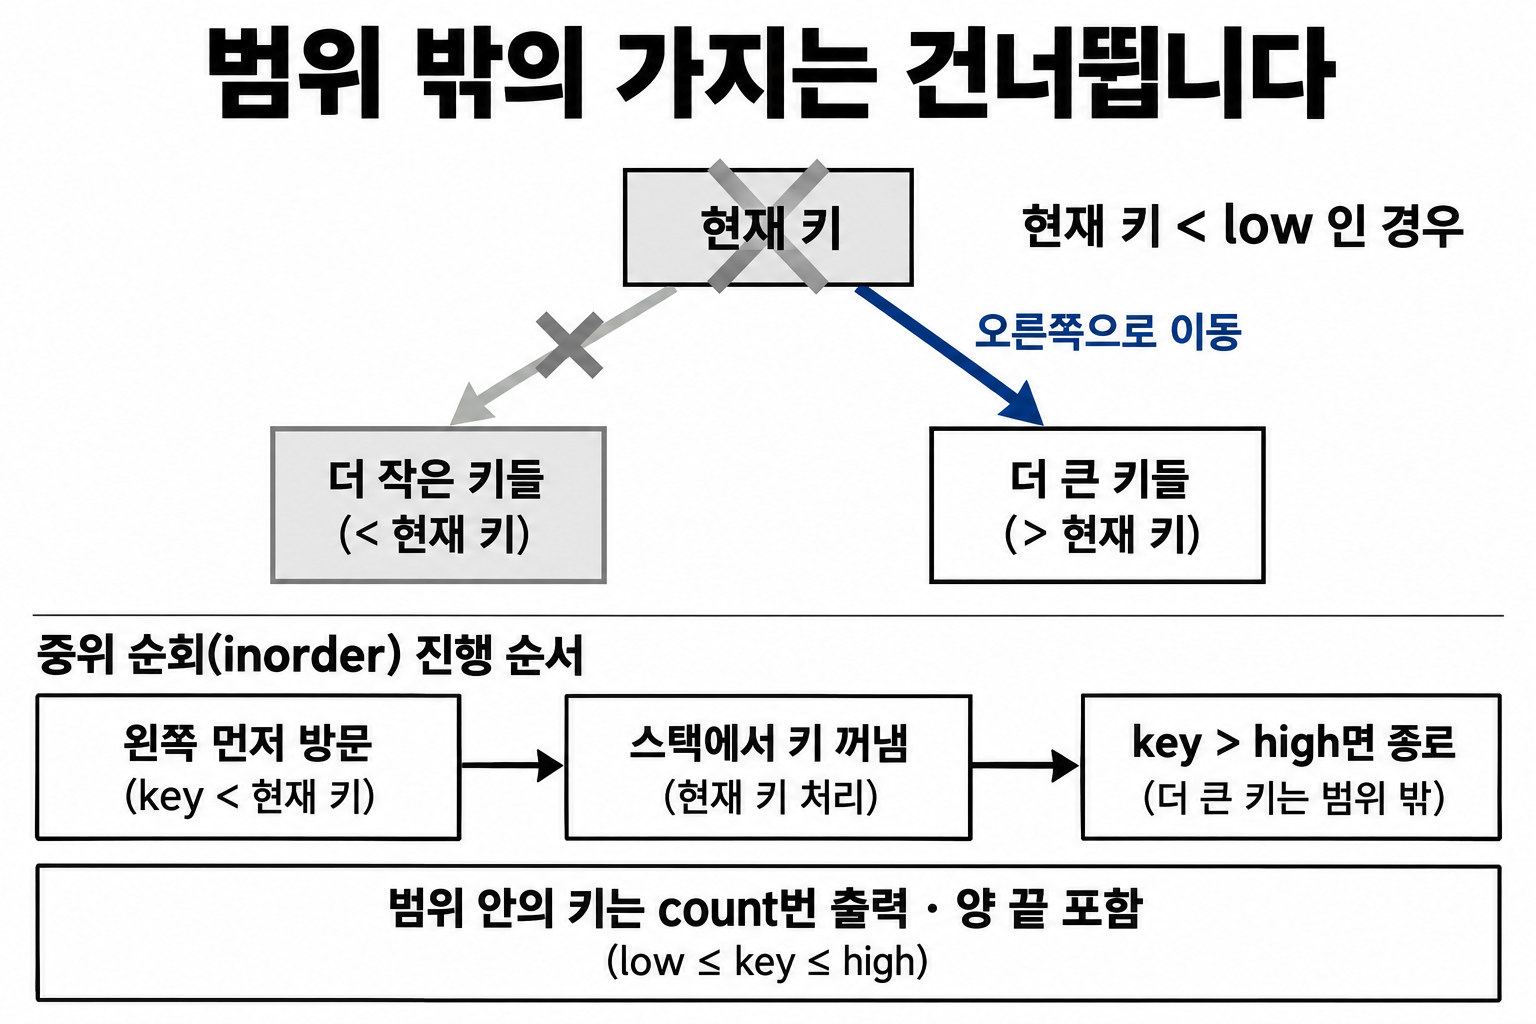
inorder는 안전 정수 전체를 범위로 지정해 같은 함수를 재사용합니다. 별도 중위 구현을 복사하지 않으므로 중복 확장 규칙이 서로 달라지지 않습니다. 다만 count가 매우 크면 반환 배열도 그만큼 커지므로 키별 개수만 필요할 때는 [key,count] 형태로 반환하는 별도 API가 적합합니다.
최악 O(n)을 숨기지 않는 복잡도
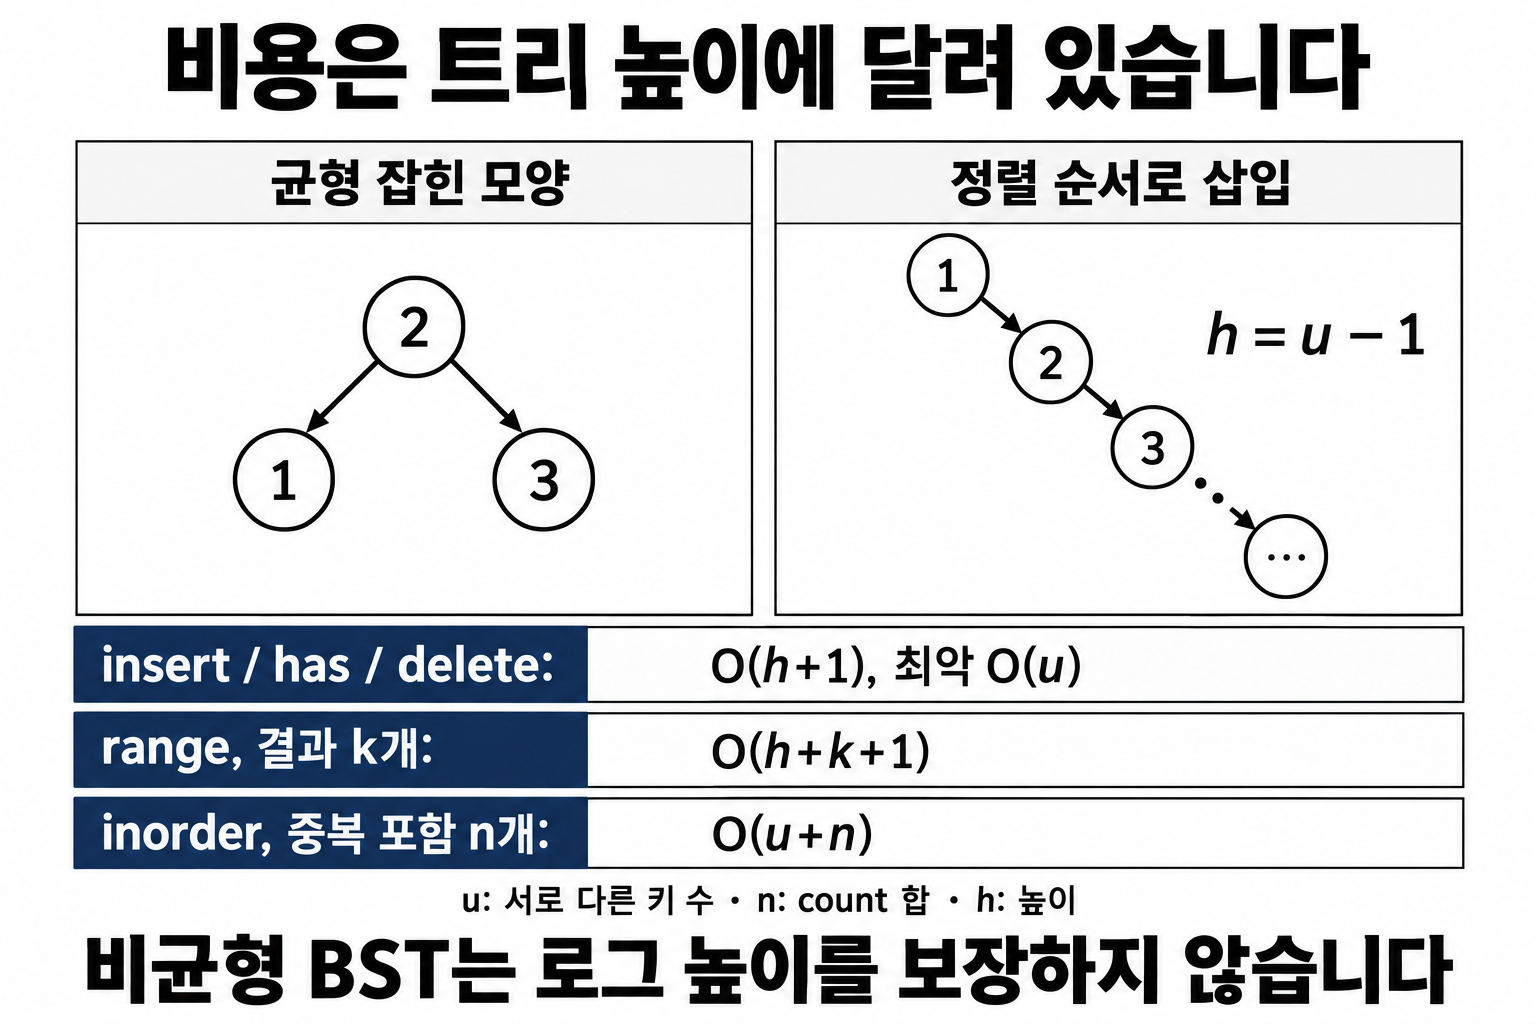
| 연산 | 시간 | 반환 결과 제외 보조 공간 |
|---|---|---|
| insert / has / delete | O(h+1), 최악 O(u) | O(1) |
| range, 결과 k개 | O(h+k+1), 최악 O(u+k) | O(h+1) |
| inorder, 전체 중복 포함 n개 | O(u+n) | O(h+1) |
| 저장 공간 | 서로 다른 키 u개 노드 | O(u) |
u는 서로 다른 키 수, n은 count 합, h는 높이입니다. 삽입 순서가 1,2,3,…이면 높이가 u-1인 연결 리스트 같은 모양이 됩니다. 균형 잡힌 모양이나 특정 무작위 삽입 모델에서 평균 로그 높이를 기대할 수 있지만, 이 삭제 방식을 반복한다고 균형이 보장되지는 않습니다. 최악 로그 시간이 필요하면 AVL이나 레드-블랙 트리를 선택해야 합니다.
경계 확인과 연습
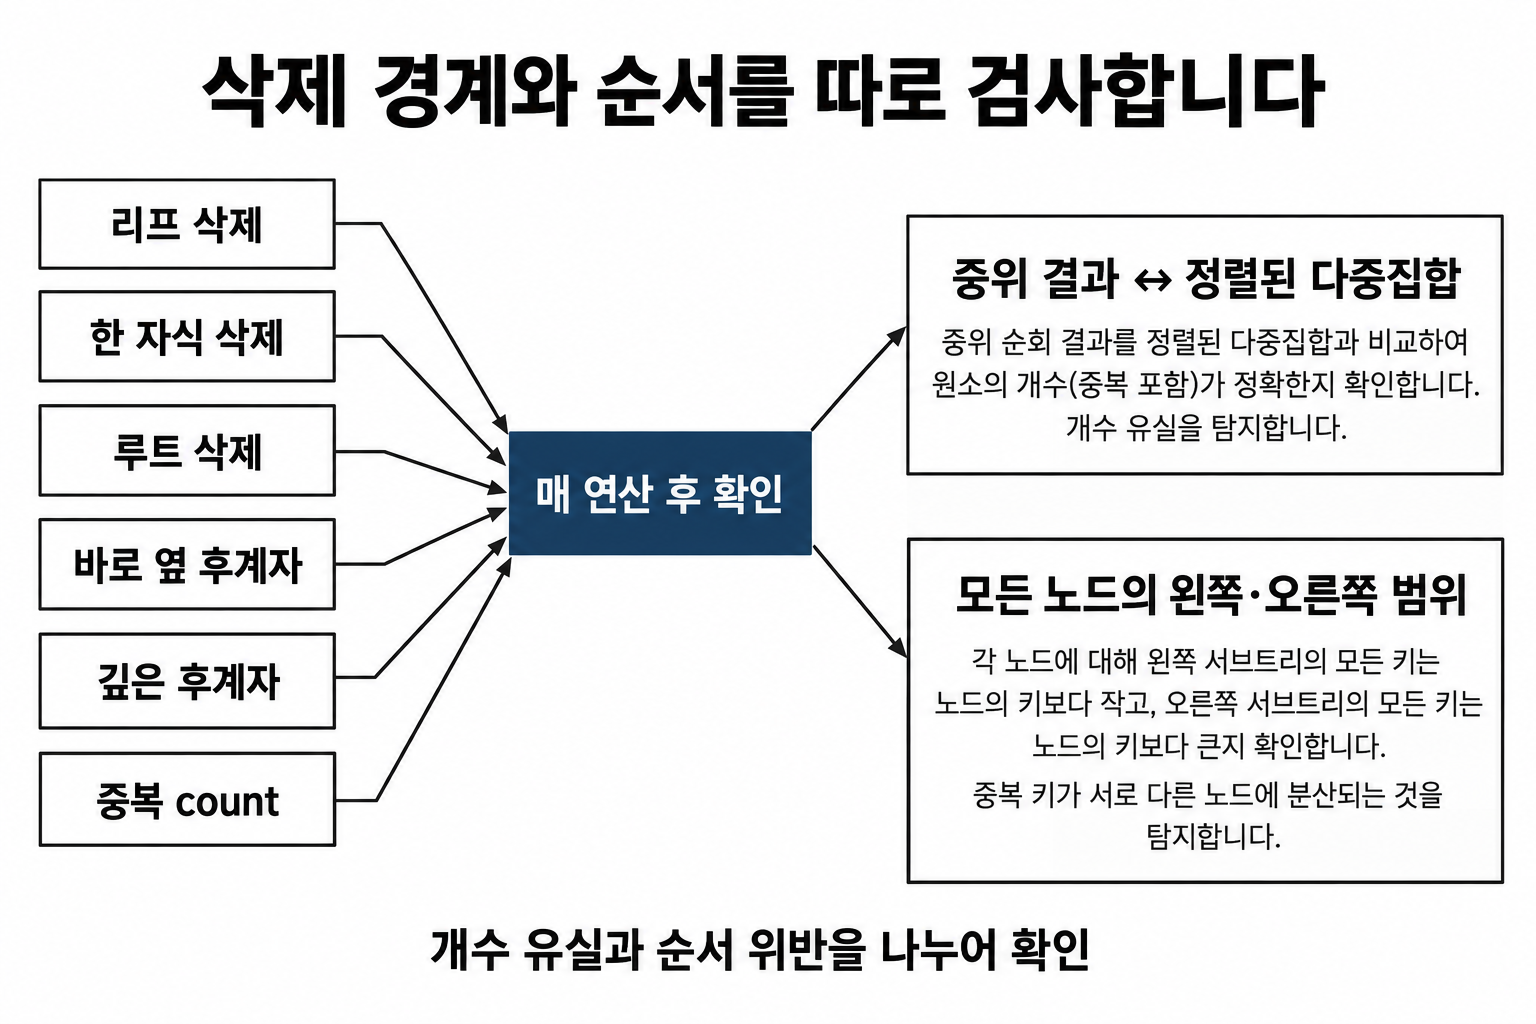
리프 삭제, 한 자식 삭제, 루트 삭제, 바로 오른쪽인 후계자, 깊은 후계자와 중복 count를 별도로 확인하세요. 매 연산 후 중위 결과를 정렬된 다중집합과 비교하면 개수 유실을 찾을 수 있고, 모든 노드의 좌우 범위를 재검사하면 중복 키가 두 노드에 나뉜 오류도 찾을 수 있습니다.
함께 연습하고 확인할 자료
Delete Node in a BST: BST 노드 삭제를 연습하는 외부 문제입니다. 이 글의 count 중복 정책과 달리 공식 입력의 키 조건을 따르세요.
관련 개념 참고: Princeton Algorithms — Binary Search Trees 공식 자료와 문제 페이지는 2026년 9월 10일 확인했습니다. 외부 문제의 지문·예시를 복제하지 않고 이 글의 예제와 창작 문제를 별도로 구성했습니다.
두 자식 삭제에서 대체 키의 중복 개수까지 옮깁니다
두 자식이 있는 노드의 키는 왼쪽 부분 트리의 최댓값인 전임자 또는 오른쪽 부분 트리의 최솟값인 후계자로 바꿀 수 있습니다. 전임자는 오른쪽 자식이 없고 후계자는 왼쪽 자식이 없으므로, 대체 노드를 실제로 제거하는 단계는 자식이 최대 한 개인 경우로 줄어듭니다. 현재 구현은 후계자를 사용합니다. 어떤 쪽을 택하든 대체 노드의 남은 자식을 원래 부모에 다시 연결하고, 루트가 바뀌는 경우도 같은 순서 불변식을 지켜야 합니다.
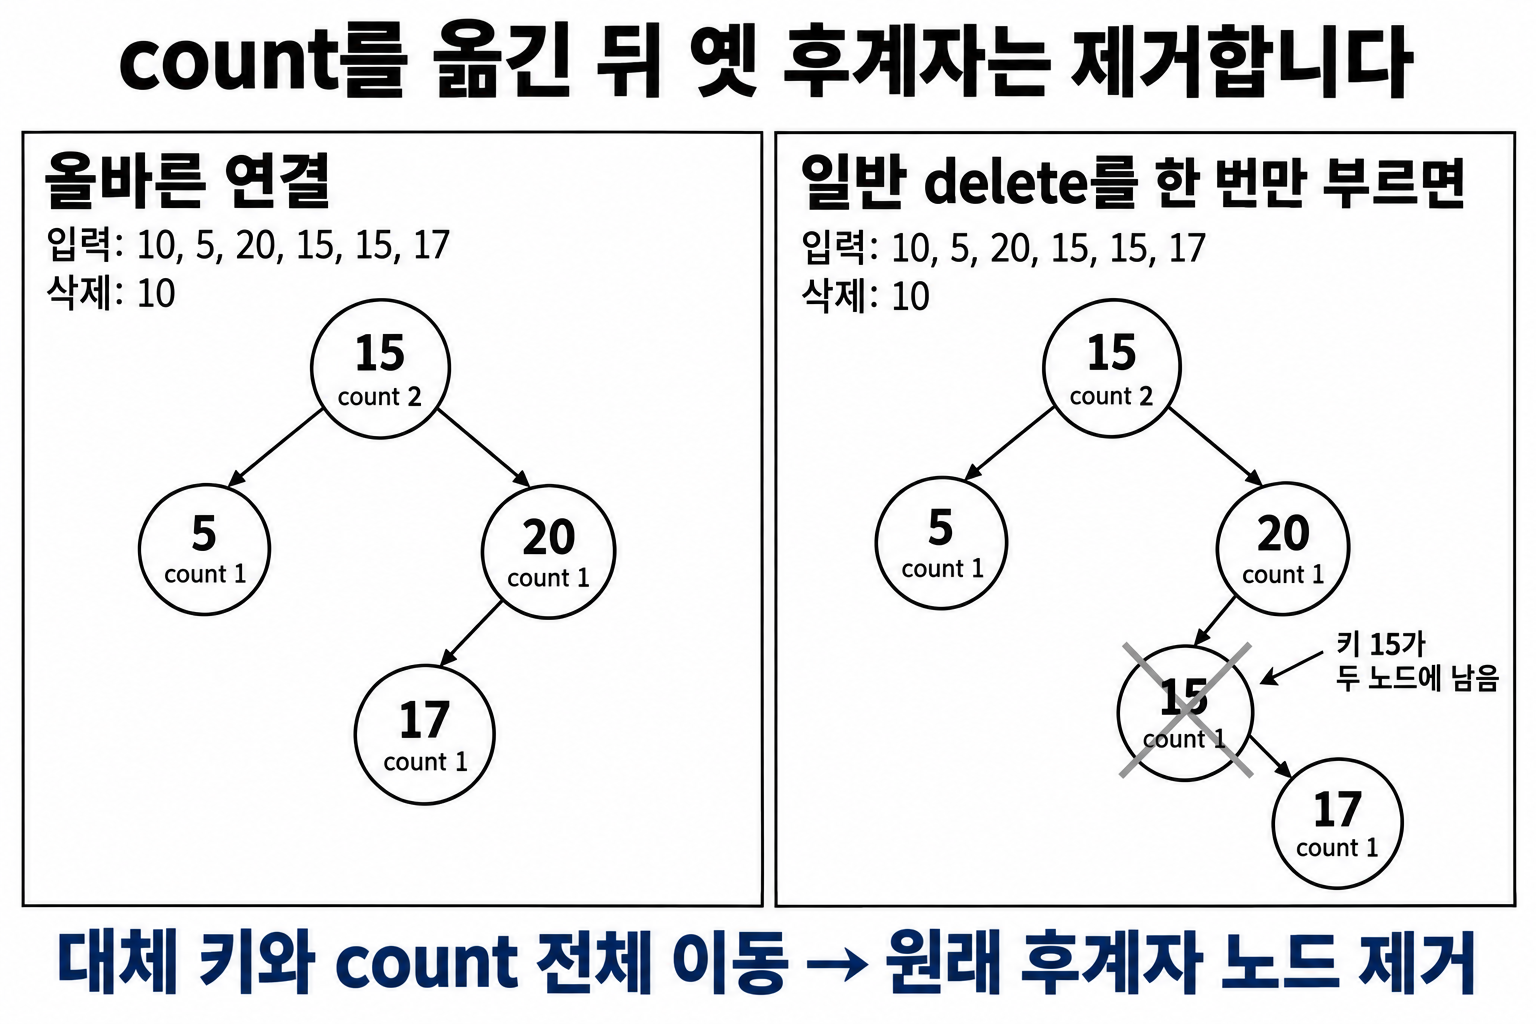
중복을 노드의 count에 모으는 현재 계약에서는 삭제 대상의 count가 2 이상이면 먼저 1만 줄입니다. 대상 count가 1이고 후계자의 count가 2라면 후계자 키와 count=2를 함께 옮기고, 후계자 노드를 물리적으로 제거합니다. 후계자에 일반 delete를 한 번만 적용해 count를 1로 줄이면 같은 키가 두 노드에 나뉘어 남습니다. 예를 들어 [10,5,20,15,15,17]에서 10 하나를 지운 뒤 중위 결과는 [5,15,15,17,20]이어야 합니다. 후계자 15의 오른쪽 자식 17도 20의 왼쪽 연결로 보존되어야 합니다.
이어서 공부할 개념
첨부 BST의 BinaryTree: 연결 분리와 키 삭제의 차이
첨부 자료의 binarySearchTree.mjs는 첫 줄에서 binaryTree.mjs의 BinaryTree를 가져옵니다. 보조 파일은 data와 좌우 자식 연결, 세 순회, 자식 연결 분리만 담당합니다. “작은 키는 왼쪽, 큰 키는 오른쪽”이라는 비교와 삭제 대상 찾기는 이 파일이 아니라 BinarySearchTree가 담당합니다.
removeLeftSubTree는 특정 키 하나를 찾지 않습니다
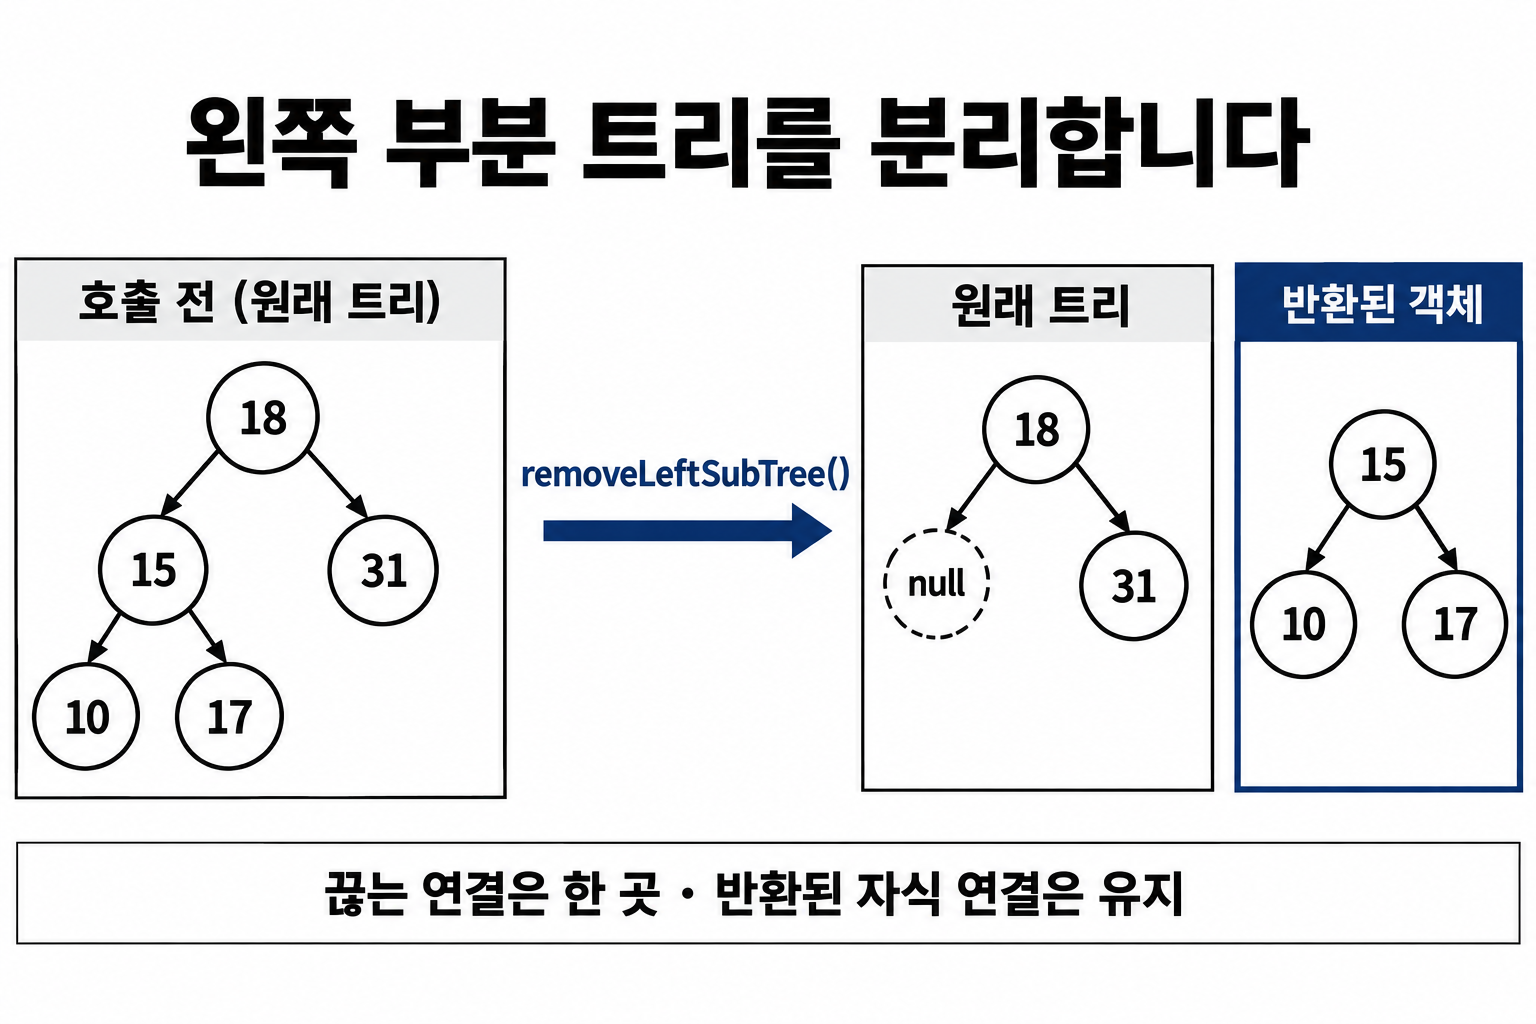
원본 removeLeftSubTree()는 현재 왼쪽 자식을 지역 변수에 보관하고, 현재 노드의 왼쪽 연결을 null로 바꾼 뒤 그 자식 객체를 반환합니다. 재귀 호출이나 키 비교는 없습니다. 오른쪽 버전도 대칭입니다. 왼쪽 부분 트리에 여러 노드가 있으면 현재 트리에서 그 부분 전체가 분리되며, 반환된 객체의 자식 연결은 남습니다.
| 단계 | 18의 왼쪽 연결 | 분리한 객체 |
|---|---|---|
| 호출 전 | 15를 가리킴 | 15.left=10, 15.right=17 |
| 15 참조 보관 | 여전히 15 | 같은 객체를 지역 변수도 가리킴 |
| 왼쪽을 null로 설정 | null | 15와 그 자식 10·17은 유지 |
| 반환 | null | 15 객체 반환; 원래 왼쪽이 비었으면 null 반환 |
여기서 “제거”는 연결 한 곳을 끊는다는 뜻입니다. 반환값을 변수에 보관하면 그 부분 트리를 계속 읽거나 다른 곳에 연결할 수 있습니다. JavaScript 객체를 강제로 파괴하는 연산이 아니며, 반환된 15 객체가 더는 자식을 갖지 않는다고 가정하면 안 됩니다. 원본 노드에는 부모 속성도 없으므로 힙판의 getParent()를 호출할 수 없습니다.
키 하나를 지우려면 호출자가 나머지 연결을 보존해야 합니다
리프라면 부모 연결을 null로 바꿀 수 있습니다. 자식 하나인 노드라면 그 자식을 부모에 이어야 합니다. 자식 둘인 노드라면 전임자나 후계자의 값으로 대체하고 대체 노드의 남은 자식을 다시 이어야 합니다. 보조 setter는 값을 대입할 뿐 이 판단을 대신하지 않습니다. 현재 BST 전체 구현에 있는 세 삭제 분기를 이 연결 관점으로 다시 읽어 보세요.
| 구분 | 첨부 원본 | 이 글의 기존 전체 구현 |
|---|---|---|
| 중복 키 | insert에서 같은 값이면 새 노드 없이 종료 | 하나의 노드에 count 누적 |
| 찾기 | search는 노드 또는 null | has는 true 또는 false |
| 키 삭제 | remove는 노드 또는 undefined | delete는 성공 여부 true 또는 false |
| 두 자식 대체 | 왼쪽 부분 트리의 최댓값인 전임자 | 오른쪽 부분 트리의 최솟값인 후계자와 count 전체 이동 |
| 노드의 연결 분리 | removeLeftSubTree는 자식 객체 또는 null | delete 내부에서 parent/root 연결 갱신 |
전임자와 후계자는 모두 올바른 선택입니다. 원본의 메서드 이름만 현재 구현에 대입하거나, 원본이 반환한 노드를 불리언과 같은 API라고 보지 마세요. 아래 독립 예제는 원본 보조 클래스의 분리 동작만 확인합니다. 본문의 안전 정수·count·delete/has 계약은 계속 그대로 사용합니다.
세 순회 메서드의 if (tree == null) return은 빈 가지에서 멈추는 조건입니다. 원본은 결과 배열을 반환하지 않고 콘솔에 한 값씩 출력합니다. 중위 출력이 오름차순이 되려면 연결을 만든 호출자가 BST의 순서 조건을 지켜야 합니다. 이 보조 파일만으로는 잘못 연결한 큰 왼쪽 값이나 사이클을 찾아내지 못합니다.
추가 예제 코드와 실행 방법 펼치기
직접 실행할 때만 펼쳐 보세요. Node.js 시작 안내를 확인하고 detach-binary-subtree.mjs로 저장합니다.
// 원본 BinaryTree에서 부분 트리 분리에 필요한 메서드를 분리했습니다.
class BinaryTree {
  constructor(data, leftTree = null, rightTree = null) {
    this.data = data;
    this.leftSubTree = leftTree;
    this.rightSubTree = rightTree;
  }
  getData() { return this.data; }
  setData(data) { this.data = data; }
  getLeftSubTree() { return this.leftSubTree; }
  getRightSubTree() { return this.rightSubTree; }
  setLeftSubTree(tree) { this.leftSubTree = tree; }
  setRightSubTree(tree) { this.rightSubTree = tree; }
  removeLeftSubTree() {
    const deletingNode = this.getLeftSubTree();
    this.setLeftSubTree(null);
    return deletingNode;
  }
  removeRightSubTree() {
    const deletingNode = this.getRightSubTree();
    this.setRightSubTree(null);
    return deletingNode;
  }
}

const left = new BinaryTree(15, new BinaryTree(10), new BinaryTree(17));
const root = new BinaryTree(18, left, new BinaryTree(31));
const detached = root.removeLeftSubTree();
console.log(detached === left);
console.log(JSON.stringify({
  rootLeft: root.getLeftSubTree(),
  detached: detached.getData(),
  keptLeft: detached.getLeftSubTree().getData(),
  keptRight: detached.getRightSubTree().getData()
}));
console.log(root.removeLeftSubTree() === null);
console.log(root.getRightSubTree().getData());
파일이 있는 폴더의 터미널에서 실행합니다.
node detach-binary-subtree.mjs기대 출력
true
{"rootLeft":null,"detached":15,"keptLeft":10,"keptRight":17}
true
31
직접 실습: 연산 비용으로 구조를 설명합니다
실습 주제: JavaScript 이진 탐색 트리 구현: 중복 키와 세 가지 삭제 처리
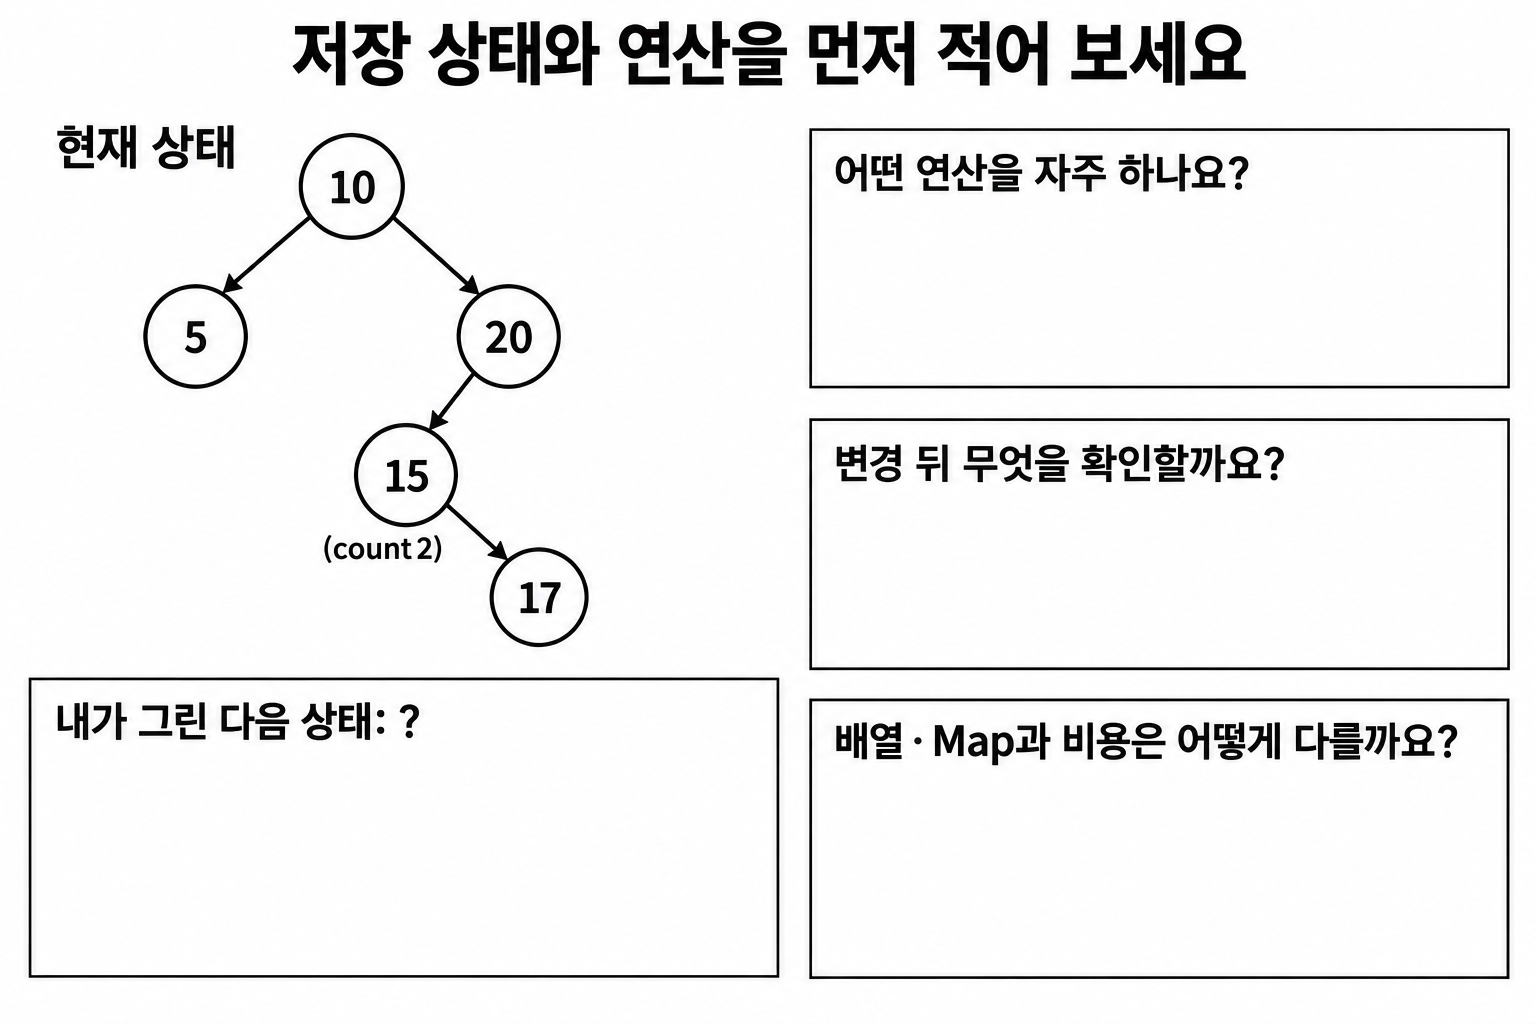
- 본문 구현에서 저장되는 값과 연결 관계를 그림으로 적습니다.
- 조회·삽입·삭제 중 이 구조가 가장 자주 수행할 연산을 고릅니다.
- 연산 전후에도 유지되어야 하는 규칙을 한 문장으로 적습니다.
- 배열이나 Map 같은 다른 구조로 바꿨을 때 시간·공간 비용을 비교합니다.
풀이 기준과 확인 결과
메서드 이름만 외우지 말고 한 번의 연산에서 어떤 값과 연결이 바뀌는지 추적하세요. 빈 구조, 원소 한 개, 중복값, 연속 삽입·삭제를 실행했을 때 본문이 설명한 불변식이 유지되면 성공입니다.
테스트 체크리스트
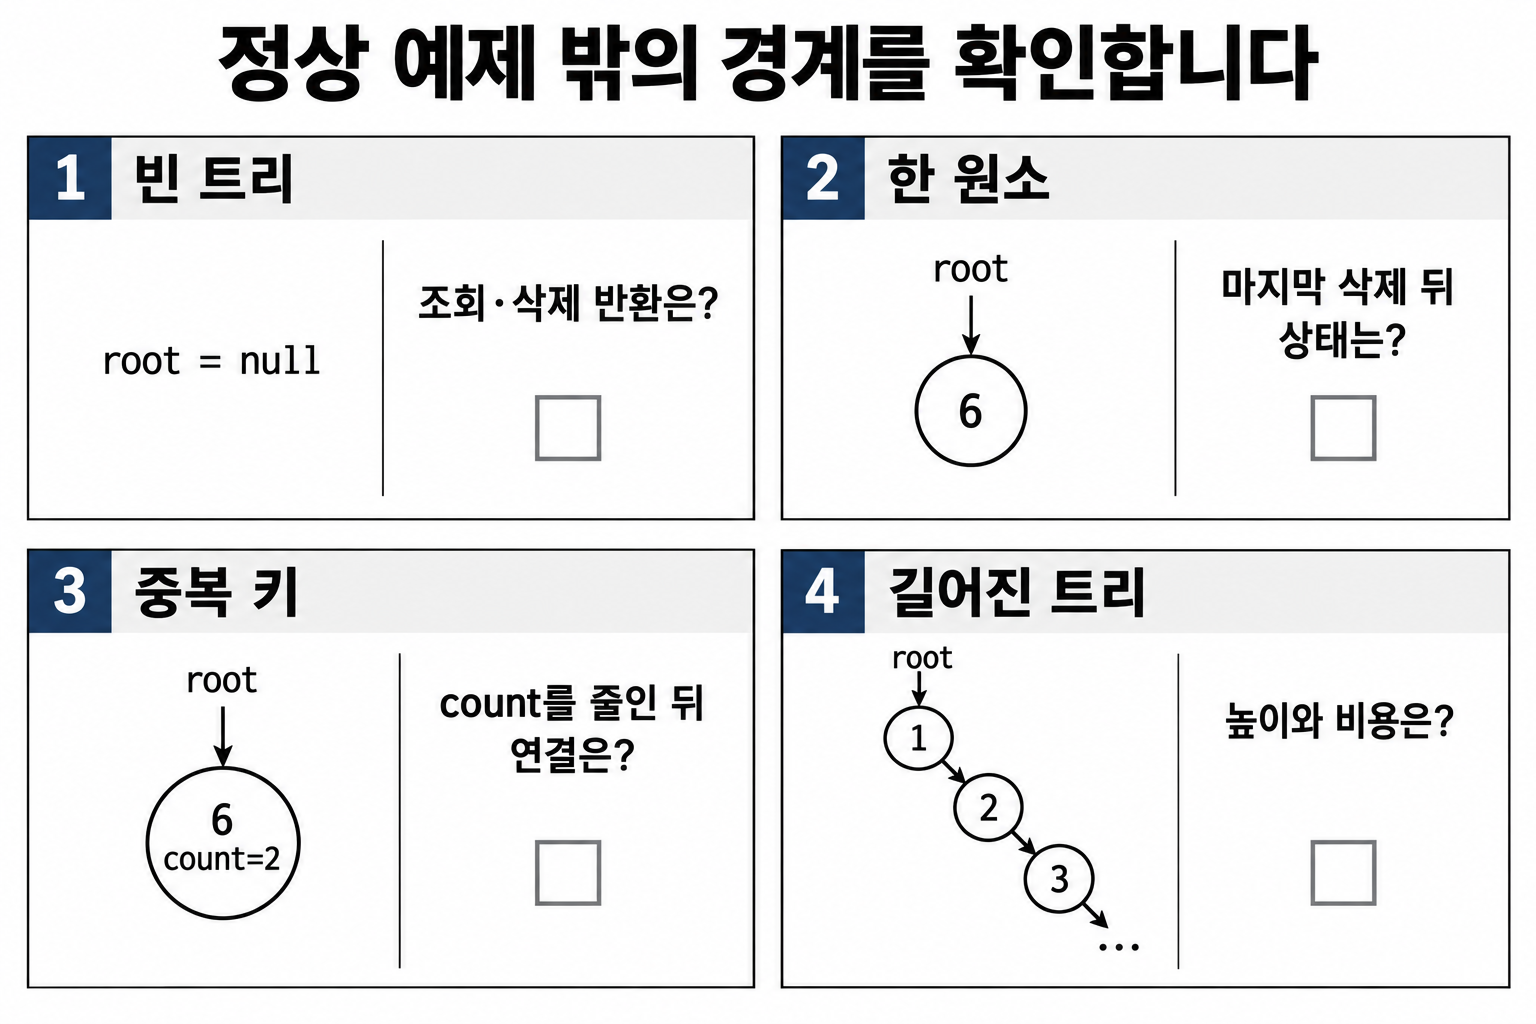
- 빈 구조에 대한 조회·삭제 처리
- 첫 원소와 마지막 원소 변경
- 중복값 또는 동일 우선순위 처리
- 입력 크기가 커졌을 때 예상 복잡도 유지
이 글이 도움이 되었나요?
이어서 공부하기
체크포인트: 예제의 상태 변화를 손으로 추적하고 아래 문제에 적용하세요. 값이 없는 경우와 원소 하나인 경우도 설명해 보세요. 층별 방문 순서와 최솟값 추출을 추적하고, 다익스트라의 비음수 조건과 오래된 후보를 설명하세요.
이 개념으로 더 풀어보기
다음 추천 · 이 개념으로 풀 문제: BST 연습: 닫힌 구간의 중복 키 보고서
권장 순서는 학습 가이드와 같습니다. 다른 순서는 접힌 참고 목록에서 확인할 수 있습니다. 읽음 표시는 숙달이나 채점 결과가 아닙니다.
원래 과정 목록 순서 (선택)
읽음 기록
읽음 — / 전체 23개 · 필수 23개
새 글 받아보기
RSS 리더에서 BlogFlow의 새 글을 확인할 수 있습니다.
