읽기 전에 알아두면 좋아요
아래 개념이 익숙하면 본문을 바로 읽으세요. 낯선 개념만 링크에서 복습하면 됩니다.
- JavaScript Map·Set: 값 조회와 중복 제거 실습Map은 이름표인 키로 값을 찾고, Set은 같은 값을 한 번만 보관합니다.
개념과 예제는 실행하지 않아도 읽을 수 있습니다. 내 컴퓨터·터미널에서 직접 실행하는 과정은 선택 실습입니다.
과정 위치와 선택 복습 안내
과정 위치: 자료구조 개념과 문제 · 자료구조 개념
과정 위치는 이 글이 속한 묶음입니다. 이 단계의 모든 개념을 먼저 읽을 필요는 없습니다. 위에 연결한 개념 중 낯선 내용만 복습하세요. 문제의 조건·상태·갱신 순서는 익숙한 언어로 설명하면 됩니다.
JavaScript로 문법·실행 복습하기 (선택)
개념 글의 코드는 JavaScript 예시입니다. 문제 화면에서는 JavaScript·Python·Java·C++·C# 중 익숙한 언어의 함수를 작성하세요. 본문의 Node.js 입출력 예시는 로컬 실행을 위한 별도 안내입니다.
문자열 해시 테이블에서 충돌과 리사이즈는 어떻게 처리하나요?
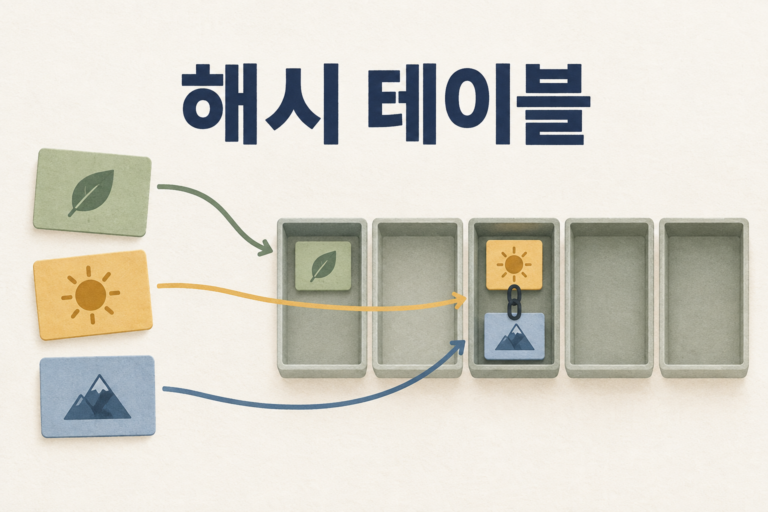
해시 테이블은 키를 계산한 위치에 값을 저장합니다. 서로 다른 키가 같은 칸에 들어오면 원래 키까지 비교하고, 칸이 부족해지면 새 크기에 맞춰 다시 배치합니다.
적용 조건·범위: 실무에서는 보통 내장 Map을 먼저 사용합니다. 이 구현의 목적은 충돌 처리와 비용 조건을 이해하는 것이며 해시 서비스의 보안성이나 Map보다 빠른 성능을 보장하지 않습니다. 외부 입력에 노출되는 서버라면 입력량 제한과 검증을 별도로 설계해야 합니다.
본문 근거: Princeton Algorithms — Hash Tables · MDN — String.prototype.normalize()
해시 테이블: 이름표를 칸으로 바꾸고 같은 칸에서 다시 찾습니다
네 칸의 사물함 예제로 해시 충돌과 원래 키 비교를 배웁니다. 작은 코드부터 재배치와 문자열 정규화까지 단계적으로 연결합니다.
먼저 작은 예제로 원리를 익히고, 마지막에 전체 구현을 펼쳐 보세요. 앞쪽 예제는 각각 독립적으로 브라우저 개발자 도구 Console에서 실행합니다. 같은 이름을 다시 선언했다는 오류가 나오면 새로고침 후 해당 예제를 실행하세요. 출력 뒤에 콘솔이 별도로 보여주는 undefined는 마지막 명령의 반환값일 수 있습니다.
선수 지식: JavaScript 변수·배열·조건문을 먼저 익힙니다. 객체 참조나 함수가 낯설면 아래 단계별 예제부터 시작하고, class 전체 구현은 해당 동작을 손으로 추적한 뒤 읽습니다. 각각의 코드는 독립 실행합니다.
사물함 이름표를 숫자 칸으로 바꿔 봅니다
학생 이름으로 사물함을 찾는다고 해보겠습니다. 사물함이 네 칸뿐이라면 이름을 숫자로 바꾸어 0번부터 3번 중 한 칸을 고를 수 있습니다. 이 숫자를 만드는 규칙이 해시 함수입니다.
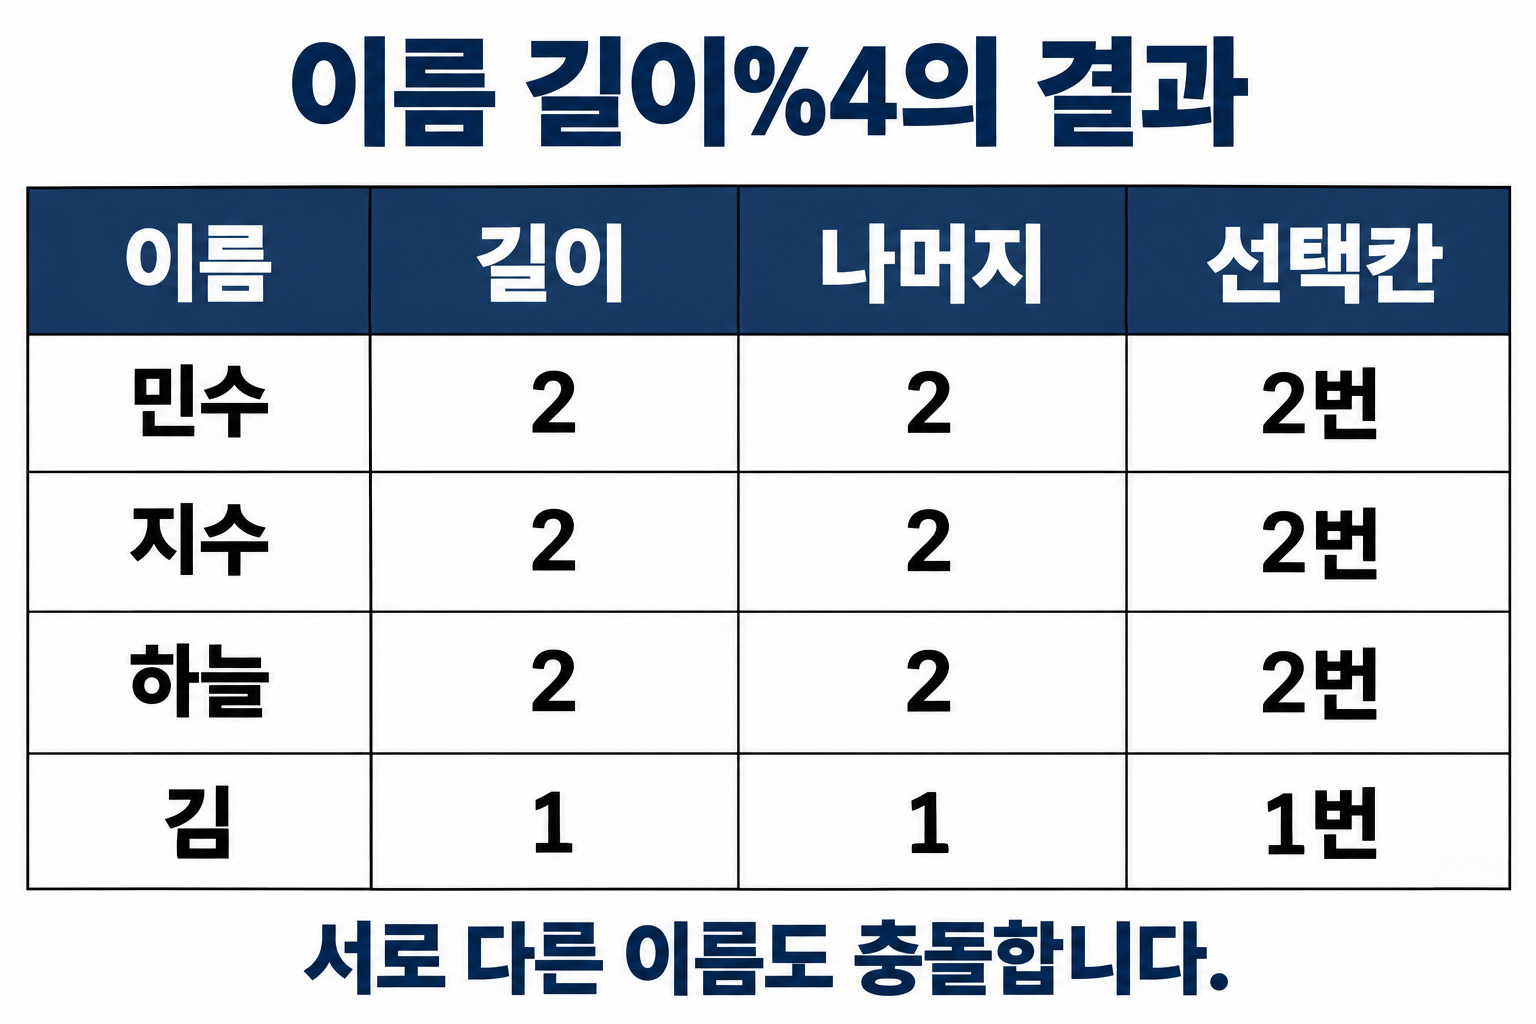
처음에는 글자의 복잡한 숫자값 대신 이름 길이를 사용하겠습니다. 이름 길이 % 4로 칸을 정합니다.
| 이름 | 길이 | 4로 나눈 나머지 | 선택한 칸 |
|---|---|---|---|
| 민수 | 2 | 2 | 2번 |
| 지수 | 2 | 2 | 2번 |
| 하늘 | 2 | 2 | 2번 |
| 김 | 1 | 1 | 1번 |
민수와 지수는 다른 이름인데도 같은 2번 칸을 골랐습니다. 이것이 충돌입니다. 충돌은 해시 함수가 고장 났다는 뜻이 아닙니다. 가능한 이름은 아주 많고 칸은 네 개뿐이므로 언젠가는 같은 칸을 고르게 됩니다.
작은 해시 함수의 결과를 직접 봅니다
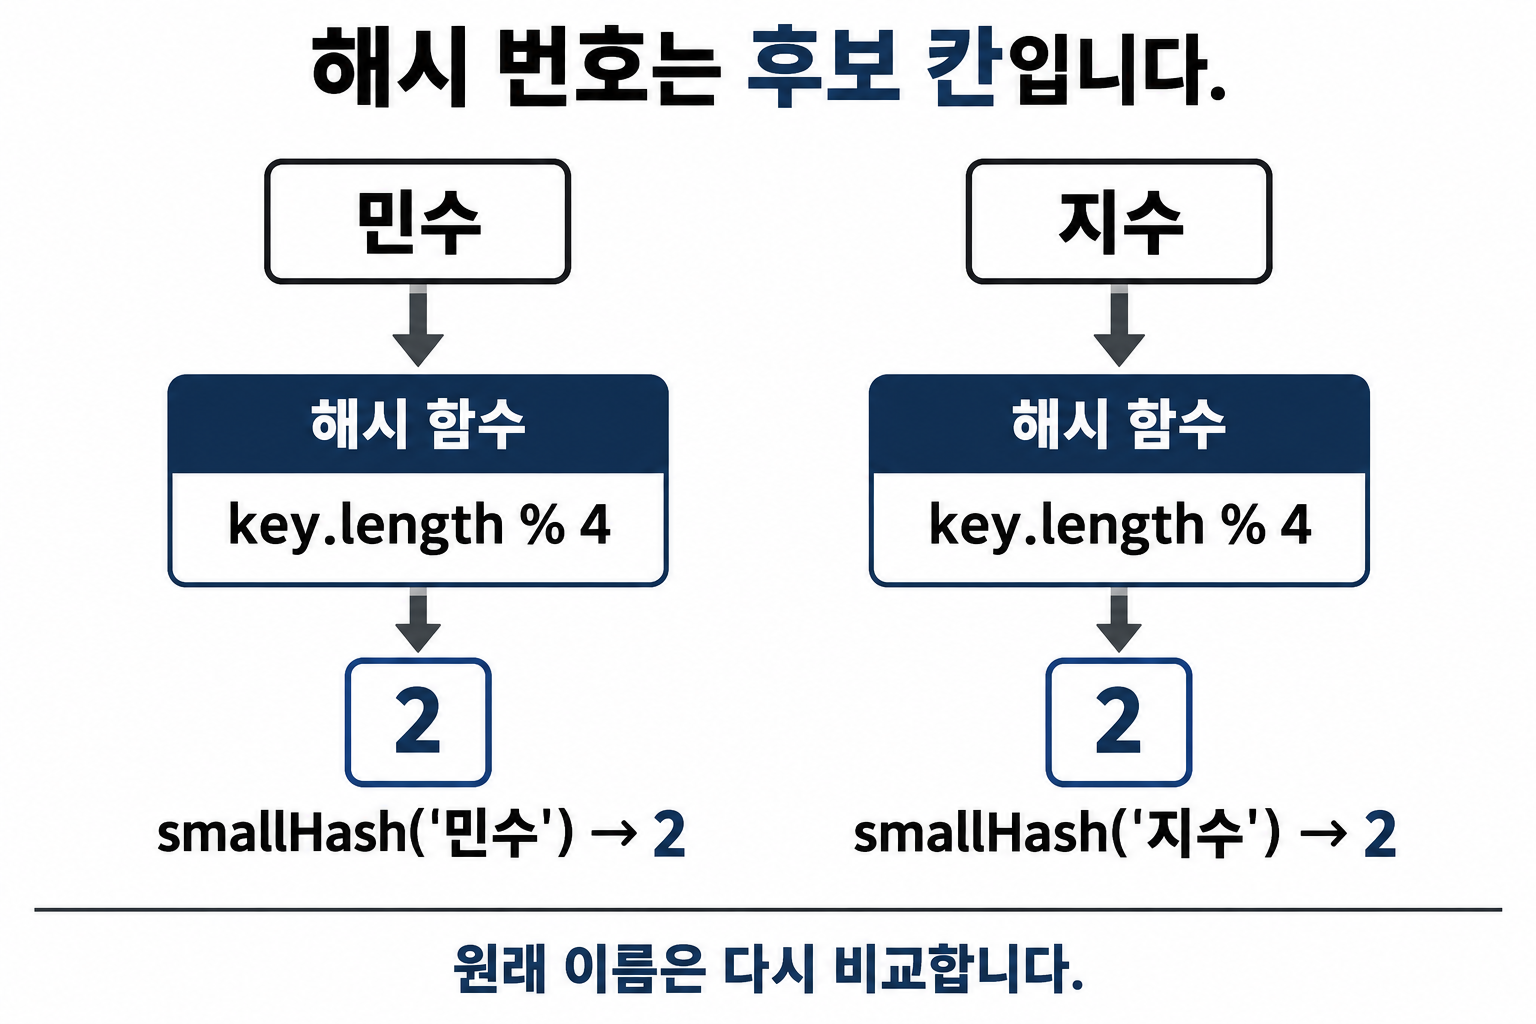
function smallHash(key) {
  return key.length % 4;
}

console.log(smallHash('민수'));
console.log(smallHash('지수'));
2 2
함수는 문자열 길이를 네 칸 안의 번호로 줄입니다. 두 이름이 모두 2를 내므로 해시 번호만 보고 “같은 이름”이라고 결론 내리면 안 됩니다. 해시는 찾을 후보 칸을 알려줄 뿐이고, 마지막에는 원래 이름을 다시 비교해야 합니다.
충돌한 이름은 같은 칸의 목록에 둡니다
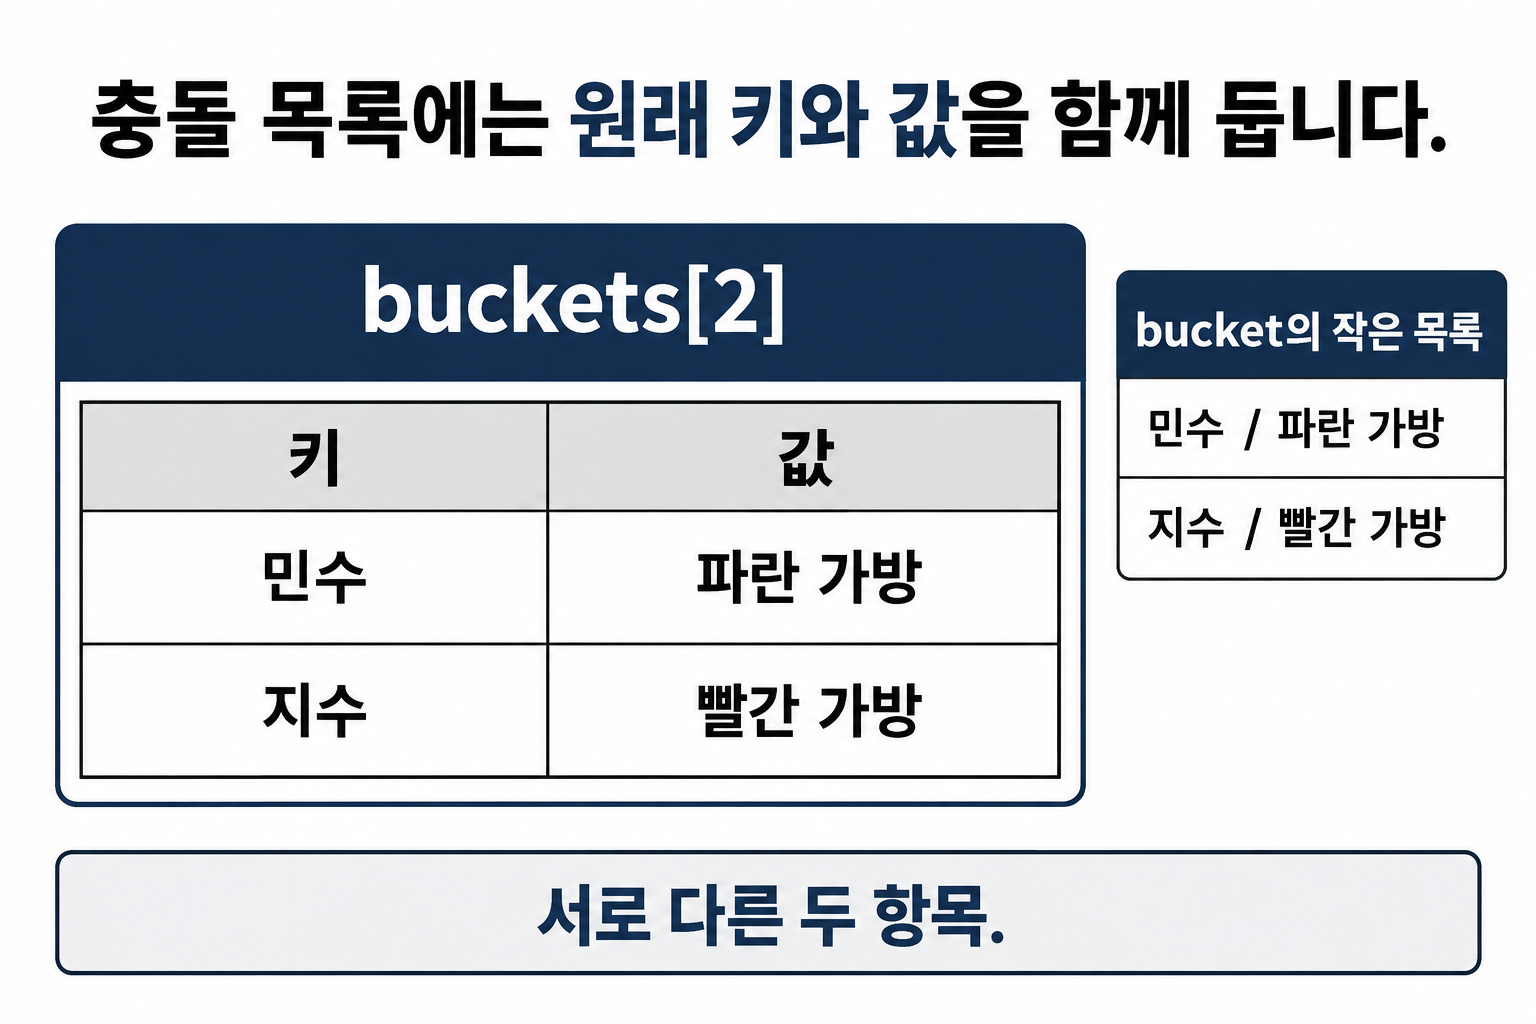
const buckets = [[], [], [], []];
buckets[2].push(['민수', '파란 가방']);
buckets[2].push(['지수', '빨간 가방']);

console.log(buckets[2].map(pair => pair[0]).join(', '));
민수, 지수
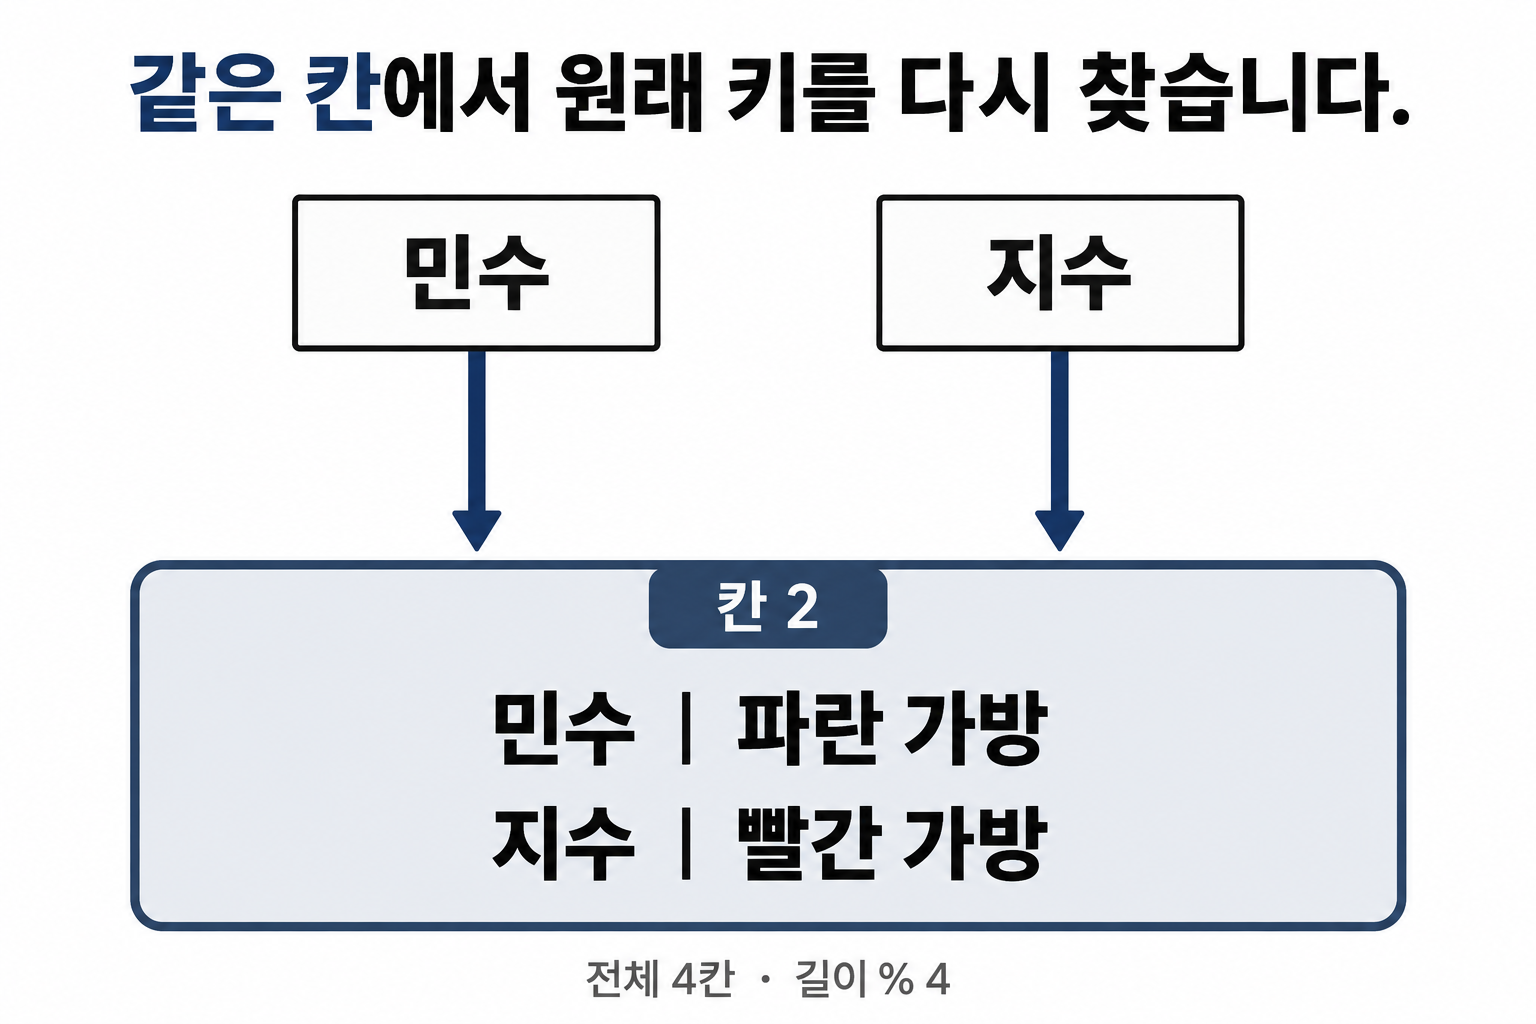
2번 칸 자체를 작은 목록으로 만들었습니다. 각 항목에는 원래 이름과 값이 함께 있습니다. 찾을 때는 2번 칸까지만 바로 간 뒤, 그 안에서 원래 이름이 같은 항목을 확인합니다. 이름을 저장하지 않고 가방만 넣으면 어느 가방이 민수 것인지 구분할 수 없습니다.
조회는 칸 선택과 원래 키 비교 두 단계입니다
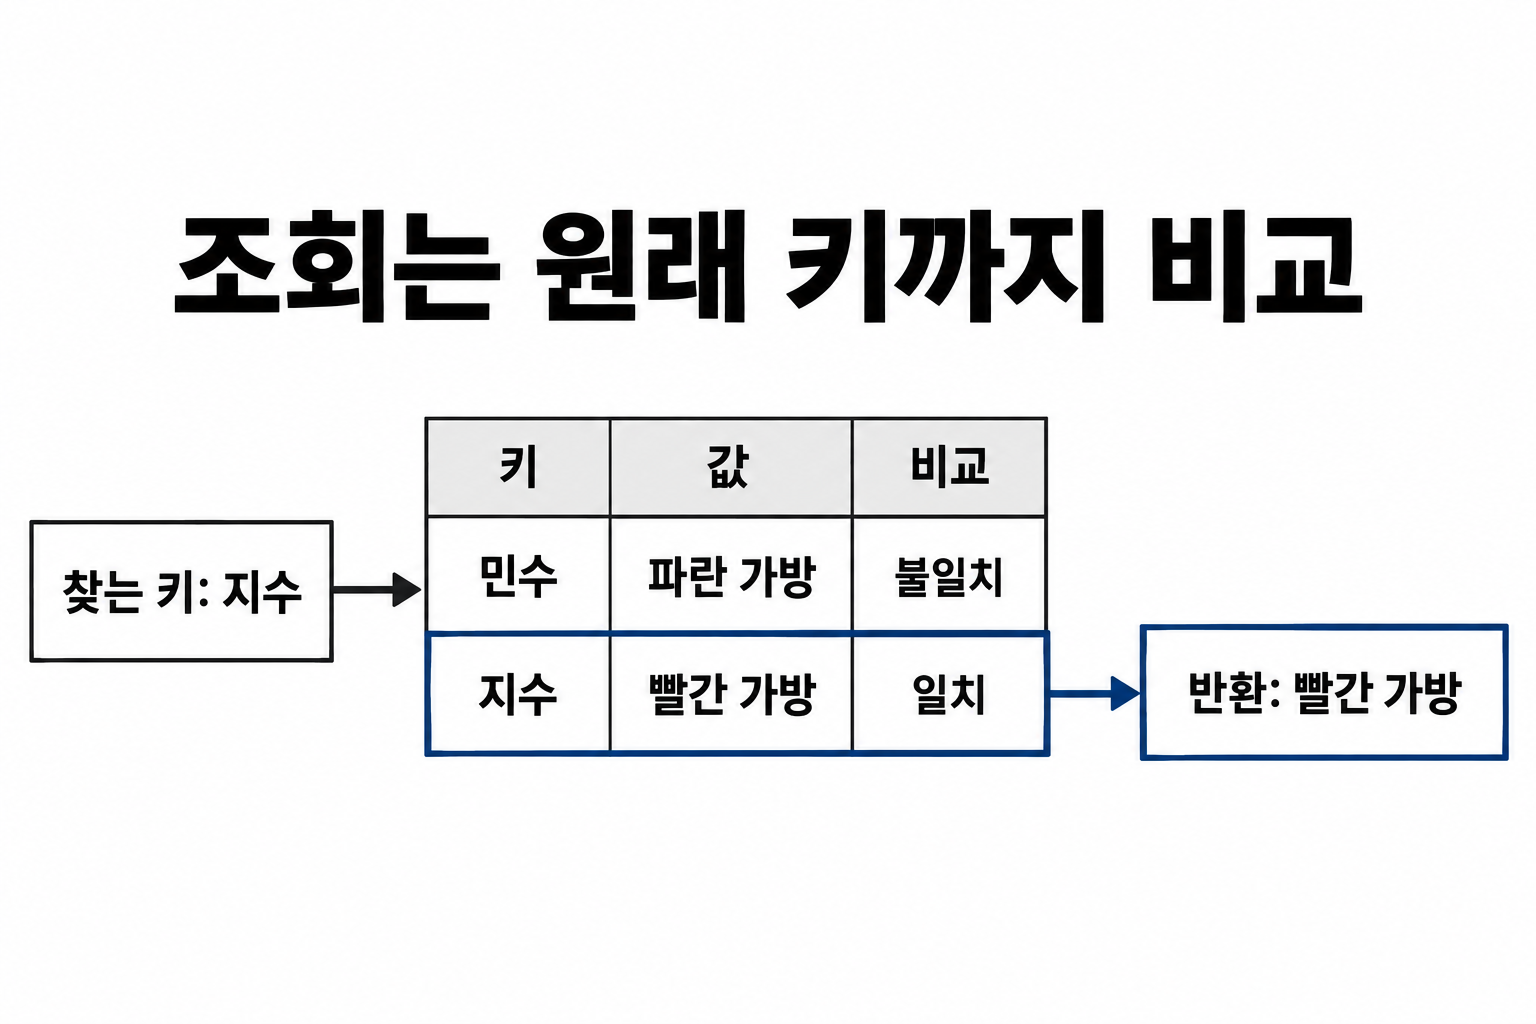
const bucket = [['민수', '파란 가방'], ['지수', '빨간 가방']];
const entry = bucket.find(pair => pair[0] === '지수');

console.log(entry[1]);
빨간 가방
find는 같은 칸 안에서 이름을 하나씩 비교합니다. 여기서는 민수가 아니므로 다음 항목으로 가고, 지수를 만나 빨간 가방을 읽습니다. 해시 번호가 같다는 이유만으로 첫 항목을 반환했다면 지수에게 민수의 가방을 주는 오류가 생깁니다.
확인 문제: 민수와 지수의 해시 번호가 같으면 같은 키일까요?
아닙니다. 같은 칸의 후보라는 뜻일 뿐입니다. 문자열 '민수' === '지수'는 거짓이므로 서로 다른 항목으로 보관해야 합니다.
칸이 붐비면 더 큰 표로 다시 배치합니다
네 칸에 이름이 계속 늘면 한 칸의 목록이 길어져 다시 많은 이름을 비교하게 됩니다. 그래서 전체 칸 수를 늘리고 각 이름의 새 칸을 다시 계산합니다.
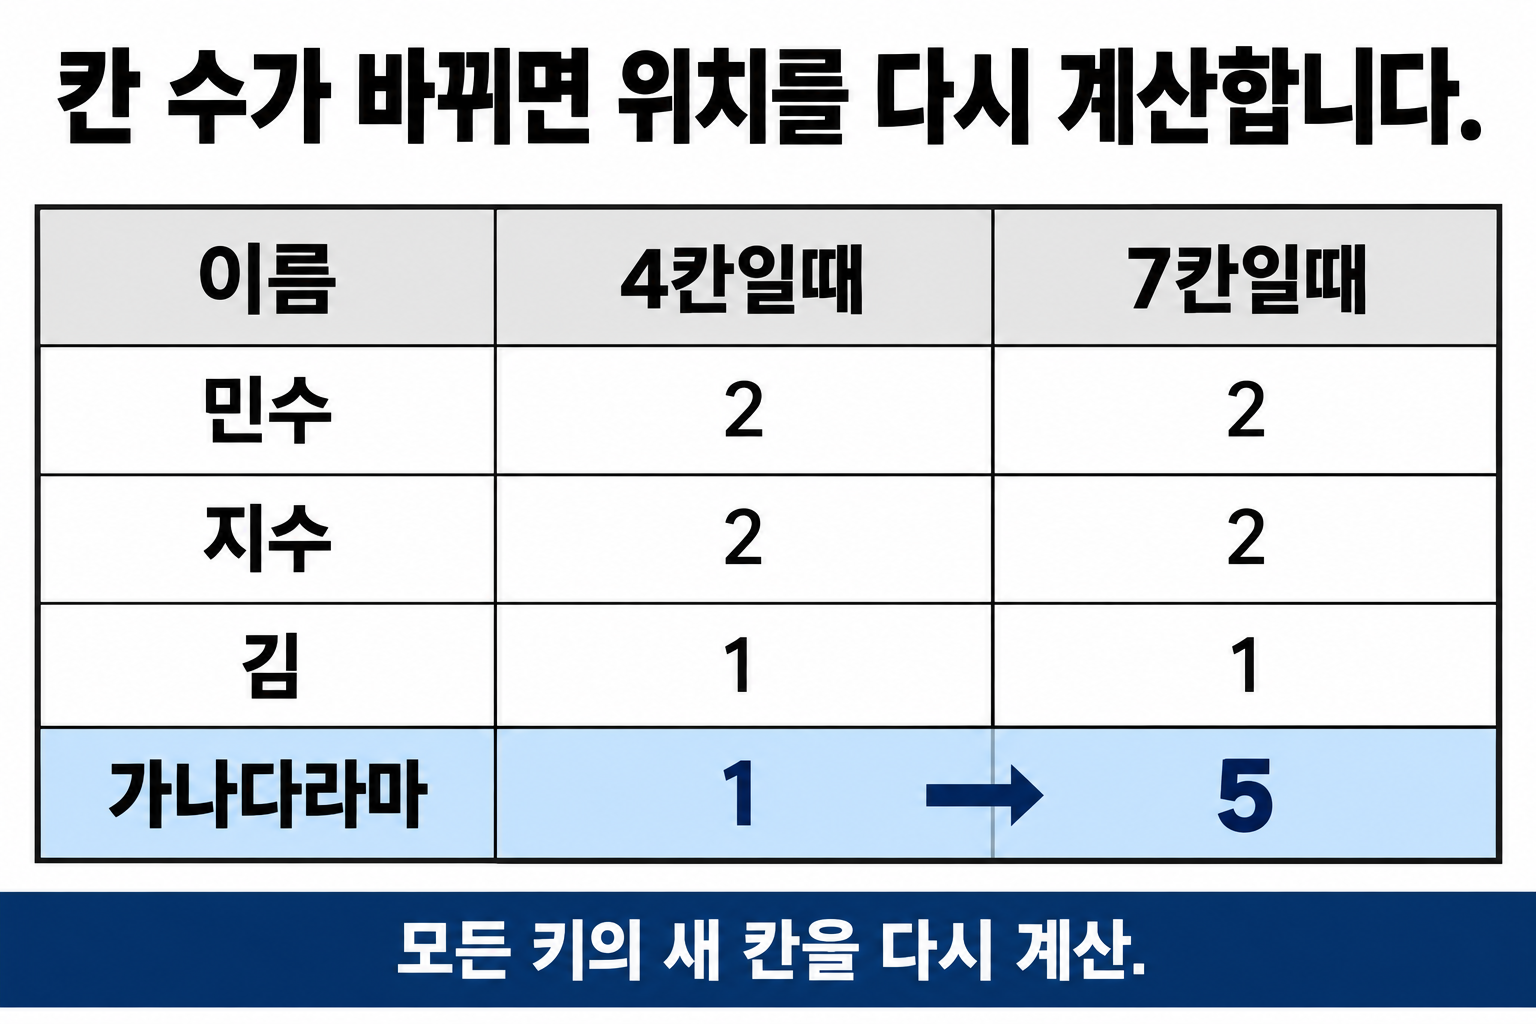
| 이름 | 4칸일 때 | 7칸일 때 |
|---|---|---|
| 민수 | 2번 | 2번 |
| 지수 | 2번 | 2번 |
| 김 | 1번 | 1번 |
| 가나다라마 | 1번 | 5번 |
길이만 쓰는 장난감 함수는 칸을 늘려도 두 글자 이름이 계속 충돌합니다. 실제 전체 구현이 문자열의 각 글자를 섞어 해시를 만드는 이유입니다. 또한 칸 수가 달라지면 나머지 결과도 달라질 수 있으므로 기존 배열을 그대로 복사하지 않고 모든 키의 위치를 다시 계산해야 합니다.
더 알아보기: 같은 글자로 보이는 문자열 정리
화면에서 같은 글자로 보여도 컴퓨터 안의 조합 방식이 다른 문자열이 있습니다. NFC 정규화는 이런 표현을 한 형태로 맞춘 뒤 저장하고 찾게 합니다. 아래 전체 구현은 모든 공개 동작에서 이 정리를 적용합니다. 참고로 위의 length는 JavaScript의 UTF-16 코드 단위 개수이며, 표는 차이를 피하려고 완성된 한국어 음절만 사용했습니다.
선택 실습: 같은 글자로 보이는 문자열 비교하기
const first = 'é';
const second = 'e\u0301';

console.log(first === second);
console.log(first.normalize('NFC') === second.normalize('NFC'));
false true
화면에서는 둘 다 é처럼 보이지만 컴퓨터 안의 글자 조합이 다를 수 있습니다. 저장할 때만 정리하고 찾을 때는 정리하지 않으면 같은 이름을 못 찾습니다. 그래서 이어지는 구현은 저장·조회·삭제에서 같은 정규화 과정을 거칩니다.
바로 실행해 보는 핵심 예제
독자 질문: 다른 문자열이 같은 해시 칸에 들어가면 값을 어떻게 구분하나요?
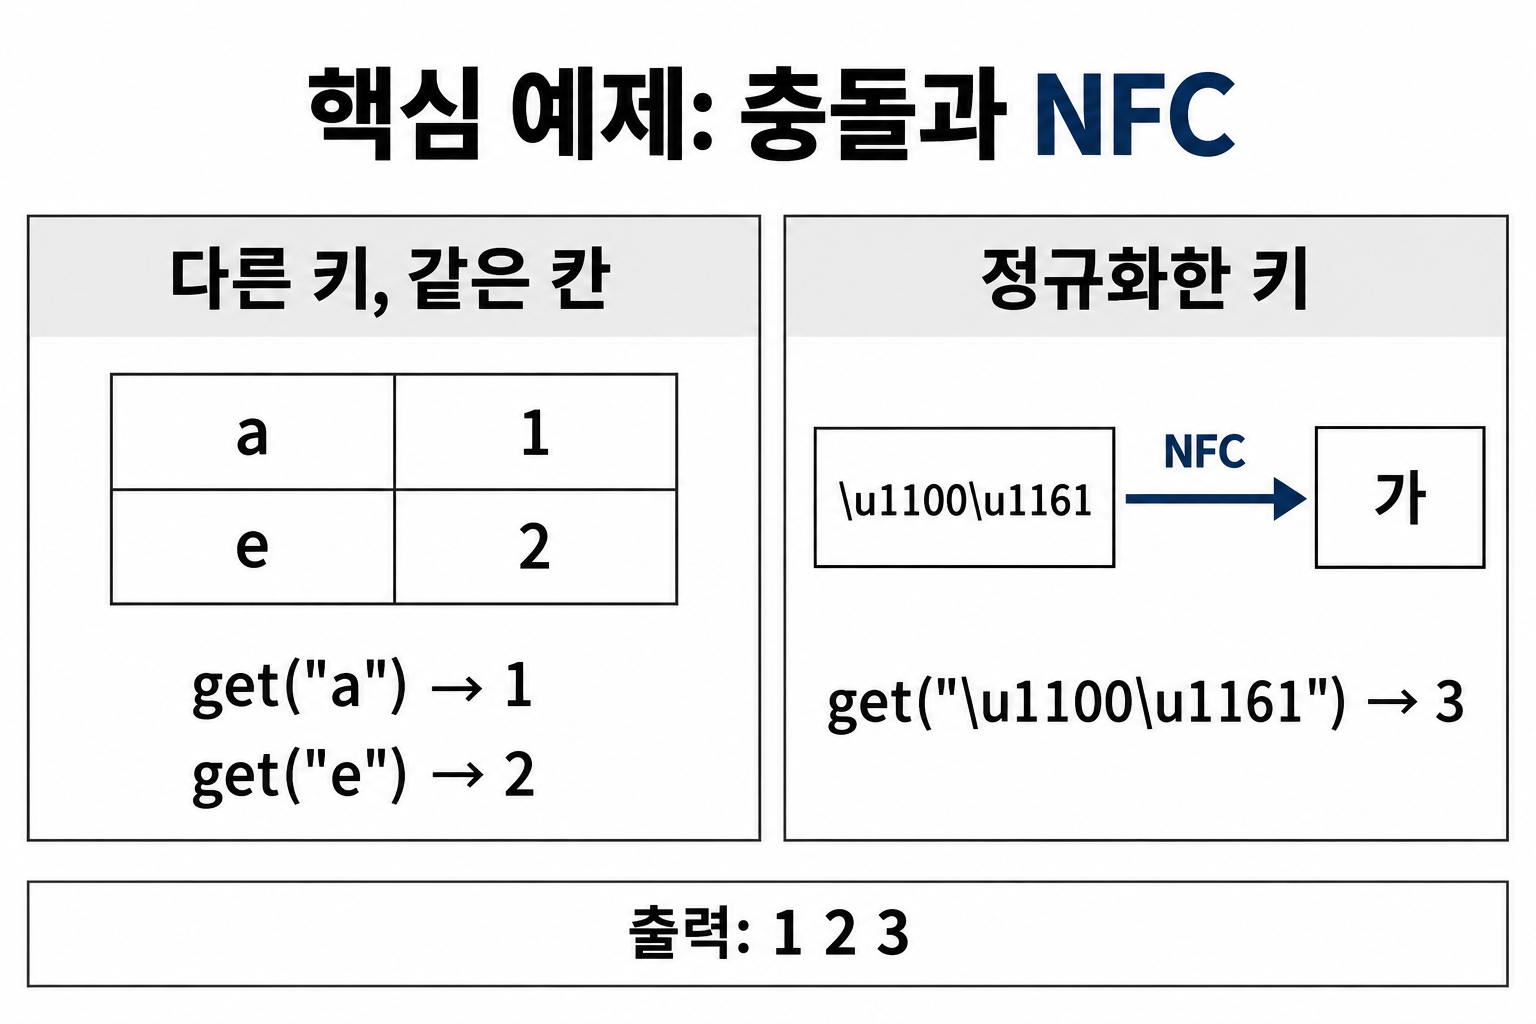
왜 쓰나요? 각 칸에 [원래 키, 값] 목록을 두고 키를 다시 비교합니다. 정규화는 저장·조회 모두 적용합니다.
아래 바닐라 JavaScript 코드는 독립 실행 예제입니다. 본문에서 배운 개념을 새 데이터로 확인합니다. 다른 예제와 같은 콘솔에 이어 붙이지 말고 새 콘솔 또는 새 .cjs 파일에서 실행하세요.
const buckets = Array.from({ length: 4 }, () => []);
const normalize = (key) => key.normalize("NFC");
const indexOf = (key) => [...key].reduce((n, ch) => n + ch.codePointAt(0), 0) % 4;
function set(key, value) {
  key = normalize(key);
  const bucket = buckets[indexOf(key)];
  const found = bucket.find((pair) => pair[0] === key);
  if (found) found[1] = value;
  else bucket.push([key, value]);
}
function get(key) {
  key = normalize(key);
  return buckets[indexOf(key)].find((pair) => pair[0] === key)?.[1];
}
set("a", 1); set("e", 2); set("가", 3);
console.log(get("a"), get("e"), get("가"));
실행 결과와 비용
이번 검토에서는 Node.js v24.18.0에서 위 독립 예제를 실행해 다음 출력과 일치하는지 확인했습니다.
1 2 3시간·공간 복잡도: 이 작은 예제는 충돌 시 해당 bucket 길이만큼 선형 탐색합니다. 실제 리사이즈·적절한 해시를 갖춘 테이블의 평균 조회는 O(1), 모든 키가 충돌하면 O(n)입니다.
직접 풀 문제
set('a', 4) 후 get('a')와 get('e')는?
풀이와 기대 결과
4와 2입니다. 같은 칸 충돌을 덮어쓰기와 혼동하지 않습니다.
원자료의 다른 학습 순서 (선택)
자료구조 과정 원래 순서의 다음 글: 09 트리·BST·MST의 서로 다른 질문
검증 범위: 위 독립 예제의 출력만 로컬에서 확인했습니다. 이 글은 독립 자료구조 실습입니다. 실제 브라우저 표시와 모든 입력·플랫폼의 실행은 검증하지 않았습니다.
이제 기존 전체 구현을 읽는 순서
먼저 “키를 칸 번호로 바꾸는 함수”를 찾고, 다음으로 한 칸 안에서 원래 키를 비교하는 부분을 찾으세요. 그 뒤 같은 키를 다시 저장할 때 값을 바꾸는 흐름, 항목이 많아질 때 더 큰 표로 옮기는 흐름, 마지막으로 모든 공개 동작에서 NFC 정규화를 적용하는지 확인하면 됩니다.
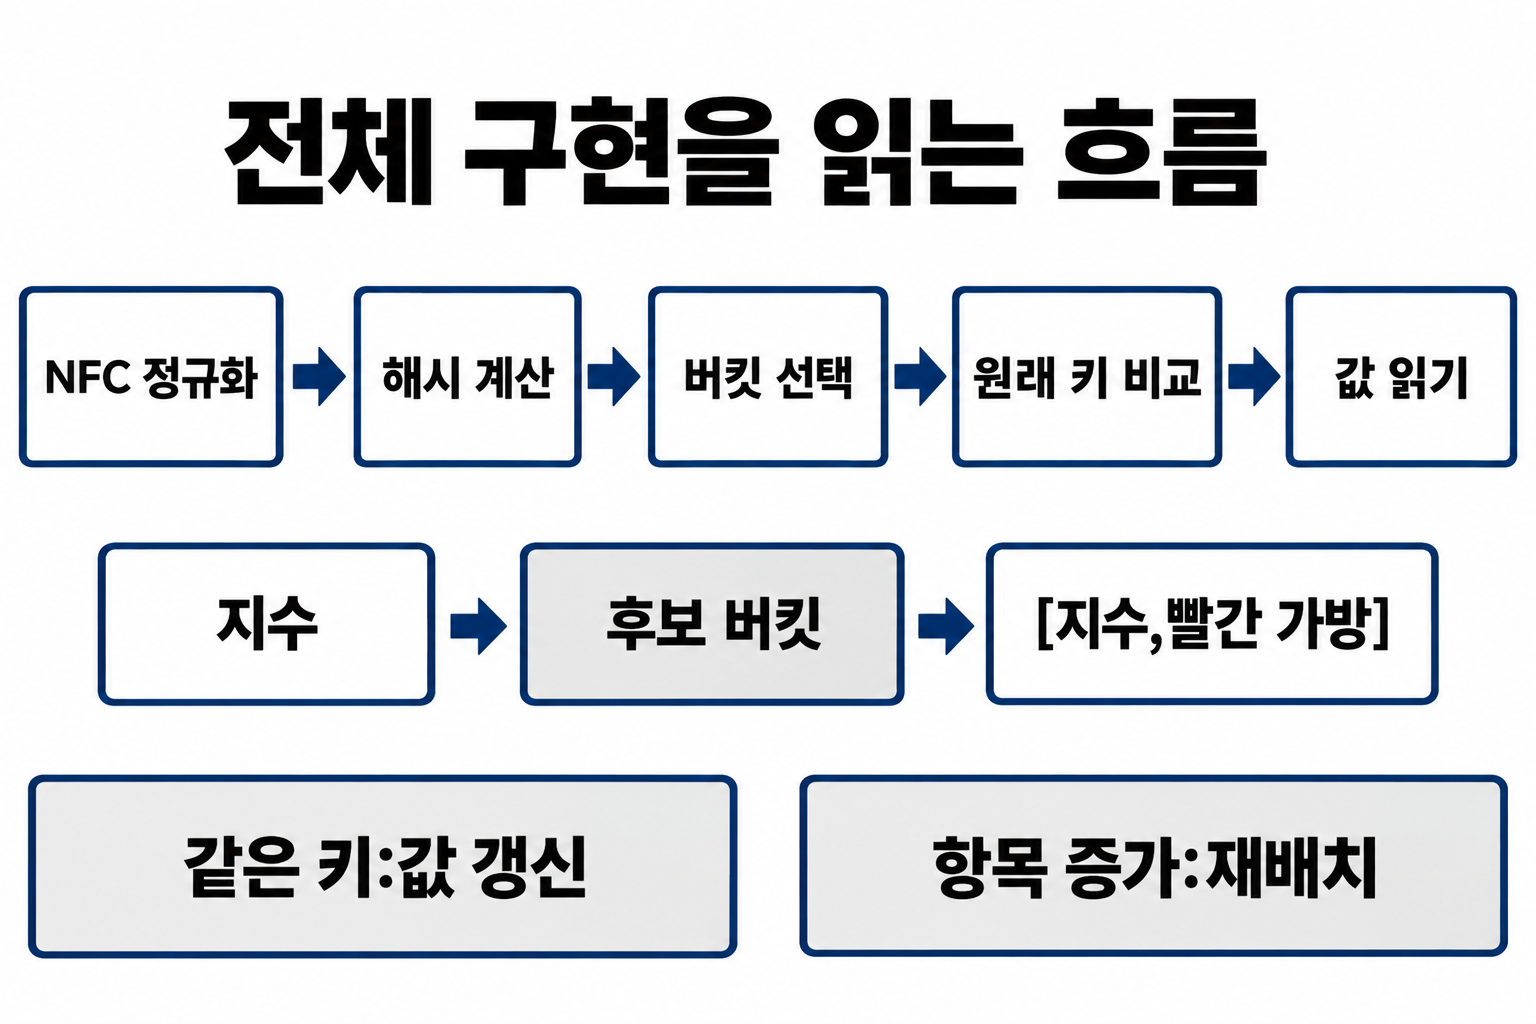
위 길이 기반 함수는 충돌 원리를 눈으로 보기 위한 축소 예제라 실제 저장소에 적합하지 않습니다. 아래 정밀 구현은 더 나은 문자열 해시, 충돌 목록, 크기 조절과 문자열 정책을 함께 다룹니다.
관련 코딩테스트 문제로 이어서 연습합니다
이 자료구조의 블로그 연습 문제와 해설에서 배운 동작을 적용해 보세요. 먼저 작은 예시를 직접 처리한 뒤 입력 전체를 다루는 코드로 확장하면 됩니다. 아래 전체 구현은 연결된 문제의 기존 메서드와 반환 형식을 유지합니다.
전체 구현 · 상세 설명 · 예외와 성능 분석 펼치기
여기부터는 필요한 기능을 골라 읽는 참고 영역입니다. 새로운 파일로 전체 코드를 실행할 때는 아래 Node.js 실행 안내를 따르세요. 앞쪽의 작은 브라우저 실습과 전체 파일을 한 콘솔에 이어 붙이지 마세요. 기능별 입력 조건과 반환 형식은 아래 설명을 기준으로 합니다.
키를 빨리 찾으려면 무엇을 생략할 수 있는가
문자열 배열에서 키 하나를 찾으면 최악에는 모든 키를 비교합니다. 해시 테이블은 키로부터 버킷 번호를 계산해 조사 범위를 줄입니다. 다만 가능한 문자열 수는 버킷 수보다 훨씬 많으므로 서로 다른 키가 같은 버킷으로 가는 충돌은 정상적인 현상입니다.
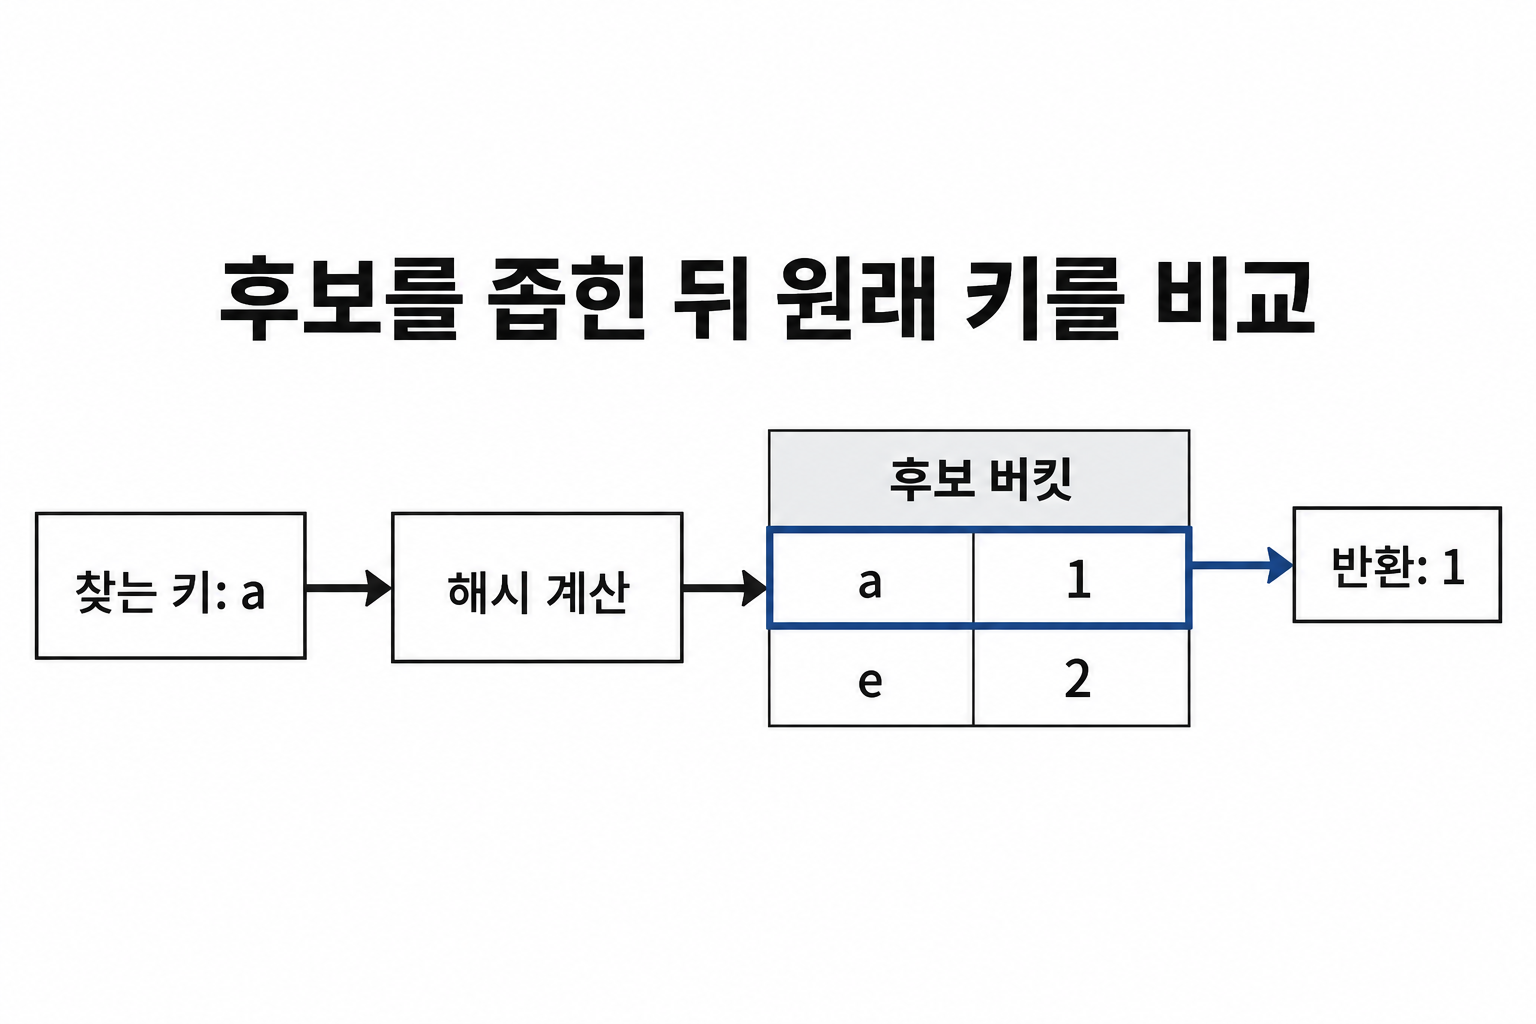
이 구현은 각 버킷에 작은 배열을 두는 분리 체이닝을 사용합니다. 해시는 후보 버킷을 선택하고, 그 안에서 실제 문자열 동등성 비교로 키를 확정합니다. 해시 값이 같다는 이유만으로 키까지 같다고 처리하면 서로 다른 데이터가 덮어써집니다.
문자열 계약과 유니코드 정책
키는 문자열만 허용합니다. 숫자 1이나 객체를 자동 문자열화하지 않아 의도하지 않은 키 합침을 피합니다. 키는 모든 공개 조회·저장·삭제에서 NFC로 정규화하므로 조합형 e + 결합 악센트와 완성형 é는 같은 키입니다. 대소문자, 공백, 호환 문자는 별도로 합치지 않습니다.
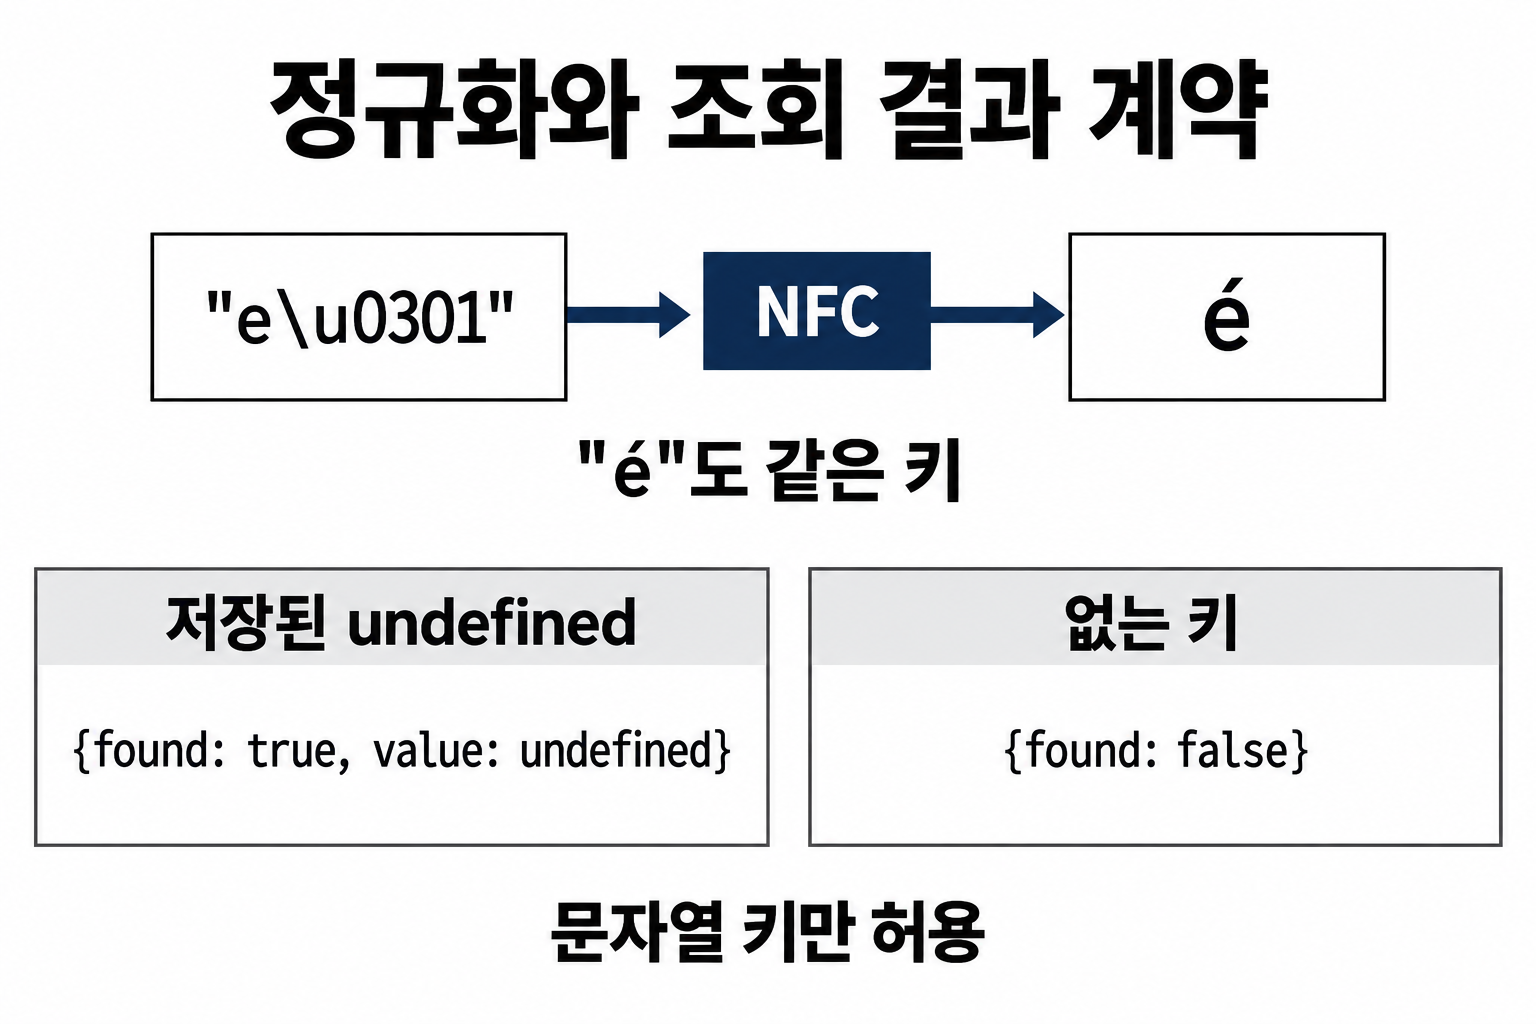
빈 문자열과 이모지도 유효한 키입니다. for…of는 UTF-16 코드 단위를 낱개로 쪼개지 않고 코드 포인트 단위로 진행합니다. 단, 코드 포인트는 사용자가 보는 글자 묶음인 자소와 같지 않습니다. NFC 역시 철자가 비슷한 모든 문자열을 하나로 바꾸는 검색용 유사도 처리가 아닙니다.
값에는 undefined도 허용하기 때문에 get은 {found:true,value} 또는 {found:false}를 반환합니다. 같은 정규화 키를 set하면 값만 교체하고 size는 늘리지 않습니다. entries의 순서는 버킷 배치에 따라 달라지며 삽입 순서를 보장하지 않습니다. 내부 buckets나 resize는 학습을 위한 공개 상태이므로 호출자가 직접 바꾸지 않는 계약입니다.
전체 코드와 실행
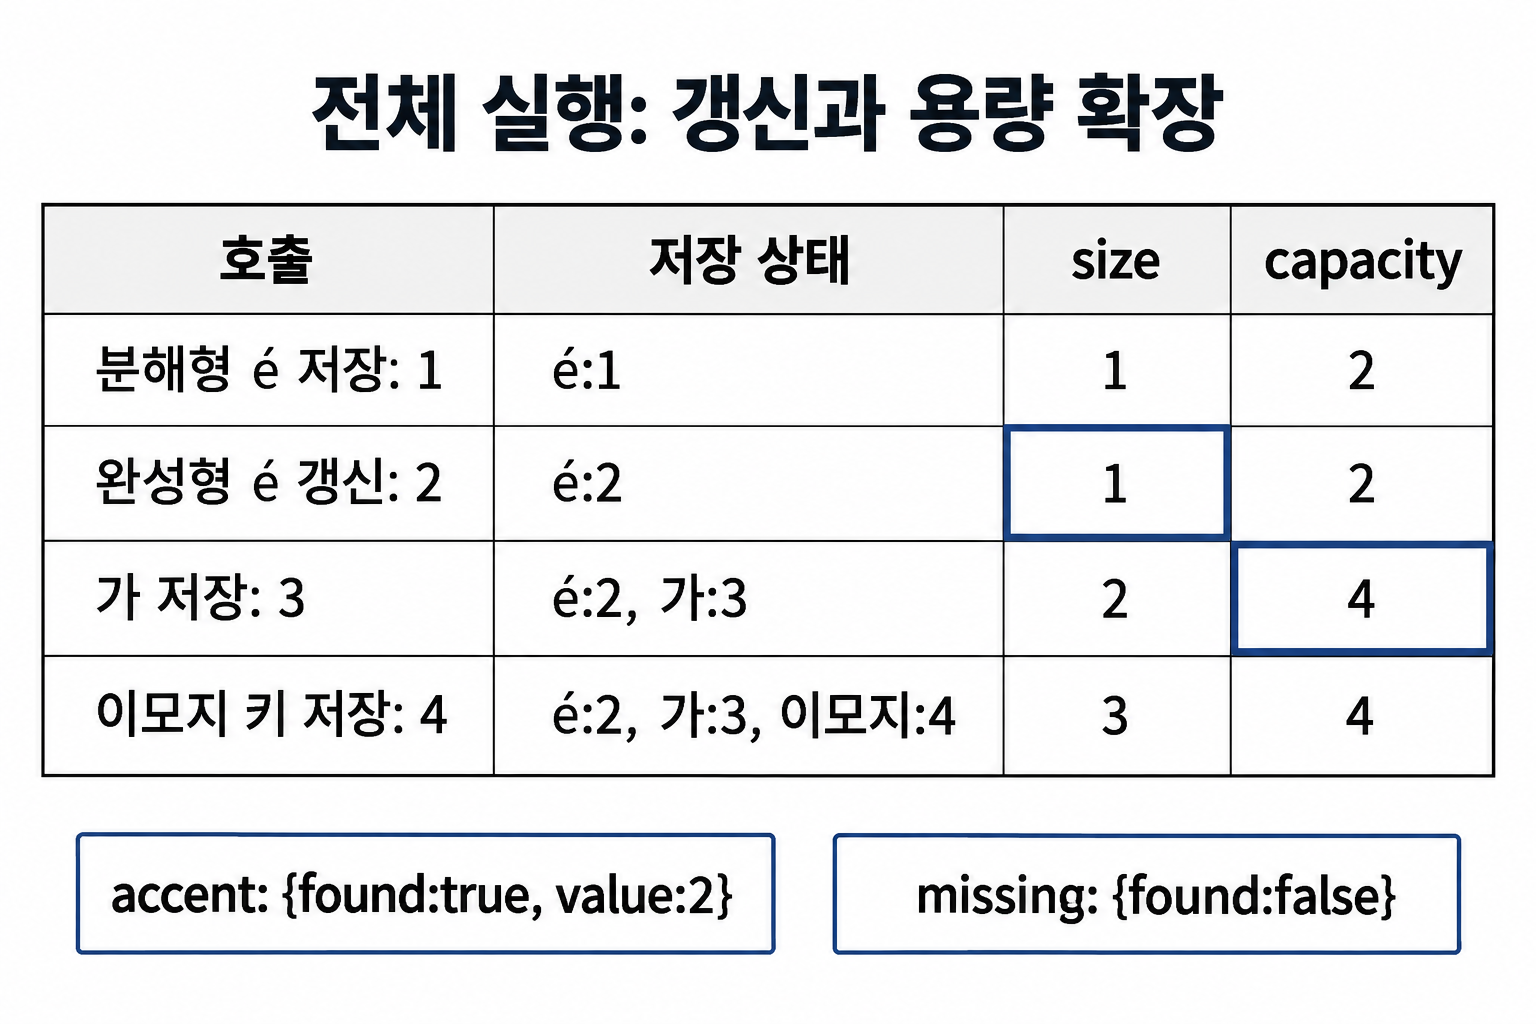
아래를 hash-table.cjs로 저장해 node ./hash-table.cjs로 실행합니다. Node.js CommonJS 전체 파일입니다. 예제는 NFC로 합쳐지는 키를 갱신하고 초기 버킷 2개를 4개로 늘린 후 조회 결과를 출력합니다.
'use strict';

class StringHashTable {
  constructor(capacity = 4) {
    if (!Number.isInteger(capacity) || capacity < 1) {
      throw new RangeError('capacity must be a positive integer');
    }
    this.buckets = Array.from({ length: capacity }, () => []);
    this.size = 0;
  }

  normalize(key) {
    if (typeof key !== 'string') throw new TypeError('key must be a string');
    return key.normalize('NFC');
  }

  index(key, capacity = this.buckets.length) {
    let hash = 2166136261;
    for (const character of key) {
      hash = Math.imul(hash ^ character.codePointAt(0), 16777619) >>> 0;
    }
    return hash % capacity;
  }

  resize(capacity) {
    const next = Array.from({ length: capacity }, () => []);
    for (const bucket of this.buckets) {
      for (const entry of bucket) {
        next[this.index(entry.key, capacity)].push(entry);
      }
    }
    this.buckets = next;
  }

  set(rawKey, value) {
    const key = this.normalize(rawKey);
    let bucket = this.buckets[this.index(key)];
    for (const entry of bucket) {
      if (entry.key === key) {
        entry.value = value;
        return this;
      }
    }
    if ((this.size + 1) / this.buckets.length > 0.75) {
      this.resize(this.buckets.length * 2);
      bucket = this.buckets[this.index(key)];
    }
    bucket.push({ key, value });
    this.size += 1;
    return this;
  }

  get(rawKey) {
    const key = this.normalize(rawKey);
    for (const entry of this.buckets[this.index(key)]) {
      if (entry.key === key) return { found: true, value: entry.value };
    }
    return { found: false };
  }

  delete(rawKey) {
    const key = this.normalize(rawKey);
    const bucket = this.buckets[this.index(key)];
    const index = bucket.findIndex(entry => entry.key === key);
    if (index === -1) return false;
    bucket.splice(index, 1);
    this.size -= 1;
    return true;
  }

  entries() {
    const result = [];
    for (const bucket of this.buckets) {
      for (const entry of bucket) result.push([entry.key, entry.value]);
    }
    return result;
  }
}

module.exports = { StringHashTable };

if (require.main === module) {
  const table = new StringHashTable(2);
  table.set('e\u0301', 1);
  table.set('é', 2);
  table.set('가', 3);
  table.set('🙂', 4);
  console.log(JSON.stringify({
    size: table.size,
    capacity: table.buckets.length,
    accent: table.get('e\u0301'),
    missing: table.get('없음')
  }));
}
실행 출력
{"size":3,"capacity":4,"accent":{"found":true,"value":2},"missing":{"found":false}}해시 계산과 충돌 탐색
index는 코드 포인트를 누적하면서 Math.imul로 32비트 정수 곱셈을 수행하고 >>> 0으로 부호 없는 값으로 해석합니다. 마지막 나머지 연산이 버킷 범위를 만듭니다. FNV 계열의 혼합 상수를 활용한 교육용 함수이며 표준 바이트 기반 FNV 구현이나 암호학적 해시라고 주장하지 않습니다.
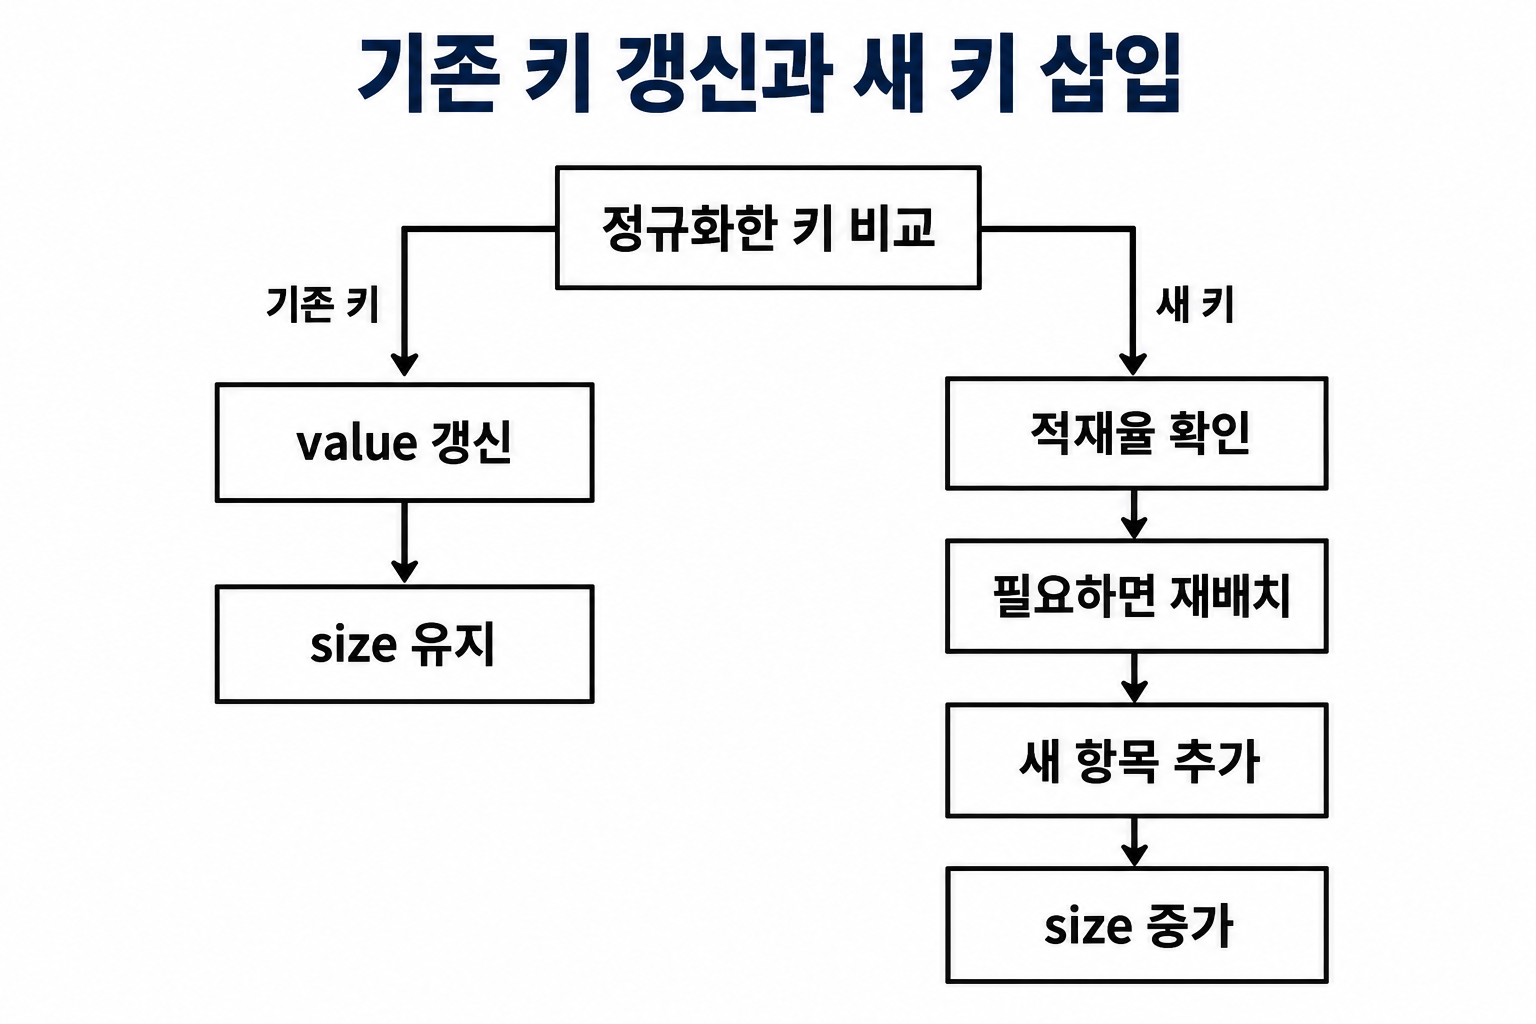
set은 먼저 같은 키를 찾습니다. 기존 키의 갱신이라면 새 저장 공간이 필요 없으므로 바로 반환합니다. 없을 때에만 새 원소를 포함한 적재율을 계산합니다. size가 실제 서로 다른 정규화 키 수와 일치한다는 불변식이 리사이즈 시점을 정합니다.
get은 버킷의 모든 후보 중 정확히 같은 key를 찾습니다. delete 역시 일치 항목만 지우며, splice가 뒤의 버킷 원소들을 이동시킬 수 있으므로 충돌 체인의 길이를 비용에 포함해야 합니다. 찾지 못한 삭제는 false이며 size를 바꾸지 않습니다.
왜 리사이즈는 복사가 아니라 재배치인가
적재율 (size + 1) / 버킷 수가 0.75를 넘으면 버킷 수를 두 배로 늘립니다. 같은 해시 정수라도 나누는 수가 바뀌면 나머지가 달라집니다. 기존 버킷 배열만 길게 만드는 것으로는 조회 위치가 맞지 않기 때문에 모든 항목을 새 용량으로 다시 분류합니다.
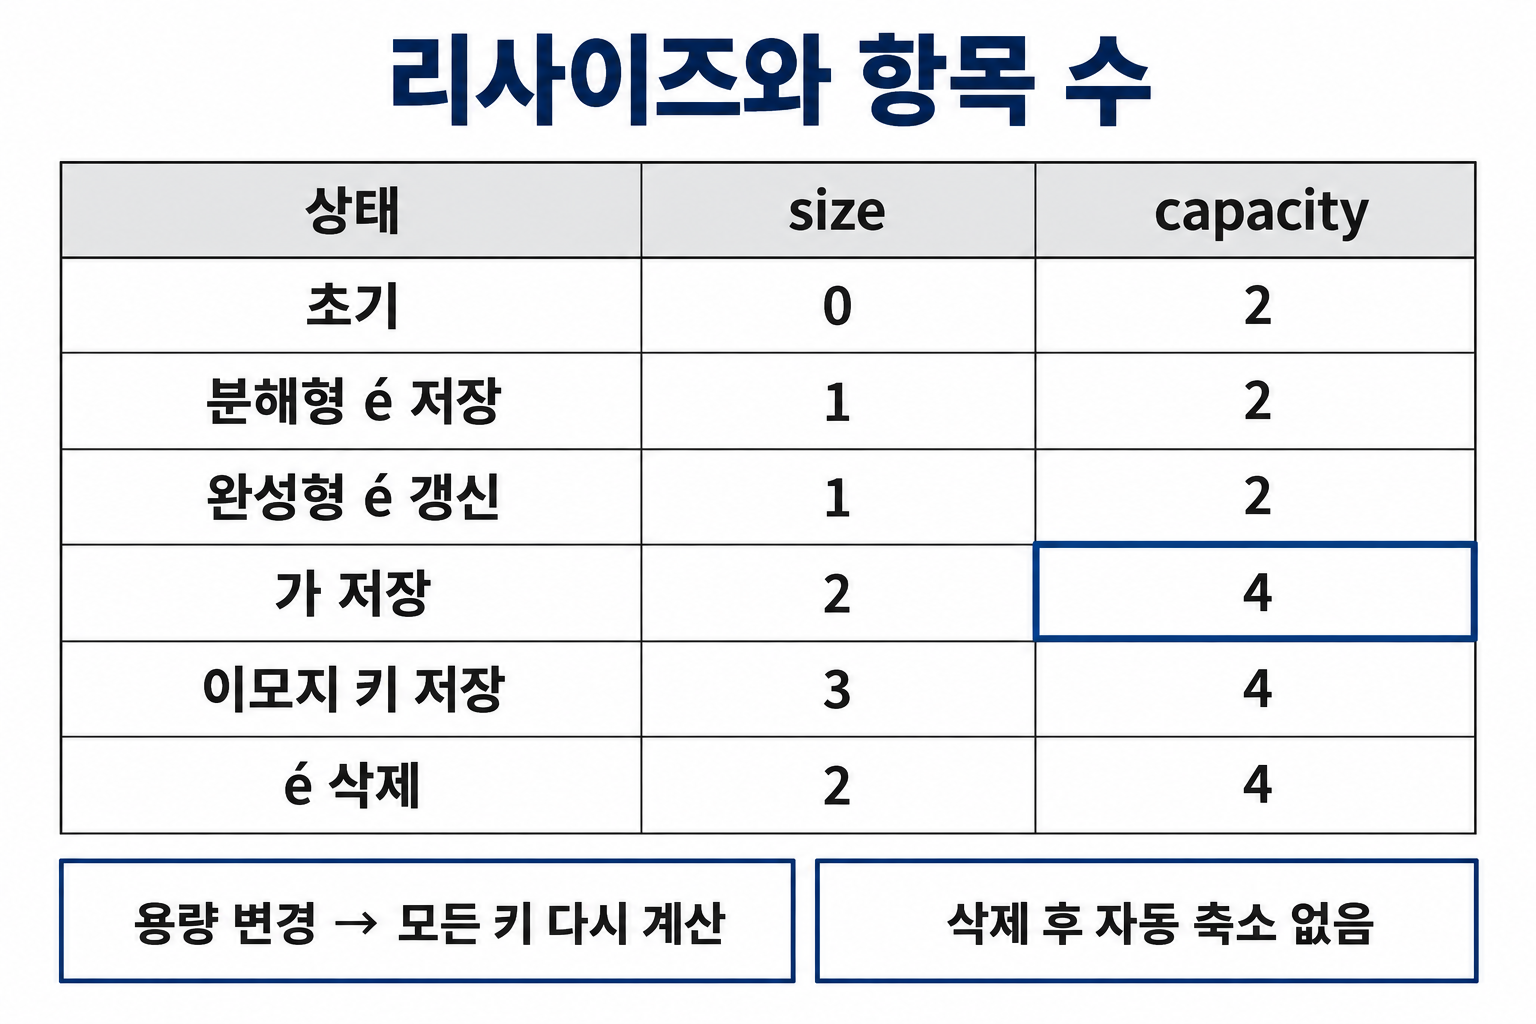
resize는 이미 중복이 제거된 항목을 직접 새 버킷에 넣습니다. set을 다시 호출하지 않으므로 size를 중복 증가시키거나 불필요하게 키를 재정규화하지 않습니다. 재배치 중에도 key와 value는 유지되며, 끝에 buckets 참조만 바꿉니다. 삭제 후에는 축소하지 않는 정책이므로 최고 사용량에 가까운 버킷 메모리가 남을 수 있습니다.
| 작업 | 서로 다른 키 수 | 버킷 수 | 핵심 변화 |
|---|---|---|---|
| 초기 용량 2 | 0 | 2 | 각 버킷은 서로 다른 빈 배열 |
| set(e + 결합 악센트, 1) | 1 | 2 | NFC 키 é 생성 |
| set(é, 2) | 1 | 2 | 같은 키 갱신, 리사이즈 없음 |
| set(가, 3) | 2 | 4 | 예상 적재율 1이므로 재배치 |
| set(🙂, 4) | 3 | 4 | 적재율 0.75 유지 |
| delete(é) | 2 | 4 | 해당 체인에서만 제거, 축소 없음 |
충돌을 눈으로 확인하려면 같은 용량에서 index 결과가 같은 서로 다른 두 문자열을 찾아 set해 보세요. 두 항목은 같은 배열에 나란히 있어야 합니다. 테스트에서는 index를 항상 0을 반환하도록 바꾼 별도 인스턴스로 충돌이 극단적인 경우의 정확성도 검사할 수 있습니다. 이런 조작은 일반 사용 API가 아닙니다.
평균 O(1)을 말하기 위한 조건
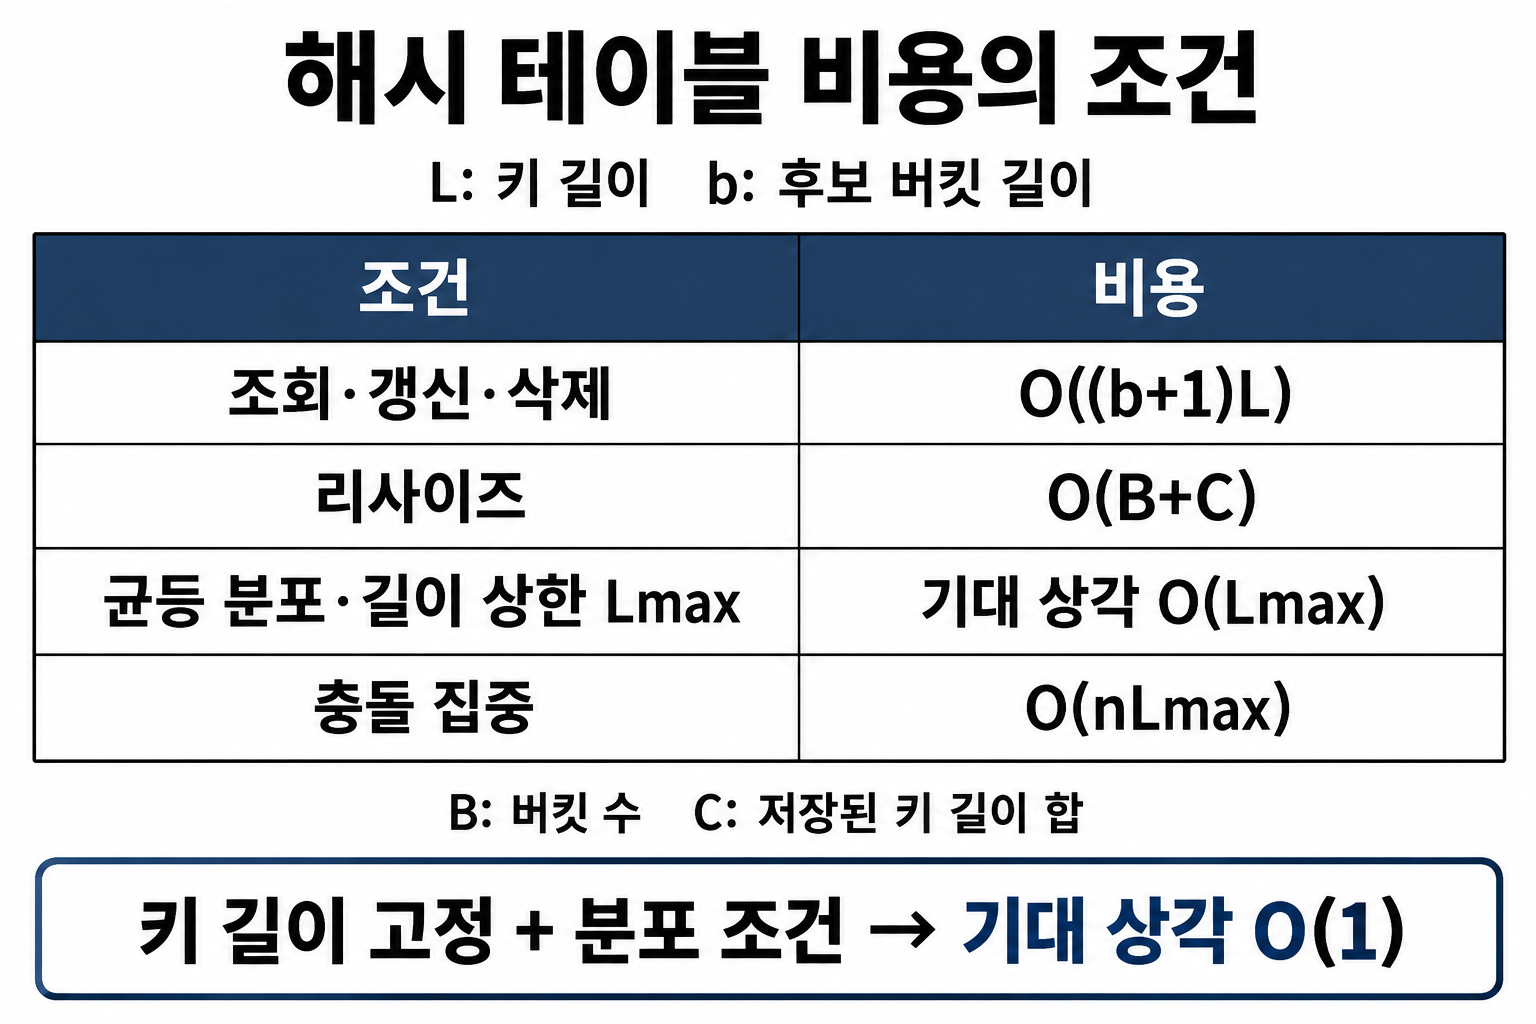
| 작업 | 비용 모델 |
|---|---|
| 정규화·해시 | 길이 L에 비례한다고 가정하는 통상 모델 |
| 리사이즈 없는 조회·갱신·삭제 | 체인 길이 b, 최대 비교 길이 L일 때 O((b+1)L) |
| 리사이즈 1회 | 버킷 B개 초기화 + 저장 키 총길이 C 재해시: O(B+C) |
| 고른 분포와 길이 상한 Lmax를 가정한 연산열 | 기대 상환 O(Lmax), 고정 길이면 O(1) |
| 충돌이 집중된 한 연산 | 최악 O(nL), 길이 상한이 있으면 O(nLmax) |
| 테이블 공간 | O(B+n+C), 값이 참조하는 객체 본체는 별도 |
해시 분포가 고르다는 가정은 공격자가 고른 키에도 보장되는 사실이 아닙니다. 버킷 수가 늘어도 의도적 충돌은 남을 수 있으며, 리사이즈하는 단일 set은 상수 시간이 아닙니다. JavaScript 문자열 정규화의 구체적인 실행 시간 역시 언어 명세가 Big-O로 약속하지 않으므로 표의 문자열 처리 가정을 구분해 읽어야 합니다.
실무에서는 보통 내장 Map을 먼저 사용합니다. 이 구현의 목적은 충돌 처리와 비용 조건을 이해하는 것이며 해시 서비스의 보안성이나 Map보다 빠른 성능을 보장하지 않습니다. 외부 입력에 노출되는 서버라면 입력량 제한과 검증을 별도로 설계해야 합니다.
경계 확인과 연습
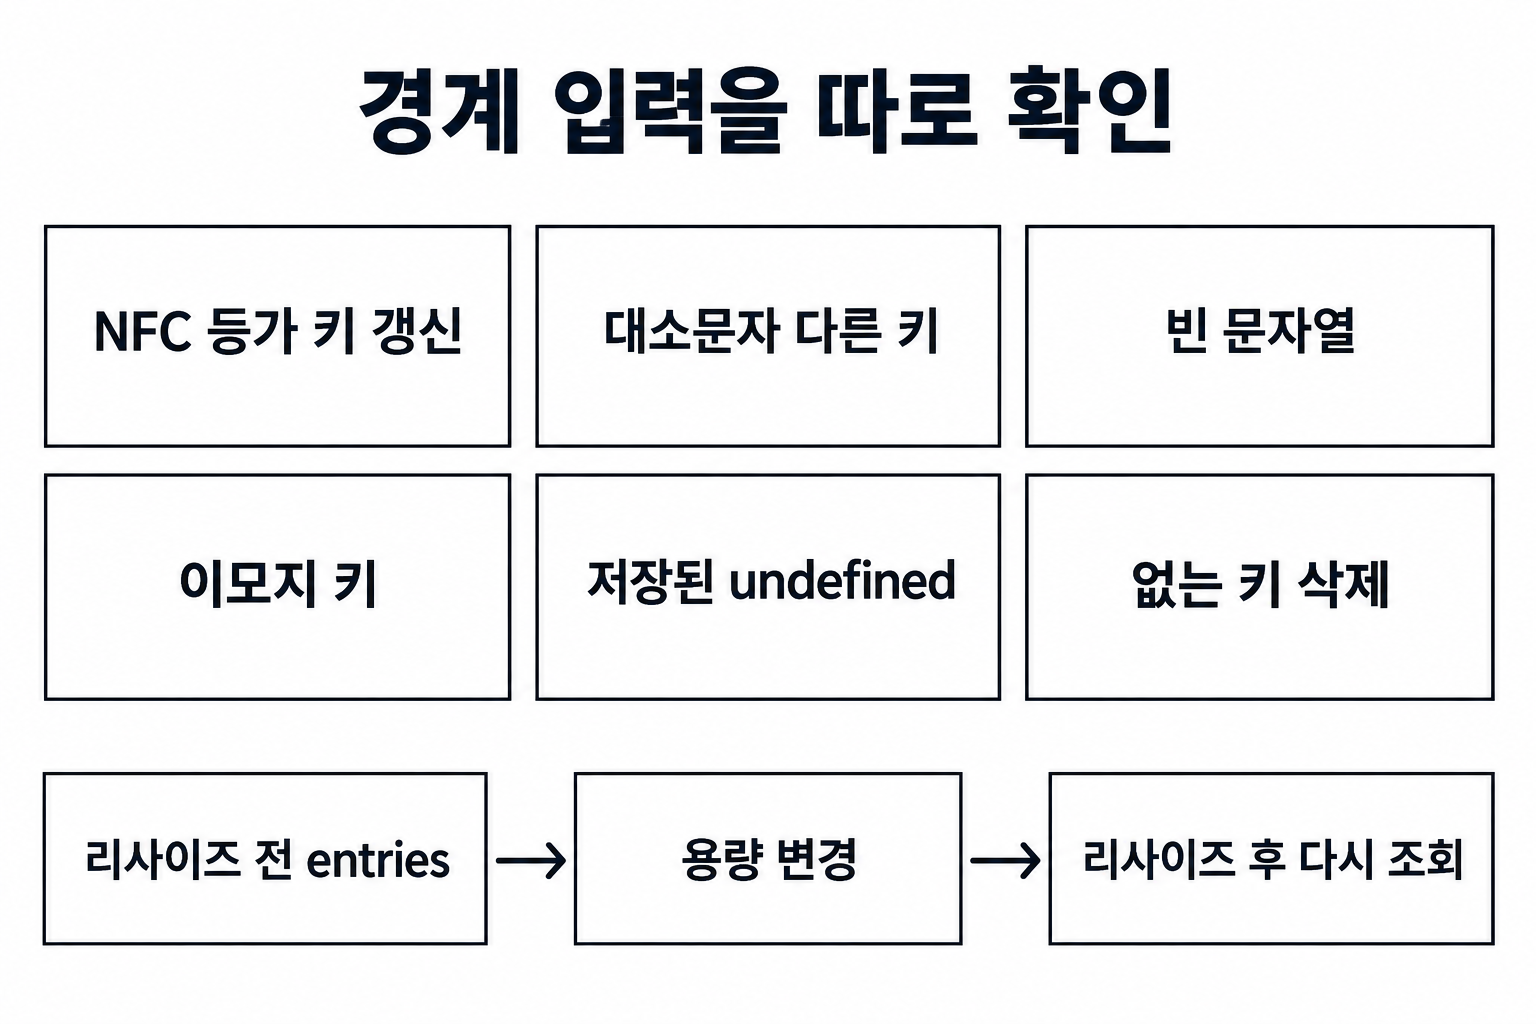
NFC 등가 키의 갱신, 대소문자가 다른 키, 빈 문자열, 이모지, 저장된 undefined, 없는 키 삭제를 확인하세요. 리사이즈 직전과 직후에 모든 entries를 다시 조회하면 나머지 계산을 옛 용량으로 수행하는 오류를 찾기 쉽습니다.
함께 연습하고 확인할 자료
Design HashMap: 정수 키 사전을 구현하는 외부 연습입니다. 이 글의 NFC 문자열 키 정책과는 입력 계약이 다릅니다.
관련 개념 참고: Princeton Algorithms — Hash Tables, MDN — String.prototype.normalize() 공식 자료와 문제 페이지는 2026년 9월 10일 확인했습니다. 외부 문제의 지문·예시를 복제하지 않고 이 글의 예제와 창작 문제를 별도로 구성했습니다.
숫자 나머지 해시와 문자열 갱신 계약을 구분합니다
정수 키를 나머지로 버킷에 배치하는 작은 해시 테이블은 충돌을 배우기 쉽습니다. 용량 10에서 1과 11은 같은 칸에 들어가지만, 버킷 안에서는 원래 키를 비교해 구별해야 합니다. 이 계산을 문자열 키에 그대로 적용하거나 음수 나머지를 곧바로 배열 번호로 쓰면 계약이 깨집니다. 문자열을 받는 현재 구현은 문자열 해시·NFC 정규화 정책을 별도로 가지므로, 숫자 전용 예제와 서로 다른 입력 규칙을 유지해야 합니다.
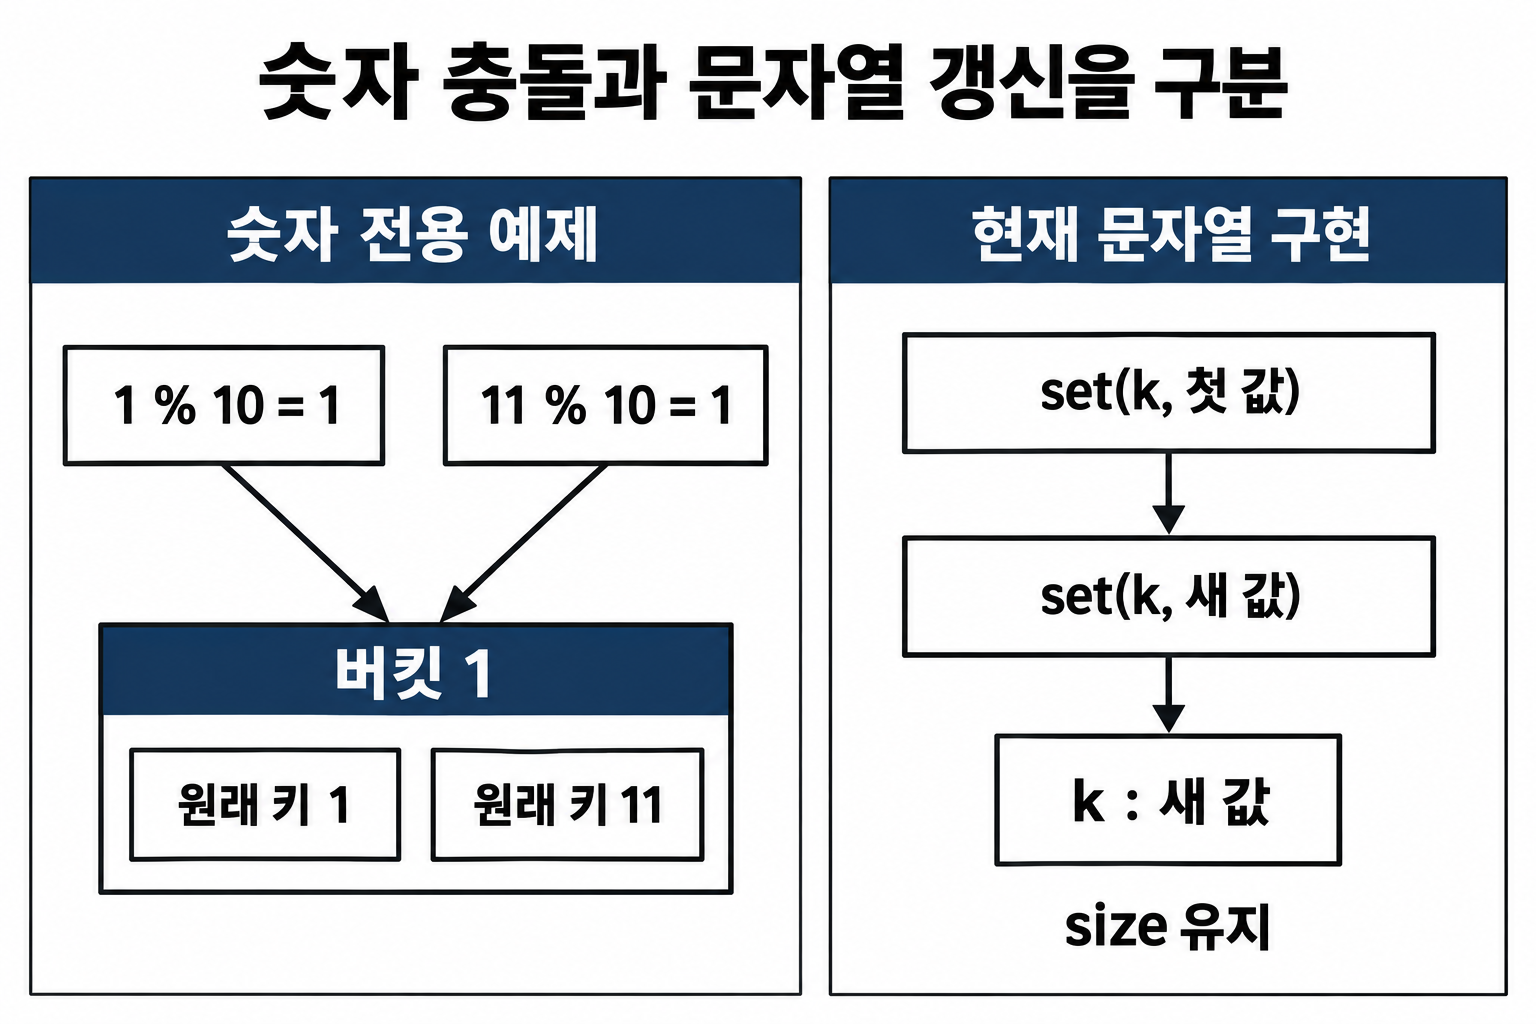
Map처럼 같은 키의 값을 바꾸려면 set(k,첫 값) 뒤 set(k,새 값)이 원소 두 개를 만드는 동작이 되어서는 안 됩니다. 현재 구현은 정규화한 키를 먼저 비교하여 기존 항목의 value만 갱신하고 size를 늘리지 않습니다. 같은 키의 항목을 무조건 버킷 앞에 덧붙이면 조회가 최신 값을 보여도 삭제 한 번 뒤에 옛 값이 다시 나타날 수 있습니다. 현재의 갱신·리사이즈·NFC 정책과 {found,value} 조회 결과를 유지하면, 값이 undefined인 정상 항목과 없는 항목도 구분할 수 있습니다.
첨부 test_hashtable.mjs에서 충돌 후 조회·삭제의 결과를 읽습니다
dev.zip의 dev/test_hashtable.mjs는 이름에 test가 있지만 assert로 통과·실패를 판정하는 자동 테스트가 아닙니다. console.log와 출력용 메서드로 결과를 관찰하는 시연 파일입니다. 아래에서 호출 뒤 남은 상태와 함수가 반환하는 값을 따로 읽어 보세요. 원본은 상대 모듈을 가져오므로 코드 한 조각만 콘솔에 붙이면 독립 실행되지 않습니다.
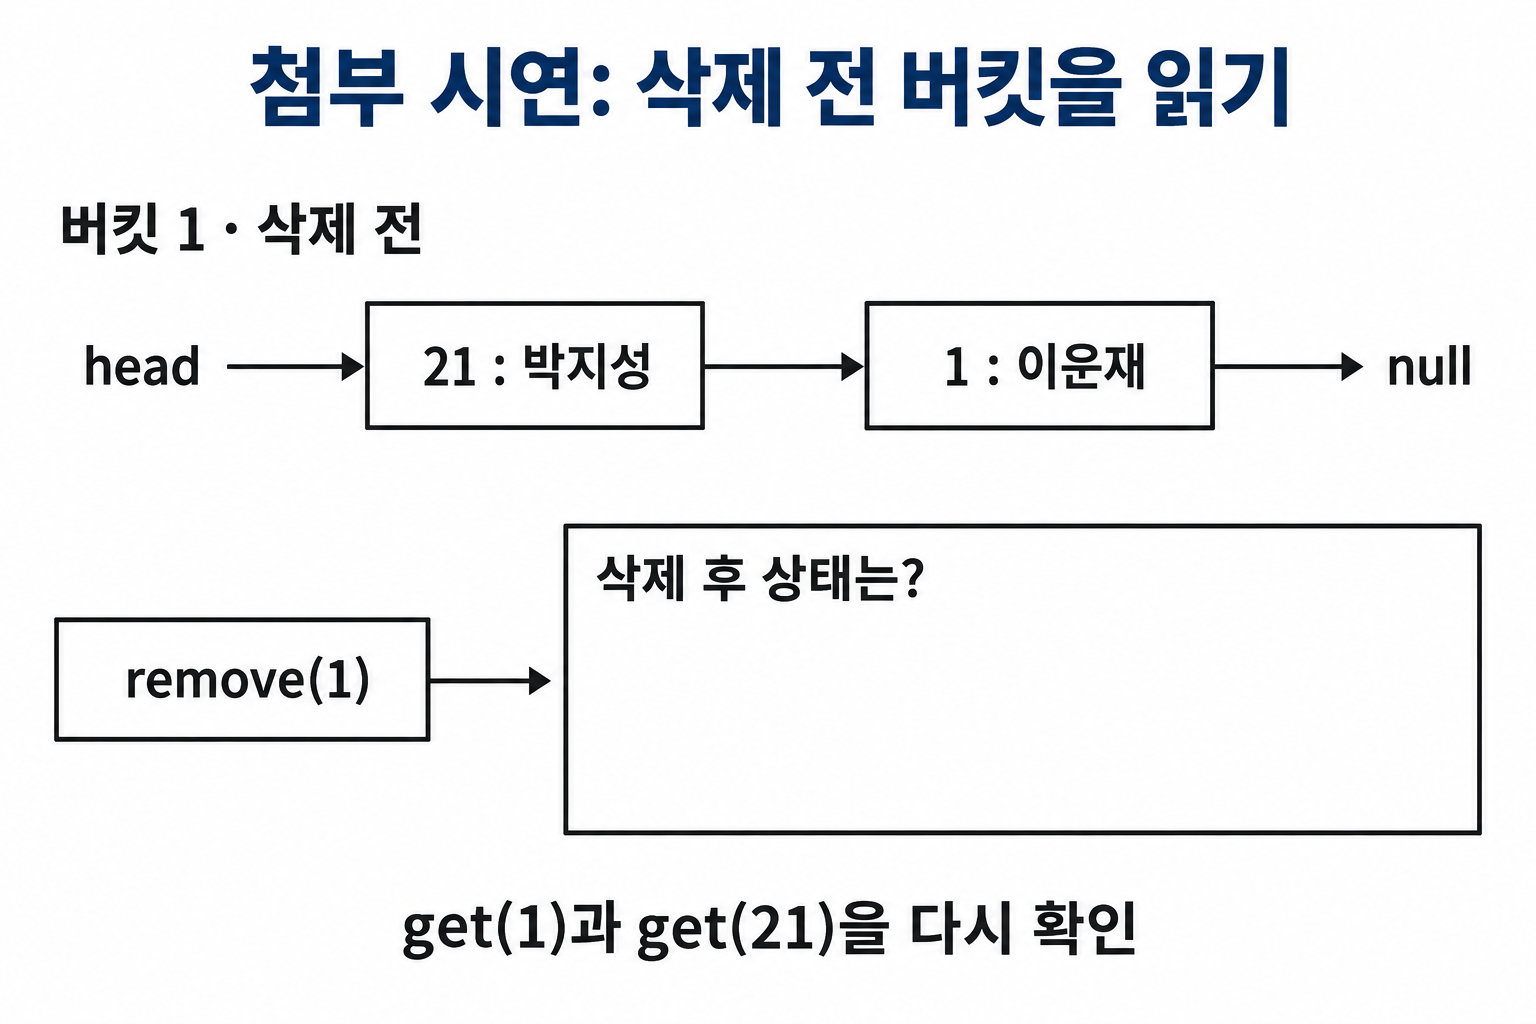
원본은 선수 등번호를 키로 넣고 key % 10을 열 개 버킷의 번호로 사용합니다. 이 시연의 키는 양의 정수이며, 현재 본문의 문자열 해시·NFC 정규화·용량 확장과 다른 구현입니다. 원본에는 문자열 키 정책이나 음수 나머지 보정·입력 범위 검사가 없으므로 임의 문자열까지 지원한다고 확대해서 읽지 않습니다.
| 버킷 | head부터 저장된 key:value | 이 순서가 된 이유 |
|---|---|---|
| 0 | 10:이영표 → 20:홍명보 | 20과 10의 나머지가 같고 새 항목을 버킷 앞에 붙입니다. |
| 1 | 21:박지성 → 1:이운재 | 1 다음에 21을 넣었으므로 get(1)은 첫 노드 21을 지나 다음 노드까지 비교합니다. |
| 4 | 14:이천수 → 4:최진철 | 키가 달라도 나머지가 같아 같은 연결 리스트를 씁니다. |
| 그 밖의 사용 버킷 | 버킷 2=22:송종국, 5=5:김남일, 6=6:유상철, 8=8:최태욱, 9=9:설기현 | 전체 항목은 11개이며 나머지가 같은 경우에도 원래 키를 비교합니다. |
| 호출 | 기대 반환·출력 | 버킷 1의 상태 |
|---|---|---|
| get(1) | 반환 이운재, 출력 1: 이운재 | [21,1] 유지 |
| remove(1) | data가 {key:1,value:이운재}인 Node를 반환하지만 원본은 출력하지 않습니다. | 앞 노드 21은 남고 [21]이 됩니다. 전체 항목 수 11 → 10 |
| 다시 get(1) | 반환 null, 출력 1: null | [21] 유지 |
| get(21) | 반환 박지성, 출력 21: 박지성 | [21] 유지 |
원본 시연의 핵심은 “같은 버킷의 다른 키를 함께 지우지 않는다”입니다. 1과 21의 충돌은 키 비교로 해결합니다. 하지만 같은 키를 두 번 set한 상황은 이 시연에 없습니다. 원본 set은 기존 키를 찾아 갱신하지 않고 새 Node를 앞에 붙입니다. 별도 확인으로 1에 첫 값과 새 값을 넣으면 두 노드가 생기고, get은 새 값을 보지만 remove(1) 한 번 뒤에는 첫 값이 다시 나옵니다. 현재 StringHashTable의 갱신 동작과 다릅니다.
| 동작 | 첨부 HashTable | 현재 StringHashTable |
|---|---|---|
| set | undefined, 같은 키도 새 Node 삽입 | 테이블 자신, 같은 정규화 키는 값 갱신·size 유지 |
| get | 찾은 value 또는 null | {found:true,value} 또는 {found:false} |
| 삭제 | remove는 Node 또는 null | delete는 실제 삭제 여부 boolean |
| 해시·확장 | 숫자 나머지, 버킷 수 10 고정 | 문자열·NFC 정책, 적재율에 따른 재배치 |
원본의 조회 결과 null은 “키 없음” 표시지만 값으로 null을 넣는 상황과 구별하는 found 표시는 없습니다. 현재 글의 {found,value} 계약을 적용하려면 호출 코드도 함께 바꿔야 합니다. 자동 검증에서는 assert로 세 출력, 삭제 후에도 get(21)이 유지되는지, 중복 키의 실제 동작을 각각 확인합니다. 버킷이 길어지면 조회·삭제는 그 길이만큼 탐색하므로 전체 N개가 한 칸에 몰리는 최악은 O(N)입니다.
자기 확인: remove(1) 뒤 get(21)이 계속 박지성인 이유는 무엇인가요?
버킷 번호만 보고 지우지 않고 원래 키 1을 찾은 뒤 그 Node만 제거하기 때문입니다. 버킷 1은 [21,1]에서 [21]이 되며 21의 값은 바뀌지 않습니다.
직접 실습: 연산 비용으로 구조를 설명합니다
실습 주제: JavaScript 문자열 해시 테이블 구현: 충돌 처리와 리사이즈, NFC 정규화
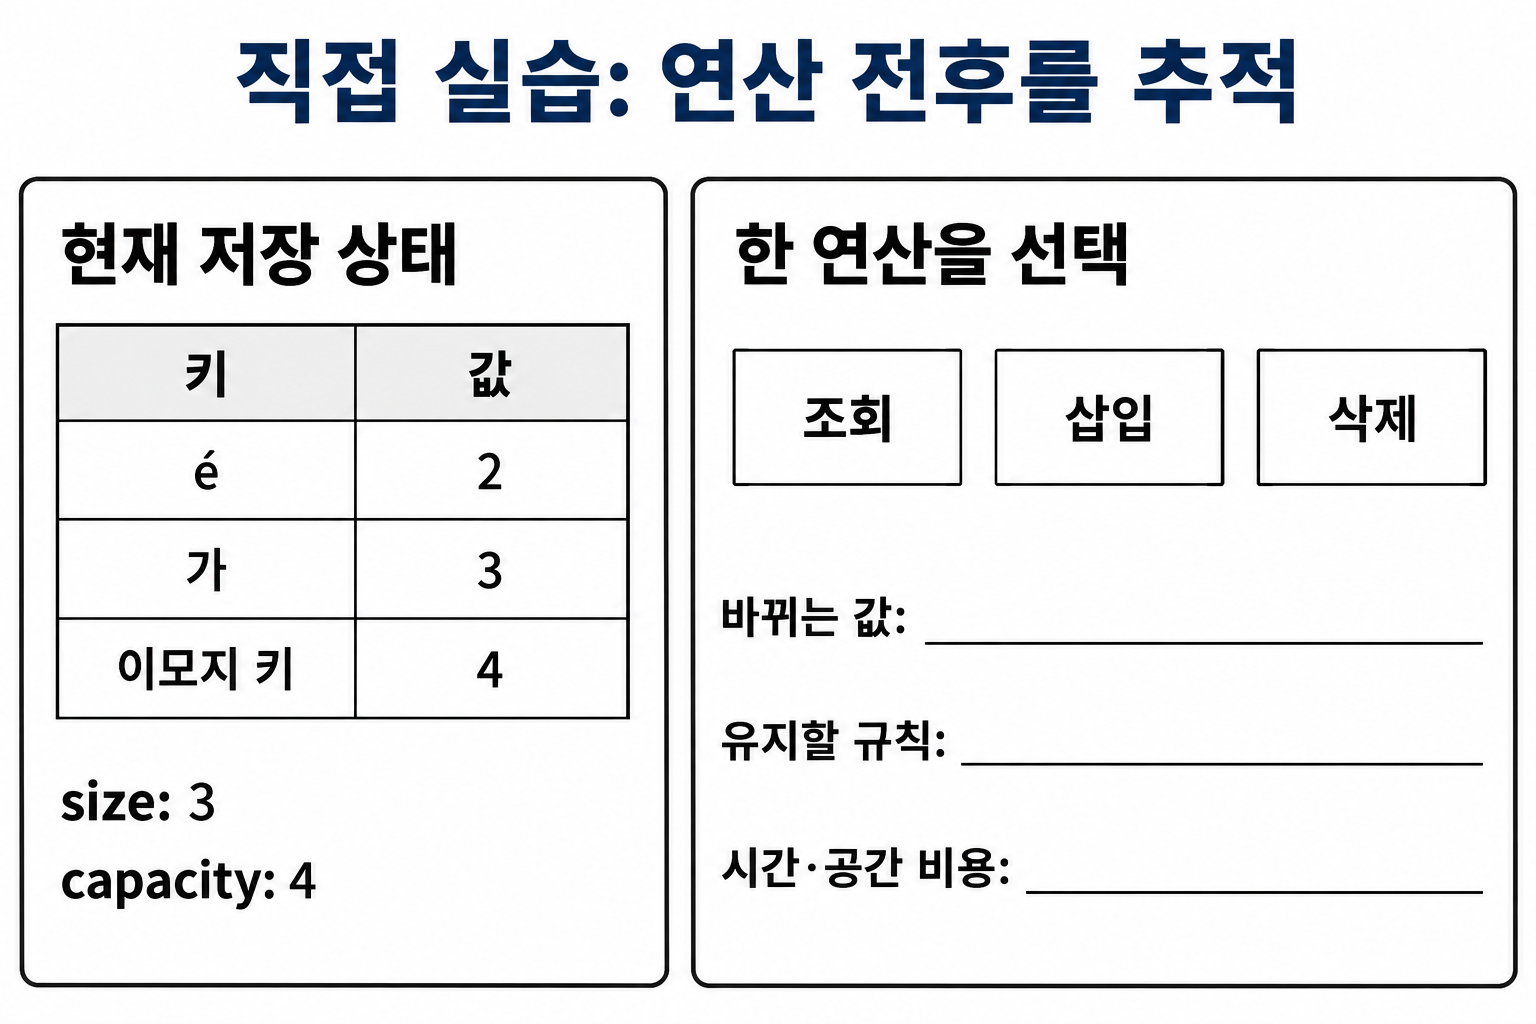
- 본문 구현에서 저장되는 값과 연결 관계를 그림으로 적습니다.
- 조회·삽입·삭제 중 이 구조가 가장 자주 수행할 연산을 고릅니다.
- 연산 전후에도 유지되어야 하는 규칙을 한 문장으로 적습니다.
- 배열이나 Map 같은 다른 구조로 바꿨을 때 시간·공간 비용을 비교합니다.
풀이 기준과 확인 결과
메서드 이름만 외우지 말고 한 번의 연산에서 어떤 값과 연결이 바뀌는지 추적하세요. 빈 구조, 원소 한 개, 중복값, 연속 삽입·삭제를 실행했을 때 본문이 설명한 불변식이 유지되면 성공입니다.
테스트 체크리스트
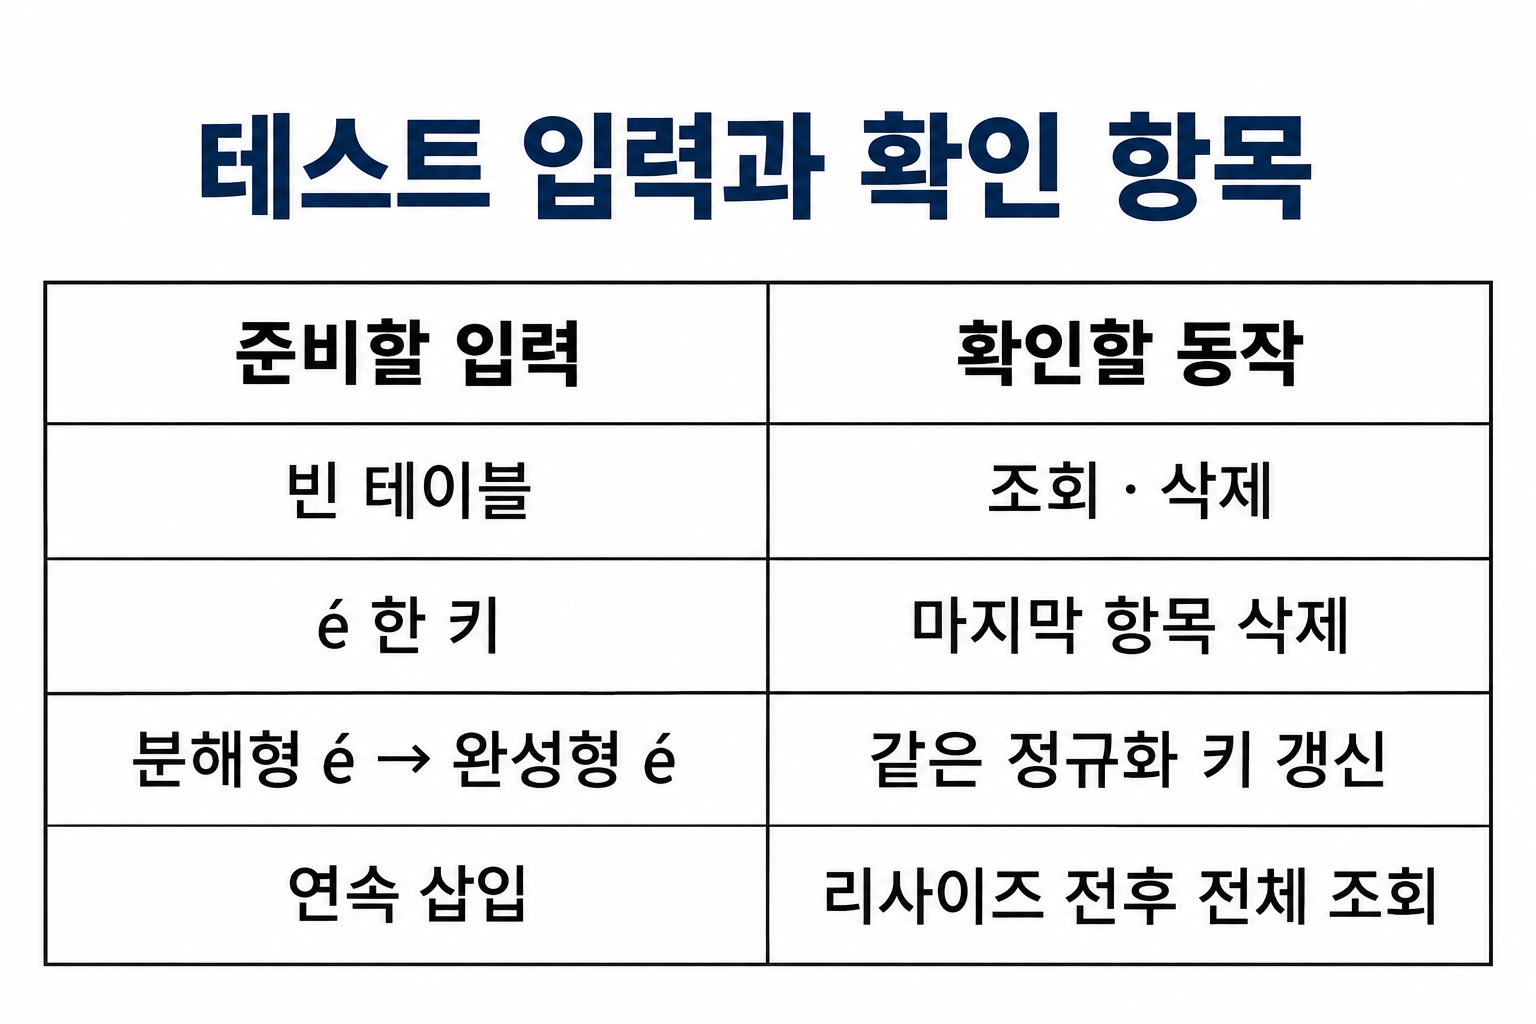
- 빈 구조에 대한 조회·삭제 처리
- 첫 원소와 마지막 원소 변경
- 중복값 또는 동일 우선순위 처리
- 입력 크기가 커졌을 때 예상 복잡도 유지
이 글이 도움이 되었나요?
이어서 공부하기
체크포인트: 예제의 상태 변화를 손으로 추적하고 아래 문제에 적용하세요. 값이 없는 경우와 원소 하나인 경우도 설명해 보세요. 삽입·제거 전후의 상태를 그리고, 내장 도구를 쓰는 풀이와 직접 구현의 목적을 구분하세요.
다음 추천 · 이 개념으로 풀 문제: 해시 테이블 연습: 정규화 문자열 빈도와 등장 순서
권장 순서는 학습 가이드와 같습니다. 다른 순서는 접힌 참고 목록에서 확인할 수 있습니다. 읽음 표시는 숙달이나 채점 결과가 아닙니다.
원래 과정 목록 순서 (선택)
읽음 기록
읽음 — / 전체 23개 · 필수 23개
새 글 받아보기
RSS 리더에서 BlogFlow의 새 글을 확인할 수 있습니다.
