LRU: 방금 사용한 항목을 앞으로, 오래 안 쓴 항목은 밖으로
용량 두 칸의 캐시로 LRU 정책을 배웁니다. Map 조회와 이중 연결 리스트의 위치 이동을 분리해 각 연결을 바꾸는 이유를 설명합니다.
먼저 작은 예제로 원리를 익히고, 마지막에 전체 구현을 펼쳐 보세요. 앞쪽 예제는 각각 독립적으로 브라우저 개발자 도구 Console에서 실행합니다. 같은 이름을 다시 선언했다는 오류가 나오면 새로고침 후 해당 예제를 실행하세요. 출력 뒤에 콘솔이 별도로 보여주는 undefined는 마지막 명령의 반환값일 수 있습니다.
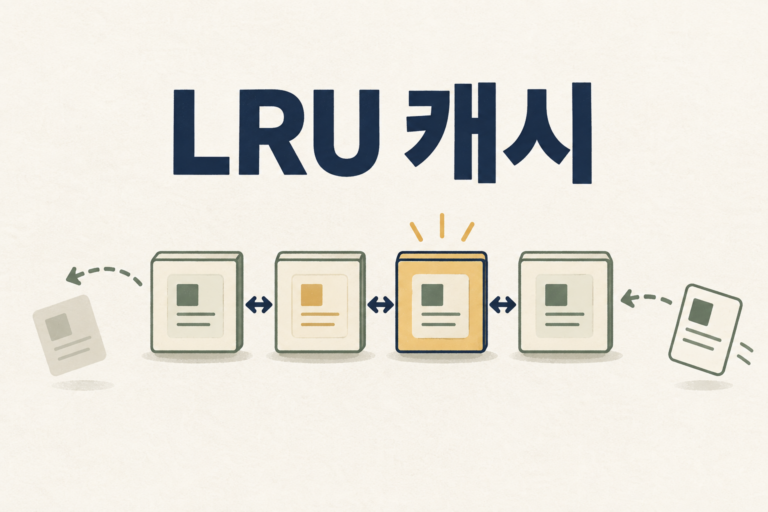
1. 다시 쓸 것 같은 결과를 두 개만 보관합니다
지도 앱에서 방금 본 영역의 데이터를 다시 요청한다고 생각해 보세요. 이미 받은 결과를 잠시 보관하면 같은 일을 반복하지 않아도 됩니다. 이 보관소가 캐시입니다. 그런데 두 개만 담을 수 있다면 새 데이터가 올 때 하나를 버려야 합니다.
LRU는 가장 오랫동안 사용하지 않은 항목을 버리는 규칙입니다. 가장 먼저 저장한 항목과 항상 같은 것은 아닙니다. 예전에 저장했어도 방금 다시 읽었다면 최근 사용한 항목으로 바뀝니다.
| 한 일 | 최근 사용 → 오래 사용하지 않음 | 버린 항목 |
|---|---|---|
| A 저장 | A | 없음 |
| B 저장 | B → A | 없음 |
| A 다시 읽음 | A → B | 없음 |
| C 저장 | C → A | B |
A를 먼저 저장했지만 다시 사용했으므로 C가 들어올 때는 B를 버립니다. 이 표를 설명할 수 있다면 LRU의 규칙은 이해한 것입니다. 다음은 이 순서를 어떻게 코드에 기억할지 살펴봅니다.
2. 값 찾기와 사용 순서 기억은 다른 일입니다
Map을 쓰면 A라는 이름으로 저장한 값을 찾을 수 있습니다. 하지만 Map의 get만 호출한다고 자동으로 LRU 순서가 바뀌지는 않습니다. 아래 코드는 값 조회만 합니다. 이후 순서 갱신을 별도로 붙입니다. 모든 작은 예제는 브라우저 Console에서 독립 실행할 수 있습니다.
const cache = new Map();
cache.set('A', 'A 지역 데이터');
cache.set('B', 'B 지역 데이터');
console.log(cache.get('A'));
console.log(cache.get('C'));
console.log(Array.from(cache.keys()).join(', '));
A 지역 데이터
undefined
A, Bget(‘A’)는 저장한 값을 반환하고, 없는 C에는 undefined를 반환합니다. 마지막 줄은 Map의 삽입 순서를 보여 줍니다. A를 읽었어도 A, B 그대로입니다. 따라서 Map 조회 결과와 “최근에 무엇을 썼는가”라는 정보는 구분해야 합니다.
3. 배열로 규칙만 먼저 흉내 내 봅니다
recent 배열의 맨 앞을 가장 최근 사용한 항목으로 정하겠습니다. 현재 B → A이고 A를 읽었다면 A를 기존 자리에서 빼고 맨 앞으로 옮깁니다. 그다음 C를 넣으면 맨 뒤 B를 제거합니다.
let recent = ['B', 'A'];
recent = recent.filter(key => key !== 'A');
recent.unshift('A');
console.log(recent.join(', '));
recent.unshift('C');
const removed = recent.pop();
console.log(recent.join(', '));
console.log(removed);
A, B
C, A
Bfilter는 A가 아닌 항목만 남기는 새 배열을 만듭니다. 기존 A를 지운 뒤 unshift로 A를 맨 앞에 넣습니다. 지우지 않고 넣기만 하면 같은 A가 두 번 남습니다. C를 추가할 때는 용량 2를 넘으므로 pop으로 맨 뒤 하나를 뺍니다.
이 코드는 고정된 요청을 손으로 따라가는 실습이며 범용 캐시 함수가 아닙니다. 배열 방식으로 규칙은 구현할 수 있지만 중간에서 A를 찾고 빼려면 여러 값을 살펴볼 수 있습니다. 그래서 아래 전체 구현은 Map으로 항목을 바로 찾고, 연결 리스트로 그 항목의 위치를 옮기는 방식을 사용합니다.
확인 문제: 현재 최근 순서가 C → A인데 A의 값을 새 값으로 바꿨습니다. C를 버려야 할까요?
정답과 이유 보기
아닙니다. A는 이미 있는 항목이므로 새 칸이 필요하지 않습니다. A의 값만 바꾸고 최근 위치로 옮기면 A → C가 됩니다. 새 키 추가와 기존 키 갱신을 구분해야 불필요하게 다른 항목을 버리지 않습니다.
4. 양쪽 연결을 알면 중간 항목만 뺄 수 있습니다
단방향 연결 리스트는 다음 항목만 알았습니다. 이중 연결 리스트는 prev에 이전 항목, next에 다음 항목을 저장합니다. X ↔ A ↔ Y에서 A를 빼려면 X의 다음을 Y로, Y의 이전을 X로 바꿉니다. 나머지 항목 전체를 옮길 필요는 없습니다.
| 바꿀 곳 | 바꾸기 전 | 바꾼 후 |
|---|---|---|
| X.next | A | Y |
| Y.prev | A | X |
| A.prev / A.next | X / Y | 연결 정리 후 null / null |
const x = { key: 'X', prev: null, next: null };
const a = { key: 'A', prev: x, next: null };
const y = { key: 'Y', prev: a, next: null };
x.next = a;
a.next = y;
a.prev.next = a.next;
a.next.prev = a.prev;
a.prev = null;
a.next = null;
console.log(x.next.key);
console.log(y.prev.key);
Y
Xa.prev.next는 “A의 이전 항목 X에 있는 next”입니다. 여기에 A의 다음 항목 Y를 넣습니다. 반대쪽도 이어 준 다음 A 자신의 prev와 next를 비웁니다. A의 연결부터 null로 만들면 X와 Y를 찾아갈 정보를 잃으므로 순서가 중요합니다.
5. 최근 위치에 붙이는 네 줄을 따라갑니다
리스트 맨 앞에는 데이터를 담지 않는 시작 표시 head를 둡니다. 이 표시를 쓰면 실제 항목이 0개인 경우에도 ‘head 바로 뒤에 붙인다’는 규칙을 사용할 수 있습니다. 마지막 표시 tail도 둡니다. 빈 상태는 head ↔ tail입니다.
head ↔ B ↔ tail 앞에 A를 붙일 때를 보겠습니다. A가 기존 첫 항목 B를 먼저 기억하게 한 다음, B의 이전을 A로 바꾸고, 마지막으로 head의 다음을 A로 바꿉니다.
const head = { next: null };
const tail = { prev: null };
const b = { key: 'B', prev: head, next: tail };
head.next = b;
tail.prev = b;
const a = { key: 'A', prev: null, next: null };
a.prev = head;
a.next = head.next;
head.next.prev = a;
head.next = a;
console.log(head.next.key);
console.log(head.next.next.key);
console.log(b.prev.key);
A
B
Aa.next = head.next를 실행하는 시점에 head.next는 아직 B입니다. head.next = a를 먼저 해 버리면 원래 첫 항목 B를 읽을 수 없고, 잘못하면 A가 자신을 가리키게 됩니다. 연결 순서는 외울 네 줄이 아니라 “옛 이웃 정보를 잃기 전에 새 연결을 만든다”는 이유에서 나옵니다.
6. Map과 리스트는 같은 항목을 가리켜야 합니다
전체 구현에서는 Map의 값에 데이터만 넣는 대신 해당 노드 객체를 넣습니다. 그러면 get(‘A’)로 A 노드를 바로 찾고, detach로 현재 자리에서 뺀 다음 attachFront로 head 뒤에 붙일 수 있습니다. 마지막으로 node.value를 반환합니다. 조회와 순서 갱신이 한 요청 안에서 함께 일어납니다.
| 요청 | Map에서 할 일 | 리스트에서 할 일 |
|---|---|---|
| 이미 있는 A 읽기 | A 노드 찾기 | 그 노드를 빼서 맨 앞으로 |
| 이미 있는 A 갱신 | 같은 노드의 값 바꾸기 | 그 노드를 맨 앞으로 |
| 용량 초과로 B 퇴출 | B 키 삭제 | B 노드를 연결에서 제거 |
| 새 C 추가 | C 키에 새 노드 저장 | 새 노드를 맨 앞에 연결 |
리스트에서만 B를 지우면 Map으로 B를 여전히 찾게 됩니다. Map에서만 지우면 순서 목록에 유령 항목이 남습니다. 두 구조를 함께 고쳐야 “저장된 항목”과 “사용 순서”가 일치합니다. 이처럼 계속 지켜야 하는 상태의 약속을 불변식이라고 부릅니다.
아래 전체 코드는 방금 본 detach와 attachFront를 먼저 읽고, get과 put이 이 둘을 언제 호출하는지 확인하세요. keys는 관찰용 전체 목록이라 모든 항목을 읽습니다. get·put이 짧은 연결 변경으로 동작한다는 이유로 keys까지 같은 비용이라고 생각하면 안 됩니다. 만료 시간, 비동기 요청 중복 방지, 실제 이미지 메모리 해제는 이번 LRU의 범위가 아닙니다.
관련 코딩테스트 문제로 이어서 연습합니다
이 자료구조의 블로그 연습 문제와 해설에서 배운 동작을 적용해 보세요. 먼저 작은 예시를 직접 처리한 뒤 입력 전체를 다루는 코드로 확장하면 됩니다. 아래 전체 구현은 연결된 문제의 기존 메서드와 반환 형식을 유지합니다.
전체 구현 · 상세 설명 · 예외와 성능 분석 펼치기
여기부터는 필요한 기능을 골라 읽는 참고 영역입니다. 새로운 파일로 전체 코드를 실행할 때는 아래 Node.js 실행 안내를 따르세요. 앞쪽의 작은 브라우저 실습과 전체 파일을 한 콘솔에 이어 붙이지 마세요. 기능별 입력 조건과 반환 형식은 아래 설명을 기준으로 합니다.
문제 상황과 API 계약
작은 지도 앱에서 최근 읽은 타일만 메모리에 남긴다고 합시다. 캐시가 가득 차면 가장 오래 사용하지 않은 항목을 버려야 합니다. 배열로 최근 사용 순서를 유지하면 중간 항목을 찾아 맨 앞으로 옮길 때 O(c)가 걸립니다. Map으로 노드를 바로 찾고 연결 리스트에서 이웃 포인터만 고치면 위치 이동에 필요한 탐색을 없앨 수 있습니다.
get(key)는 값을 반환하면서 해당 항목을 가장 최근 위치로 옮깁니다. 누락은 undefined이며 이 값은 저장할 수 없도록 예약했습니다. put(key,value)는 삽입 또는 교체이고 둘 다 최근 사용으로 취급합니다. keys()는 가장 최근부터 가장 오래된 순서의 스냅샷 배열을 반환합니다. get은 데이터를 읽는 듯 보여도 내부 순서를 변경합니다.
capacity는 항목 수 기준 0~1,000,000 정수입니다. 0이면 put은 아무것도 저장하지 않습니다. Map 키는 JavaScript Map의 동등성 규칙을 따르며 객체 키는 내용이 아니라 참조로 구분합니다. 예제와 창작 문제는 문자열 키를 써 이 차이를 피하지만 범용 클래스의 계약은 알아 두어야 합니다.
정확성을 지키는 불변식
head와 tail은 실제 데이터를 담지 않는 센티널입니다. head.next가 MRU, tail.prev가 LRU입니다. 비었을 때 head.next===tail, tail.prev===head입니다. 실제 노드마다 node.prev.next===node, node.next.prev===node가 유지되어야 어느 위치든 같은 두 줄로 제거할 수 있습니다.
Map의 각 값은 리스트에 정확히 한 번 등장하는 같은 노드 객체입니다. 리스트에서만 퇴출하면 Map에 오래된 항목이 남고, Map에서만 지우면 리스트 길이가 용량을 넘습니다. 따라서 퇴출은 detach와 map.delete를 같이 수행합니다.
기존 키를 put할 때 새 노드를 만들지 않습니다. old.value만 바꾸고 노드의 위치를 앞쪽으로 옮깁니다. 새로운 키를 넣을 때 가득 차 있으면 tail.prev를 먼저 퇴출한 뒤 새 노드를 넣습니다. 이렇게 동일 키 교체가 불필요한 다른 항목 퇴출을 일으키지 않습니다.
전체 구현과 실행
Node.js 24의 CommonJS 환경을 기준으로 합니다. 아래 전체 코드를 lru.cjs로 저장하고 파일이 있는 폴더에서 node lru.cjs를 실행하세요. 외부 패키지는 필요하지 않습니다. module.exports는 다른 파일에서 가져올 때 사용하며 require.main 조건 안의 호출은 직접 실행할 때만 작동합니다.
class LRUCache {
  constructor(capacity) {
    if (!Number.isInteger(capacity) || capacity < 0 || capacity > 1_000_000) {
      throw new RangeError('용량은 0~1,000,000 정수여야 합니다.');
    }
    this.capacity = capacity;
    this.map = new Map();
    this.head = { prev: null, next: null };
    this.tail = { prev: this.head, next: null };
    this.head.next = this.tail;
  }
  detach(node) {
    node.prev.next = node.next;
    node.next.prev = node.prev;
    node.prev = null;
    node.next = null;
  }
  attachFront(node) {
    node.prev = this.head;
    node.next = this.head.next;
    this.head.next.prev = node;
    this.head.next = node;
  }
  get(key) {
    const node = this.map.get(key);
    if (!node) return undefined;
    this.detach(node);
    this.attachFront(node);
    return node.value;
  }
  put(key, value) {
    if (value === undefined) throw new TypeError('undefined는 누락 표시로 예약합니다.');
    if (this.capacity === 0) return;
    const old = this.map.get(key);
    if (old) {
      old.value = value;
      this.detach(old);
      this.attachFront(old);
      return;
    }
    if (this.map.size === this.capacity) {
      const victim = this.tail.prev;
      this.detach(victim);
      this.map.delete(victim.key);
    }
    const node = { key, value, prev: null, next: null };
    this.map.set(key, node);
    this.attachFront(node);
  }
  keys() {
    const result = [];
    for (let node = this.head.next; node !== this.tail; node = node.next) result.push(node.key);
    return result;
  }
}

module.exports = { LRUCache };

if (require.main === module) {
  const c = new LRUCache(2);
  c.put('a', 1);
  c.put('b', 2);
  c.get('a');
  c.put('c', 3);
  console.log(JSON.stringify(c.keys()));
  console.log(c.get('b'));
}
직접 실행 출력:
["c","a"]
undefined
detach는 먼저 양쪽 이웃을 서로 연결한 다음 자신의 prev,next를 null로 만듭니다. attachFront는 head 바로 뒤의 네 참조를 이어 붙입니다. 센티널 덕분에 노드가 처음·중간·마지막인 경우를 나누지 않습니다. 이 두 메서드는 내부용이며 센티널이나 연결되지 않은 외부 객체를 전달하지 않습니다.
get에서 this.map.get(key)가 반환하는 값은 저장 payload가 아니라 노드입니다. 값 0이나 false를 저장해도 노드 객체는 존재하므로 정상 조회됩니다. undefined는 miss와 충돌하므로 put 초입에서 거부합니다.
예제의 출력 keys는 ["c","a"]이고 b 조회는 undefined입니다. keys 자체는 모든 노드를 훑는 O(c) 진단용 스냅샷입니다. 이를 매 요청마다 호출하면서 “캐시 요청 전체 O(1)”이라고 주장하면 반환 목록 생성 비용을 빠뜨리게 됩니다.
상태 변화 따라가기
| capacity=2 작업 | MRU → LRU | 반환 | 이유 |
|---|---|---|---|
| put("a",1) | a | — | 빈 캐시에 추가 |
| put("b",2) | b → a | — | 새 항목이 최근 |
| get("a") | a → b | 1 | 조회도 순서 갱신 |
| put("c",3) | c → a | — | 가장 오래된 b 퇴출 |
| get("b") | c → a | undefined | 누락은 순서 불변 |
| put("a",9) | a → c | — | a 노드 재사용, 크기 2 유지 |
복잡도와 적용하지 말아야 할 경우
| 작업 | 통상적 시간 | 최악 / 공간 조건 |
|---|---|---|
| get / put | 기대·상환 O(1) | Map 해시 조회·삽입의 기대 모델; 명세가 최악 O(1)을 보장하지 않음 |
| detach / attachFront | 최악 O(1) | 노드 참조가 이미 주어진 포인터 조작 |
| keys | 최악 O(c) | 반환 스냅샷도 O(c) 공간 |
| 보유 구조 | O(c+1) | 값의 실제 바이트 크기는 별도 |
Map 명세는 평균적으로 원소 수에 대해 선형보다 나은 접근을 요구하지만 특정 해시 구현이나 최악 O(1)을 보장하지 않습니다. 해시 테이블 모델에서는 조회는 기대 O(1), 재할당을 포함한 삽입은 보통 기대 상환 O(1)로 설명합니다. 해시 충돌이나 재할당이 있는 한 연산을 무조건 상수 시간이라고 단정하지 마세요.
퇴출된 노드는 Map과 리스트 양쪽에서 끊어 외부 참조가 없다면 가비지 컬렉션 대상이 됩니다. 실제 메모리가 바로 줄어드는 시점은 GC가 정합니다. value를 바꿀 때 옛 payload 참조는 캐시에서 떨어지지만 다른 곳이 참조하면 계속 남습니다. c개 객체라고 c바이트가 아니므로 대형 이미지 캐시에는 바이트 예산과 해제 정책이 따로 필요합니다.
TTL 만료, 동시 비동기 요청 중복 제거, 영속 저장, 스레드 안전성, 자원 dispose는 없습니다. 만료 시간 기준 퇴출이나 전체 항목의 단순 FIFO가 요구되는 상황에 LRU를 그대로 적용하면 정책 자체가 틀립니다. Map의 삽입 순서를 이용한 짧은 LRU도 가능하지만 이번 구현은 순서와 조회를 분리해 포인터 불변식을 학습하기 위한 선택입니다.
연습으로 확인하기
타일 요청마다 이미 캐시에 있었는지를 기록하고 마지막 사용 순서를 반환해 보세요. 같은 타일을 연속 요청하거나 용량을 0으로 바꿔도 정책을 일관되게 적용해야 합니다.
LeetCode 146 – LRU Cache — LRU 조회와 갱신을 연습하는 공식 문제입니다. 해당 문제의 누락 반환값과 용량 제약은 이 글의 undefined·용량 0 계약과 다릅니다.
공식 자료
공식 자료 확인일: 2026년 9월 10일. 구현은 이 글의 JavaScript 계약에 맞춰 독립적으로 작성했습니다. 다른 언어 라이브러리의 API와 숫자 범위가 그대로 적용되는 것은 아닙니다.
직접 실습: 연산 비용으로 구조를 설명합니다
실습 주제: JavaScript LRU 캐시: Map과 이중 연결 리스트의 불변식
- 본문 구현에서 저장되는 값과 연결 관계를 그림으로 적습니다.
- 조회·삽입·삭제 중 이 구조가 가장 자주 수행할 연산을 고릅니다.
- 연산 전후에도 유지되어야 하는 규칙을 한 문장으로 적습니다.
- 배열이나 Map 같은 다른 구조로 바꿨을 때 시간·공간 비용을 비교합니다.
풀이 기준과 확인 결과
메서드 이름만 외우지 말고 한 번의 연산에서 어떤 값과 연결이 바뀌는지 추적하세요. 빈 구조, 원소 한 개, 중복값, 연속 삽입·삭제를 실행했을 때 본문이 설명한 불변식이 유지되면 성공입니다.
테스트 체크리스트
- 빈 구조에 대한 조회·삭제 처리
- 첫 원소와 마지막 원소 변경
- 중복값 또는 동일 우선순위 처리
- 입력 크기가 커졌을 때 예상 복잡도 유지
이 글이 도움이 되었나요?
자료구조 학습 순서
필수 18개 · 전체 18개
읽음 기록 관리
전체 과정 목차 (18개)
- 필수 학습 · 자료구조 선택 가이드: 연산 비용으로 배열·스택·큐·Set 고르기
- 필수 학습 · JavaScript 배열: 인덱스 조회와 삽입·삭제 비용
- 필수 학습 · JavaScript Map·Set: 값 조회와 중복 제거 실습
- 필수 학습 · 자료구조 스택 쉽게 이해하기: push pop으로 문제 풀이 감 잡기
- 필수 학습 · 큐와 FIFO: head 인덱스로 JavaScript 대기열 만들기
- 필수 학습 · 단방향 연결 리스트: head·tail 삽입과 삭제
- 필수 학습 · JavaScript 원형 덱 구현: 양끝 삽입·삭제와 고정 용량 버퍼
- 필수 학습 · JavaScript 문자열 해시 테이블 구현: 충돌 처리와 리사이즈, NFC 정규화
- 필수 학습 · 트리 자료구조 차이: 이진 트리 BST MST 구분하기
- 필수 학습 · JavaScript 이진 탐색 트리 구현: 중복 키와 세 가지 삭제 처리
- 필수 학습 · JavaScript 최소 힙 구현: 우선순위 큐의 push·pop과 비교 함수
- 필수 학습 · JavaScript 그래프 구현: 인접 리스트·인접 행렬 비교와 BFS
- 필수 학습 · JavaScript Union-Find: 경로 압축과 크기 합치기로 연결 상태 관리하기
- 필수 학습 · JavaScript Trie: Unicode 접두사 검색과 안전한 삭제 구현
- 필수 학습 · JavaScript Fenwick Tree: lowbit로 구간 합과 단일 증가 갱신 구현
- 필수 학습 · JavaScript 반복형 세그먼트 트리: 구간 합·단일 대입·결합 순서
- 필수 학습 · JavaScript LRU 캐시: Map과 이중 연결 리스트의 불변식 현재 글
- 필수 학습 · JavaScript AVL 트리: 높이 불변식과 LL·RR·LR·RL 삽입 회전
새 글 받아보기
RSS 리더에서 BlogFlow의 새 글을 확인할 수 있습니다.